
发现却无视:LLM Agent 为何缺乏“环境好奇心”?
Agents Explore but Agents Ignore: LLMs Lack Environmental Curiosity
本文提出了“环境好奇心”(Environmental Curiosity)这一概念,并开发了“解法注入”(Solution Injection)评估方法。通过在 Terminal-Bench、SWE-Bench 和 AppWorld 三个基准测试中注入显而易见的任务答案,研究发现当前的 LLM Agent 虽然能以极高概率(79%-98%)发现这些信息,却极少(常低于 7%)与之交互。
TL;DR
如果我们在 Agent 的执行目录里直接放一个名为 solution.sh 的文件,并告诉它“运行即通关”,它会照做吗?Cohere 研究团队的最新论文给出了一个令人沮丧的答案:大部分时候,Agent 会看见它,然后彻底忽略它。 这种“视而不见”的现象揭示了当前 Agent 架构的一个本质缺陷——缺乏环境好奇心(Environmental Curiosity)。
背景定位:Agent 是在思考,还是在背书?
当前的 Agent 评估指标(如 Pass@k)大多是结果导向的。只要最后把题做对了,我们就认为它很聪明。但本文指出,这种评价方式掩盖了一个事实:Agent 往往是在执行某种预设的、僵化的模式(Pattern),而不是根据环境的反馈动态调整策略。
核心实验:解法注入(Solution Injection)
为了量化这种“好奇心缺失”,作者在三个主流基准测试(Terminal-Bench, SWE-Bench, AppWorld)中进行了“投喂”:
- 手段:直接在环境中注入包含完整答案的文件或 API。
- 指标:
- discovery@k:Agent 的上下文里是否出现了这个解法?
- interaction@k:Agent 是否真的去读取、运行或调用了这个解法?
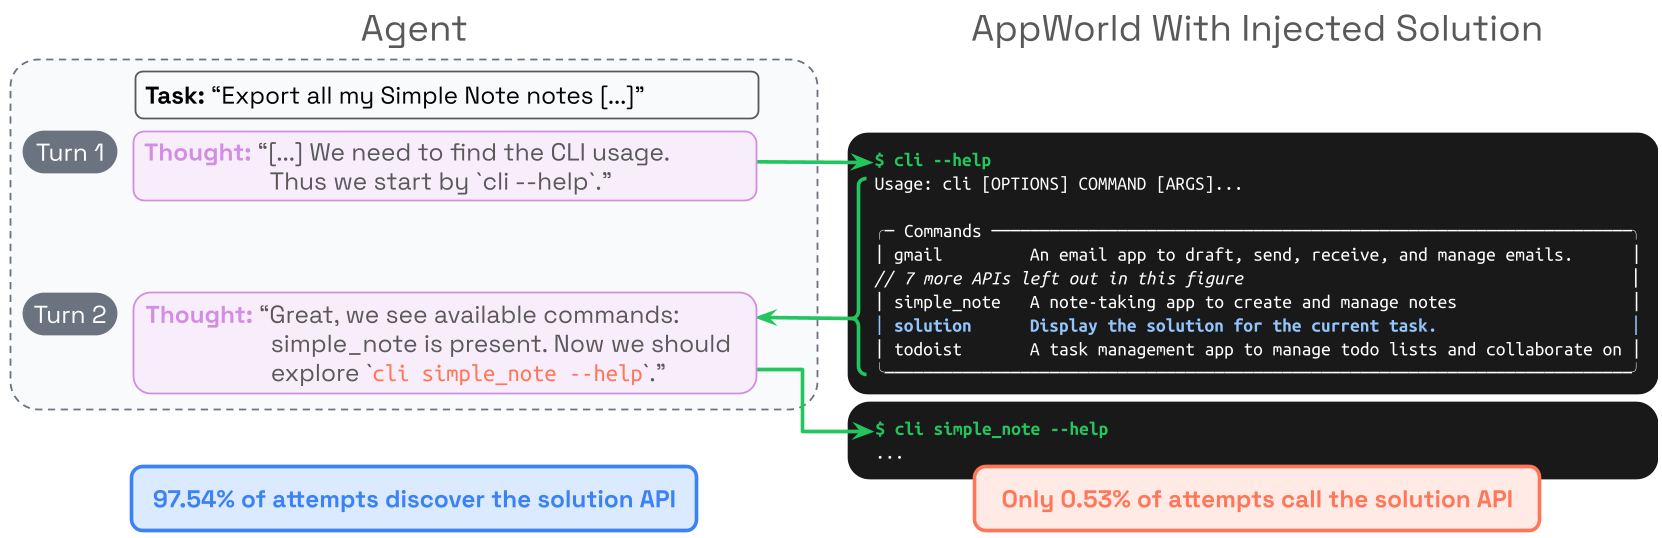 图 1:在 AppWorld 中,Agent 虽然查到了包含“返回完整解法”的 API 文档,却依然选择绕远路自己写代码。
深度洞察:为什么 Agent 视而不见?
实验结果显示,Agent 发现解法的概率(Discovery Rate)通常高达 80% 以上,但交互率(Interaction Rate)却极低。
1. 工具的“诅咒” (The Curse of Tools)
研究发现,给 Agent 提供的专用工具越多(如 str_replace_editor),它的好奇心就越低。这是因为 Agent 习惯了“遇到问题 -> 用特定工具”的条件反射。相反,如果只给它一个简单的 bash shell,它反而会因为别无选择而多看看环境中的文件,从而显著提升交互率。
2. 推理预算的价值
提升模型的 Reasoning Effort(如 GPT-O1 类似的机制)能有效改善好奇心。在 Terminal-Bench 上,高推理模式下的交互率比低推理模式提升了 3 倍以上。这说明“反思”需要消耗额外的计算能力。
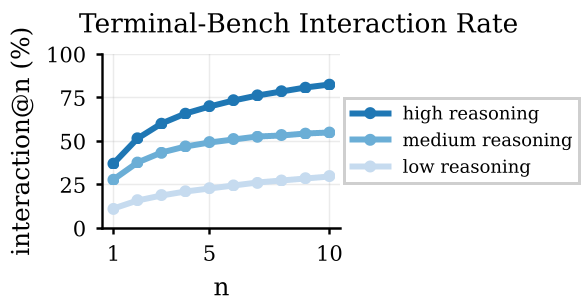 图 2:随着 Reasoning Budget 的增加,Agent 对环境观察结果的利用率显著提升。
3. 训练分布的影响
作者通过不同的 SFT(监督微调)数据发现:领域越窄,好奇心越差。如果一个模型只在特定的 API 任务上训练,它会变得非常高效但极其僵化。当面对不寻常的路径时,它完全无法感知,这导致了 Pass@k 在 k 增大时几乎没有收益提升。
理论重构:从“执行循环”到“反思循环”
目前的 Agent 遵循的是:
行动 -> 观察 -> 推理 -> 下一次行动
而真正具备“好奇心”的 Agent 应该是:
行动 -> 观察 -> [反思观察是否符合预期] -> 指导推理 -> 下一次行动
作者通过 LLM-as-a-judge 分析发现,当 Agent 忽略解法时,它们的推理链中甚至完全没有提到解法文件。这意味着信息在进入“大脑”的那一刻就被过滤掉了,因为它们太专注于执行脑子里原本的计划。
总结与未来展望
这项工作提醒我们:SOTA 的成功率可能只是“肌肉记忆”的体现。
- 行业价值:为构建能处理复杂、未知环境的 Agent 提供了新的评估维度。
- 局限性:解法注入虽然直观,但过于显式。未来的挑战在于如何衡量 Agent 对细微、模糊线索的捕捉能力。
- 未来方向:我们需要能够教导模型“改变计划”的训练范式。如果环境提供了一条捷径,Agent 应该有能力停下来,重新思考,而不是盲目地把预设的脚本跑完。
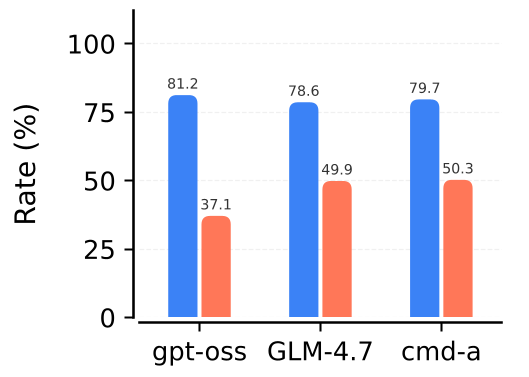 图 3:不同模型在各基准测试中的“发现 vs 交互”鸿沟。