
123D:抹平自动驾驶数据鸿沟,开启全量规模合力
123D: Unifying Multi-Modal Autonomous Driving Data at Scale
本文推出了 123D,一个旨在统一大规模多模态自动驾驶数据的开源框架。它通过标准化 API 整合了包括 nuScenes, Waymo, Argoverse 2 在内的 8 个真实世界数据集及 1 个合成数据集,涵盖 3300 小时驾驶时长,实现了跨数据集的 3D 检测与强化学习训练。
TL;DR
自动驾驶研究长期受困于“数据集孤岛”:每个厂家发布的 Dataset 都有自己的脾气(格式、坐标系、频率)。本文提出的 123D 框架通过 Apache Arrow 打造了一个统一的 API 接口,集成了 3300 小时的异构数据。它不仅是一个工具箱,更是通往自动驾驶“大模型时刻”的工业级数据地基。
背景:碎片化的灾难
在自然语言处理(NLP)领域,我们有 Common Crawl 和 Hugging Face ;在机器人领域,有 Open X-Embodiment。但在自动驾驶领域,开发者往往在为“Waymo 的坐标系和 nuScenes 不一样”或者“双目视觉和 LiDAR 频率对不齐”这类工程琐事浪费时间。
由于不同数据集的 Sensor Rig(传感器布局)和城市环境完全不同,模型往往表现出强烈的数据集偏置(Dataset Bias)。这导致“在德国训练,在美国翻车”成为常态。
核心方法:123D 的“大一统”策略
123D 的核心思想是将所有驾驶记录视为独立且带时间戳的事件流。
- 基于 Apache Arrow 的流式存储:不再强制要求固定的采样率。无论是 10Hz 的相机还是 20Hz 的 LiDAR,都以独立 DataFrame 存储。
- 灵活同步(Sync Table):通过预计算的索引表,123D 允许开发者在访问时动态对齐。你可以按相机的频率对齐 LiDAR,也可以按任意时间窗口检索。
- 标准化坐标系(Standardized Conventions):强制将所有数据转换到 ISO 8855(车身坐标系:x前, y左, z上)和 OpenCV(相机坐标系)。
- 矢量化地图 API:将复杂的 HD Map 抽象为 Lane, Intersection 等标准多边形/折线对象,支持高效的空间查询。
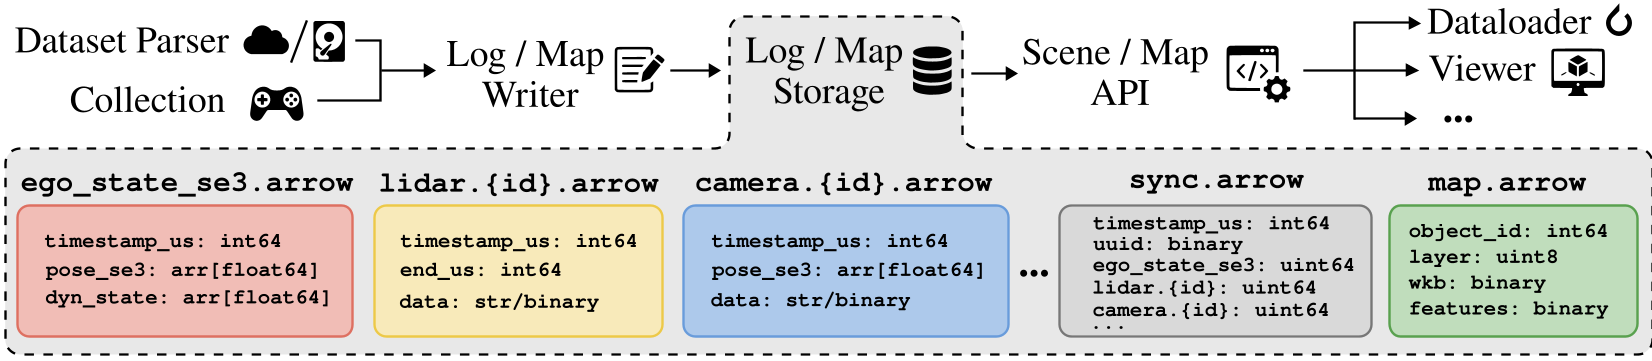 123D 架构图:从原始格式经过 Parser 转换为统一的 Arrow IPC 格式,支持可视化与数据加载。
深度洞察:跨域转移的真实表现
作者进行了两项关键实验:3D 目标检测与强化学习规划。
3D 目标检测
实验揭示了一个残酷的事实:在单一数据集(如 Waymo)训练的模型,直接放到其他平台上的性能(NDS 评分)往往会从 0.6+ 骤降至 0.1 左右。
然而,Mixed-5(混合 5 个数据集训练) 方案表现出了极强的韧性。即使训练总帧数保持不变(每种数据只占 1/5),混合模型的平均泛化性能也远超单一模型。这证明了数据多样性在感知任务中比单一来源的纯数据量更重要。
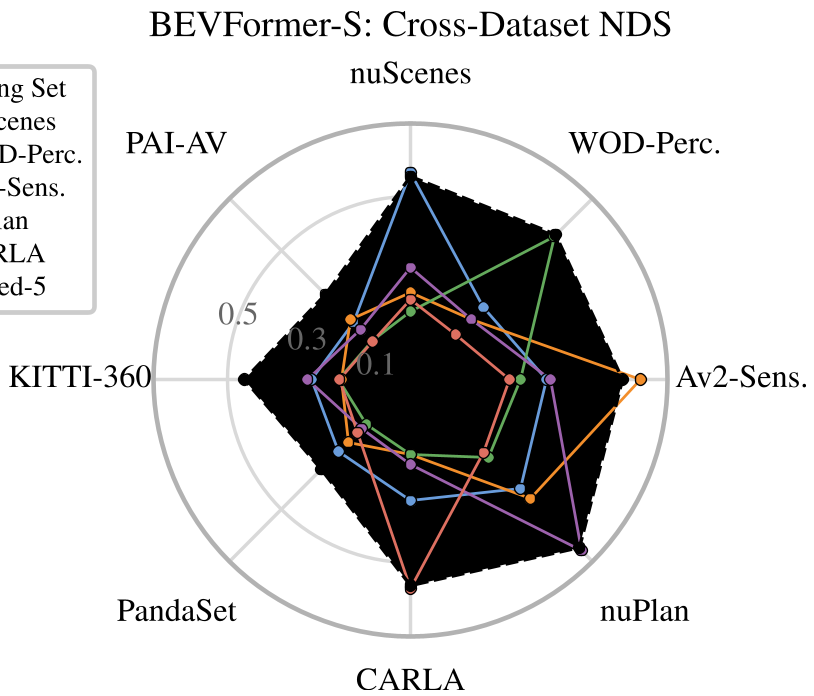 跨数据集 3D 检测结果:可见混合训练(虚线)在各验证集上均表现稳健。
姿态质量与 3D 重建
为了验证数据的物理一致性,作者利用 3D Gaussian Splatting (3DGS) 对各数据集进行了静态场景重建。结果显示,大多数数据集自带的 Pose 质量已经足够支持高质量渲染,但在 nuPlan 等特定数据集上,通过 Kiss-ICP 重新注册位姿能进一步提升重建精度。
总结与价值
123D 的意义不在于提出了一个新的 SOTA 模型,而在于它为行业提供了一个通用的数据协议。
- 对研究者:可以零成本地在 9 个数据集上验证算法的 Generalization。
- 对工业界:合成数据(CARLA)与真实数据的无缝切换,为闭环仿真提供了更广阔的测试空间。
局限性:目前该框架对 Radar(雷达)和语义分割点云的支持尚在计划中,且对大规模 Web 数据的流式处理仍有优化空间。
结论:自动驾驶的未来属于“大模型”,而 123D 是将这些碎片化数据锻造成大模型原材料的关键炼炉。