
4DThinker:让大模型拥有“4D脑补”能力,突破动态空间推理极限
4DThinker: Thinking with 4D Imagery for Dynamic Spatial Understanding
本文提出了 4DThinker,这是首个能够通过“动态潜意识心理成像”(Dynamic Latent Mental Imagery)使视觉语言模型(VLMs)具备 4D 空间思维能力的框架。该方法无需外部几何模块,通过在连续隐藏空间中模拟场景随时间的演变,显著提升了模型在单目视频中的动态空间推理能力。
TL;DR
清华大学、香港中文大学等机构的研究团队推出了 4DThinker。它通过一种名为“动态潜意识心理成像”的机制,让大模型在推理视频时,不只是“看”图说话,而是在脑海中“模拟”物体的 4D 轨迹。该方法在 DSR-Bench 等硬核动态基准上提升了超过 30 个百分点,性能甚至超越了最强的闭源模型及依赖外部几何插件的模型。
痛点深挖:为什么大模型是“空间盲”?
在处理单目视频时,LLM 往往分不清究竟是“相机在动”还是“物体在动”。
- 语言的局限性:用文字来描述物体的 3D 坐标或 4D 轨迹极其低效且容易产生歧义。
- 黑盒依赖:之前的研究倾向于给模型“挂载”一个深度估计或 3D 重建模块,这虽然有效,但模型本身并没有进化,且推理延迟巨大。
核心逻辑:像人一样“思考”运动
当我们看到一个骑行者穿过街道时,我们的视觉系统会自动锚定静止的背景来感知自己的移动,并预测骑行者的路线。4DThinker 借鉴了这种人类认知学中的 “心理成像”(Mental Imagery) 机制。
1. 架构解析:潜空间里的 4D 模拟
4DThinker 不再强求将推理过程全部转化为文字,而是在隐向量空间中插入特殊的 <imagery> 占位符。这些占位符代表了模型对物体未来或过去位置的“潜意识想象”。
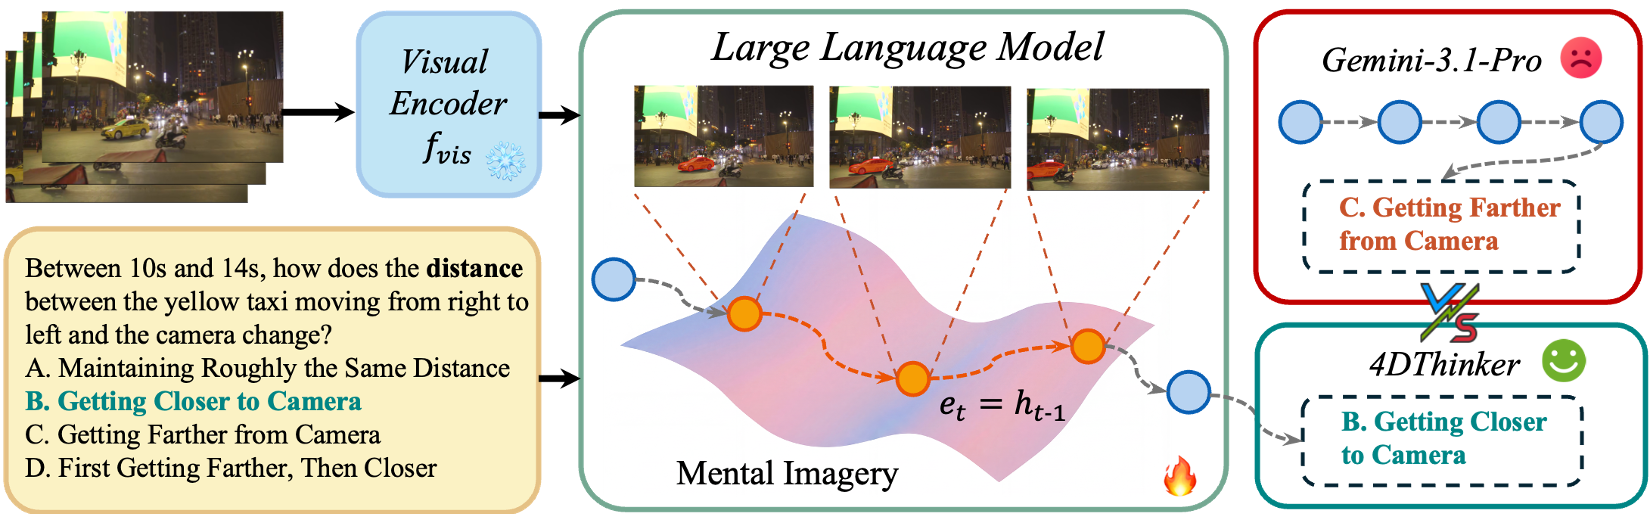
- DIFT (动态影像微调):通过联合优化交叉熵损失(文本层面)和余弦相似度损失(潜空间层面),强迫模型的隐藏状态去对齐物体的真实视觉轨迹。
- 回归预测:模型在生成推理步骤时,会递归地消耗自己上一步生成的潜变量,实现自洽的时空推演。
2. 数据驱动:无需人工标注的 4D 知识库
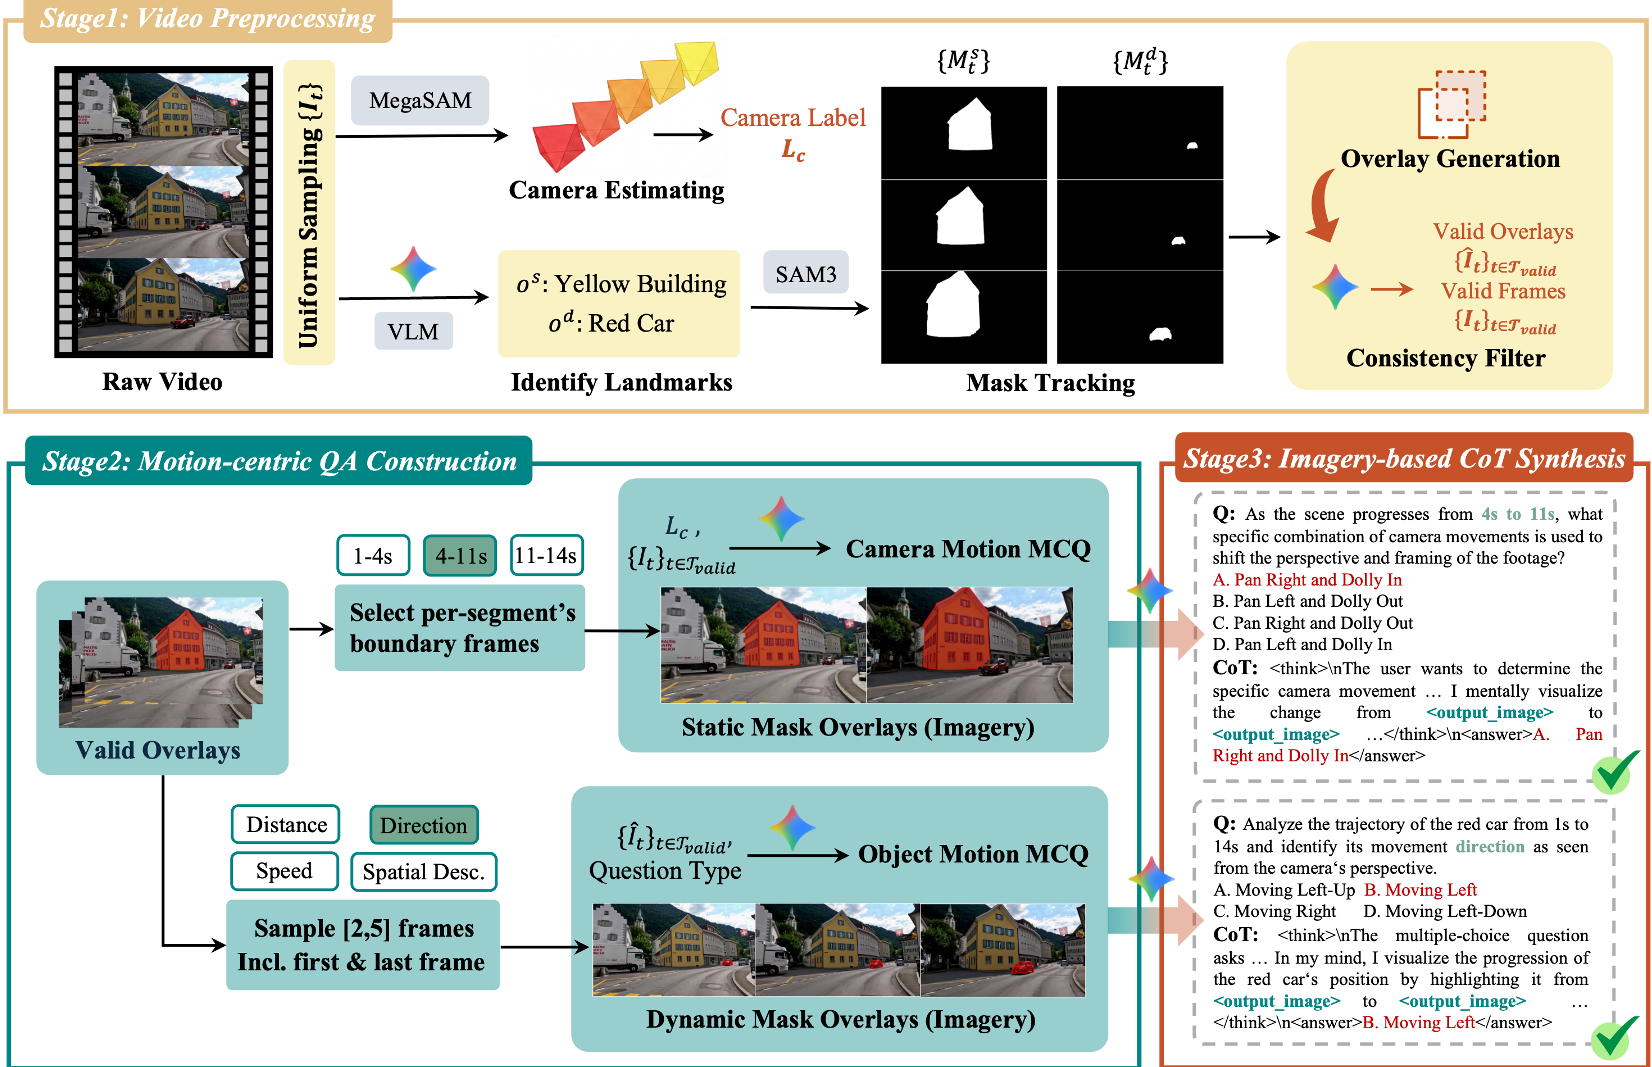
研究者开发了一套 Annotation-free 的数据流水线。利用 MegaSaM 和 SAM3 等工具自动提取视频中的静态地标和动态轨迹,并通过 LLM 合成出数万条带有“心理成像”思维链(Chain-of-Thought)的数据。
实验战绩:全线 SOTA
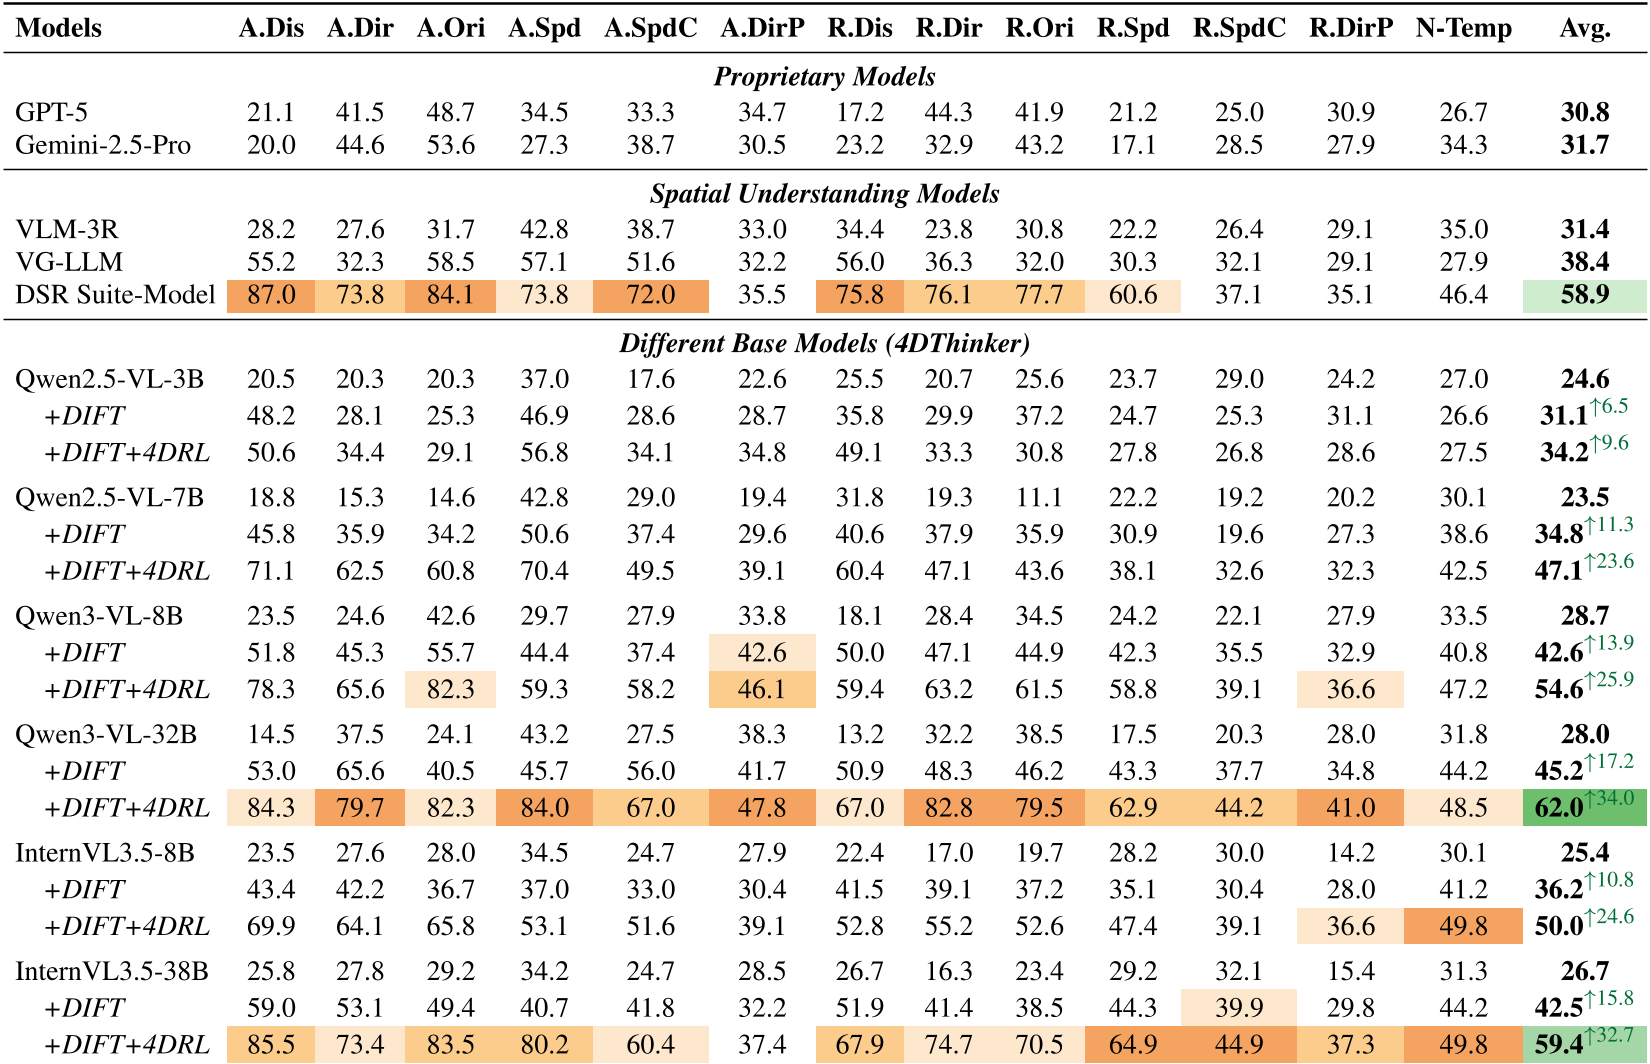
在多个动态空间推理基准测试中,4DThinker 展现了碾压级的实力。特别是在 Qwen3-VL-32B 底座上,它在 DSR-Bench 的平均分从 28.0 飙升至 62.0。
关键洞察:
- 解耦能力:在“相机-物体”相互作用的子项中提升最大,证明模型真正理解了相对运动的物理本质。
- 消融实验验证:如果不进行潜空间对齐(w/o Lsim),准确率会大幅下跌,证明“脑海中的画面”对空间推理至关重要。
深度洞察:从“复述”到“模拟”
4DThinker 的成功标志着 VLM 训练思路的转变:从单纯的文本序列建模,转向对物理世界的隐式仿真。
- 局限性:目前流程仍高度依赖前端几何估计工具(如 MegaSaM)的质量,如果底层几何噪声太大,模型的“想象”也会失真。
- 未来展望:这种“潜空间思维”可以被进一步扩展到闭环的机器人导航中。当模型在脑中模拟出动作的后果时,它就不再只是一个对话机器人,而是一个真正的具身智能体。
总结 (Takeaway):4DThinker 告诉我们,处理高维物理空间问题,文字不如向量。让模型学会“在潜空间里画画”,是通往下一代通用视觉智能的关键跳板。