
A2RD:长视频生成的“导演智能体”,突破 10 分钟一致性大关
A$^2$RD: Agentic Autoregressive Diffusion for Long Video Consistency
本文提出了 A2RD (Agentic Auto-Regressive Diffusion),这是一种用于长视频生成的智能体自回归扩散架构。该方法通过解耦创作合成与一致性强制执行,实现了分钟级长视频的 SOTA 一致性与叙事连贯性,在 VBench-Long 和新提出的 LVbench-C 基准上分别提升了约 30% 的一致性和 20% 的叙事连贯性。
TL;DR
在视频生成领域,生成一个几秒钟的精彩片段已不再是难事,但如何保持一个 5 到 10 分钟的长视频在角色、环境和逻辑上不“崩坏”?Google Cloud AI 与新加坡国立大学联合提出的 A2RD (Agentic Auto-Regressive Diffusion) 给出了一套创新的方案:将视频生成从“盲目生成”转变为“导演监制”模式,通过多模态记忆和分级自我修正技巧,在无需任何额外训练的情况下大幅刷新了长视频一致性的记录。
痛点深挖:为什么长视频会“语义漂移”?
传统的长视频生成方案通常分为两派:
- 帧自回归 (FAR):像写小说一样一字一句往后推,虽然局部连贯,但容易出现“写着写着就把主角衣服换了”或者陷入死循环。
- 片段自回归 (SAR):把视频分成一小段一小段生成。这种方法叙事控力强,但段落之间的衔接极其生硬。
其核心症结在于它们都是开环系统——一旦生成完成,错误就会像滚雪球一样向后传递,无法纠正。
核心机制:A2RD 的“检索-细化”闭环
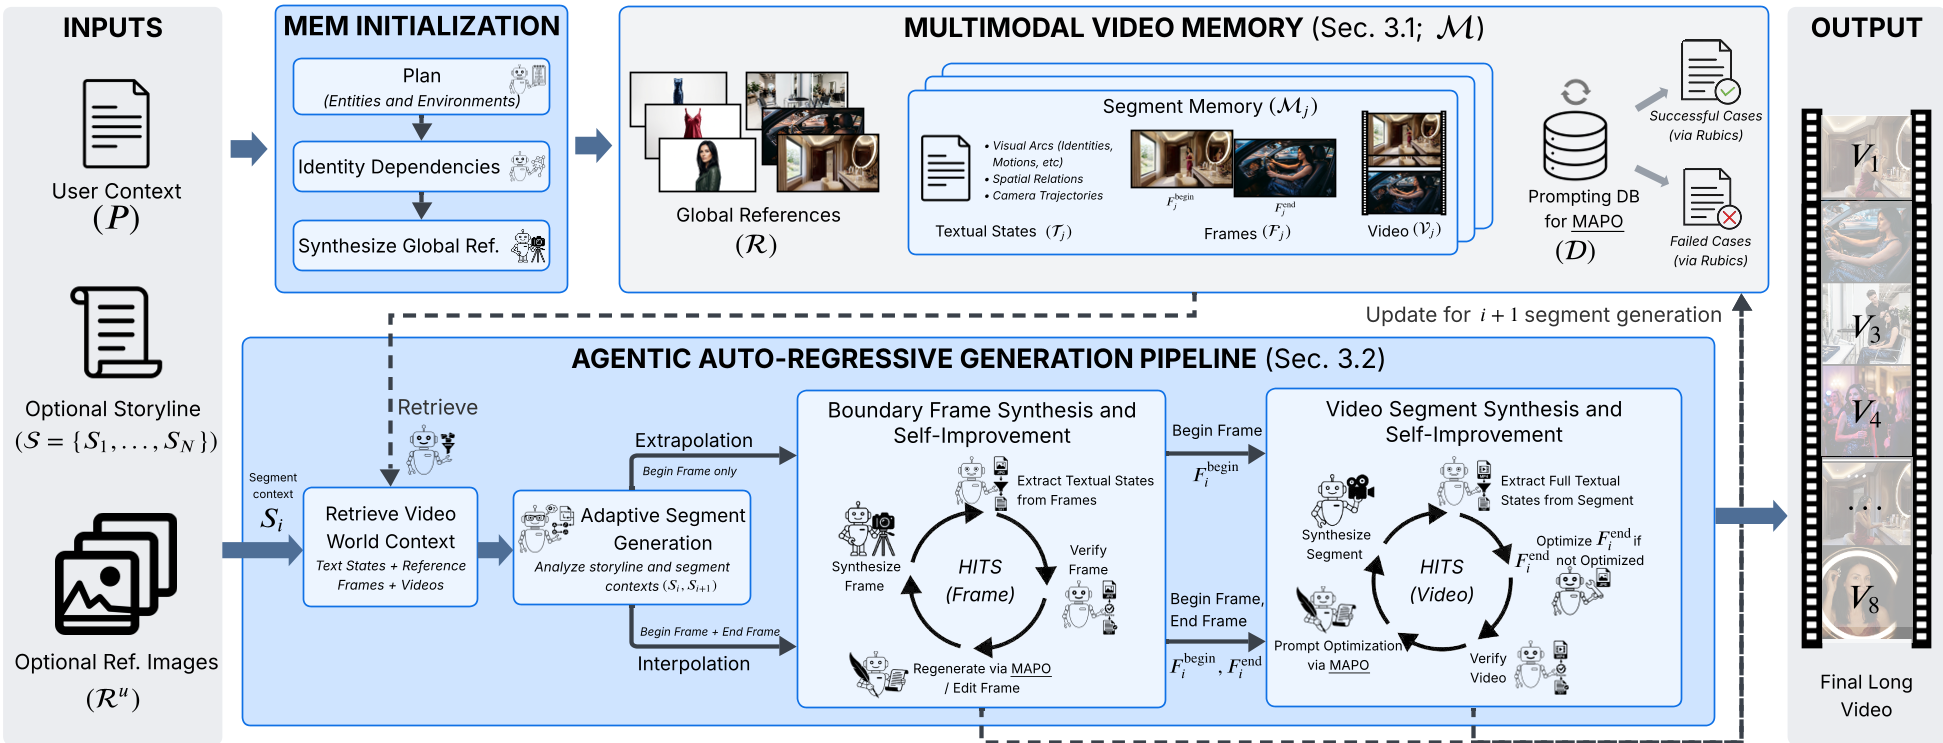
A2RD 的本质是将一个大模型、一个图像生成器和一个视频生成器组织成一个有组织、有记忆的“智能体系统”。
1. 多模态视频记忆 (MVMem)
不同于前人只存图像,MVMem 存储了三层信息:
- 文本状态 (Textual States):跟踪视觉弧线、空间关系和镜头状态。
- 帧记忆 (Frames):存储关键帧作为视觉锚点。
- 视频记忆 (Videos):保留动态信息以保持运动连续性。
2. 分级自我改进 (HITS) 与 MAPO
这是 A2RD 最具“导演思维”的部分。在每一段视频生成后,系统会自动调用 MLLM 作为“评委”,按照一个包含 10 个维度的 Rubric (评分量规) 进行打分。
- 如果分数不达标,系统会通过 MAPO (记忆增强提示词优化) 动态调优 Prompt。它会学习以往成功和失败的案例,生成类似“将抽象描述替换为具体物理坐标”的优化准则。
实验与结果:LVbench-C 基准的挑战
为了测试 A2RD 到底多强,作者提出了 LVbench-C,专门设计的挑战包括:角色在消失 10 个片段后重新出现、物品状态的非线性进化等。
关键战绩
- 一致性提升:在 3-5 分钟视频中,角色一致性(Character Consistency)相比最强基线 VideoMemory 提升了约 30%。
- 叙事连贯性:通过对比可以发现,A2RD 生成的视频能够非常自然地处理从“钢琴家在阁楼创作”到“剧院表演”的复杂转场。
- 超长扩展性:在 10 分钟的实验中,A2RD 依然维持了超过 84% 的环境一致性。
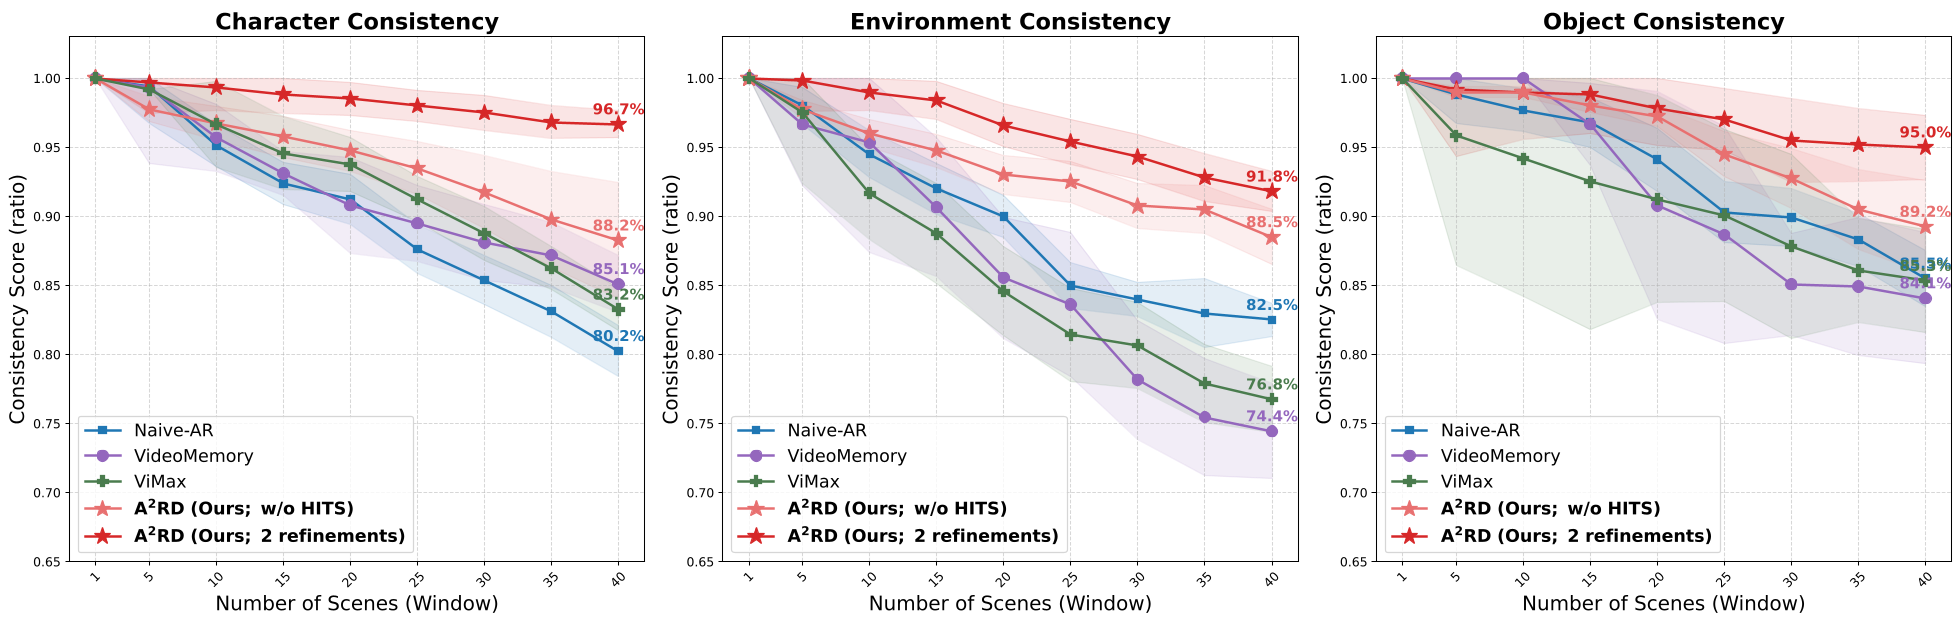 图:随着视频时长增加,A2RD 的一致性得分(紫色)明显优于传统模型(蓝色/橙色),展现了极强的抗衰减能力。
深度洞察:为什么这很重要?
A2RD 的成功不仅仅在于刷榜,它揭示了一个重要趋势:推理时间缩放 (Inference-time Scaling) 可能比单纯堆参数量更能解决生成一致性问题。通过多轮的“尝试-反馈-修正”,我们可以弥补基础模型在时空推理上的短板。
局限性:虽然效果惊艳,但 A2RD 的计算开销比传统方法大。生成一段视频需要多次调用 MLLM 和重复渲染片段(平均每片段增加约 7.2 分钟开销)。不过在电影制作、高质量内容营销等对质量极度敏感的领域,这点时间代价换取“不废片”的保障是极具性价比的。
总结
A2RD 成功地将视频生成从一次性的逻辑黑盒变成了可交互、可自我修正的工程系统。对于未来的生成式视频工作流,这种“智能体统筹”的模式可能成为标准配置。
注:更多视觉示例可访问项目主页 dxlong2000.github.io/AARD。