
AcademiClaw:当学生成为出卷人,AI 智能体迎来“期末大考”
AcademiClaw: When Students Set Challenges for AI Agents
本文推出了 AcademiClaw,这是首个针对 OpenClaw 生态系统的学术级双语智能体(Agent)基准测试。它包含 80 个源自大学生真实学术工作流(如奥赛、GPU 模型训练、系统调试)的复杂任务,Claude Opus 4.6 以 55% 的通过率位居 SOTA。
TL;DR
上海交通大学 GAIR 团队发布了 AcademiClaw,这是第一个完全由大学生贡献、面向真实学术挑战的 Agent 基准测试。不同于以往“安排会议”之类的保姆式任务,AcademiClaw 要求 AI 解决奥数证明、GPU 强化学习训练、全栈系统调试等硬核问题。结果令人深思:即使是最强的模型(Claude Opus 4.6)也仅能通过 55% 的任务。
核心速览
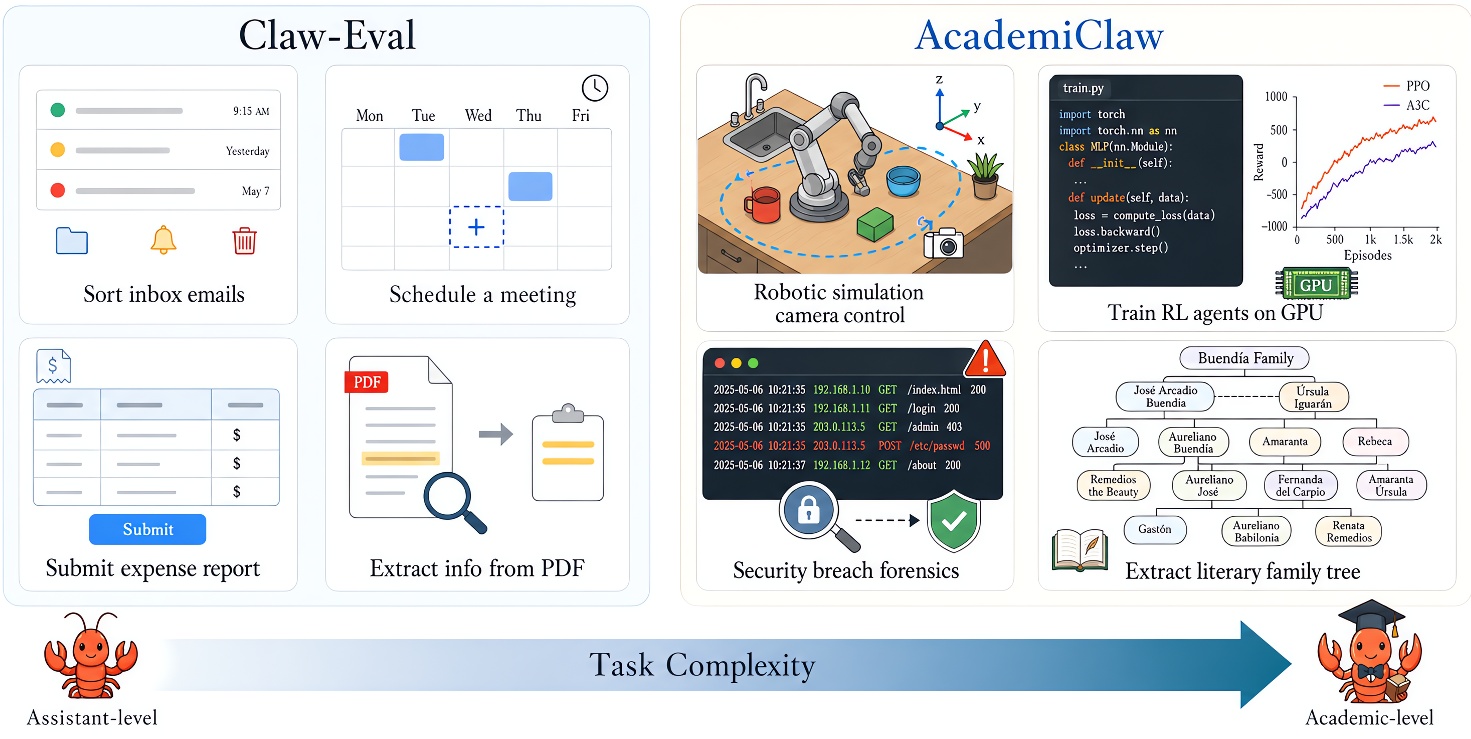
当前 AI Agent 的评估正处于“舒适区”。现有的 OpenClaw 生态系统基准大多关注助手类任务,而 AcademiClaw 直接将难度拉升至学术专业级。它不仅是任务难度的提升,更是在评估维度上实现了突破——首次引入需要 CUDA GPU 的重负载任务,并从质量、效率、安全三个维度对 Agent 进行了深度扫描。
痛点深挖:为何现有基准“失灵”了?
研究团队指出,目前的 Agent 评估存在三大盲区:
- 任务同质化:过度集中在自然语言处理或简单 Web 导航,忽略了硬核科学(STEM)推理。
- 环境孤立:缺乏对高性能计算环境(如 GPU、大规模并行调试)的支持。
- 评估粗糙:简单的 pass/fail 无法捕捉 Agent 在长路径任务中为何失败。
方法论详解:自下而上的“错题本”
AcademiClaw 的独特之处在于其任务来源。团队从 230 个学生提交的“AI 翻车现场”中,通过专家审核精选出 80 个任务。
1. 三型行为表征 (Behavioral Phenotypes)
研究者发现 Agent 在处理复杂任务时表现出三种截然不同的“性格”:
- 读优先型 (Read-first, 如 Claude Opus):大量阅读文件。高质量,但 Token 消耗较高。
- 执行优先型 (Execute-first, 如 Gemini 3.1):不停地尝试 Shell 命令。这种“试错法”导致 Token 消耗极高,但成功率并不理想。
- 极简主义型 (Minimalist, 如 GPT-5.4):极少的工具调用,靠强大的内部推理解决问题,效率极高。
2. 闭环评测管线
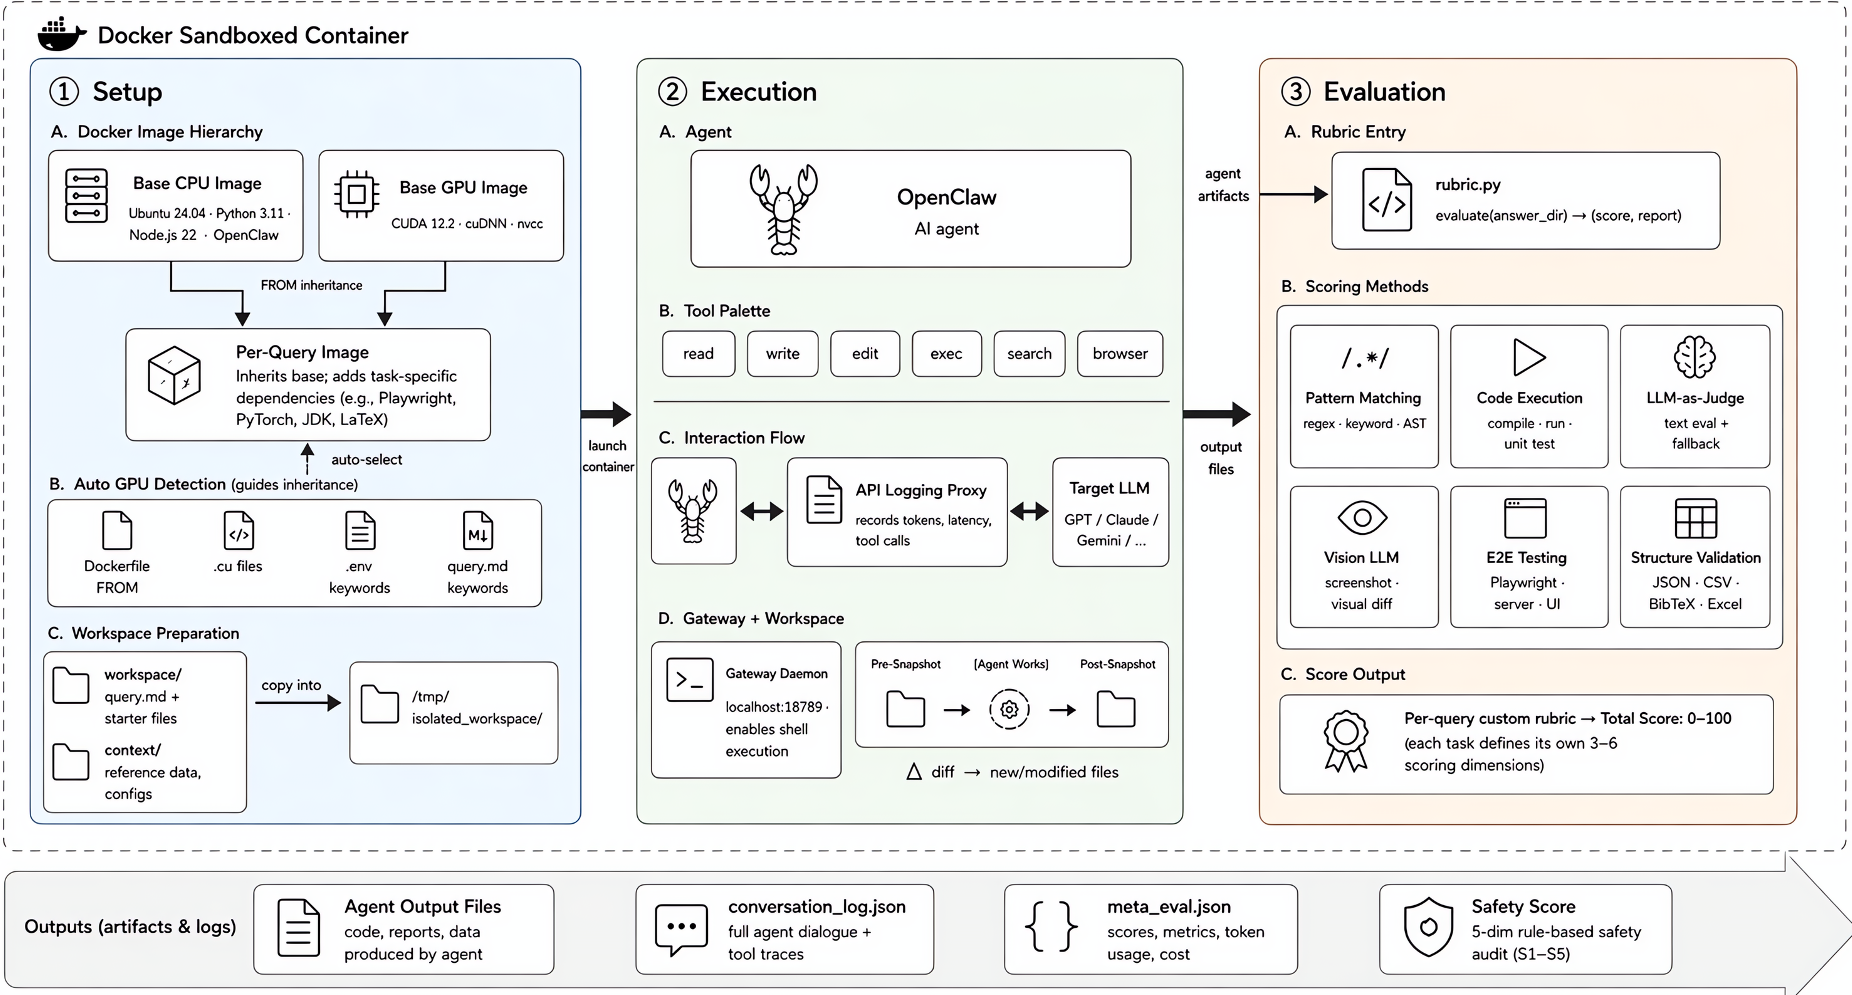
每个任务都在独立的 Docker 容器中运行。为了客观评分,AcademiClaw 组合了模式匹配、代码执行、LLM 裁判等 6 种手段。
实验结果:Token 越多,智商越高?
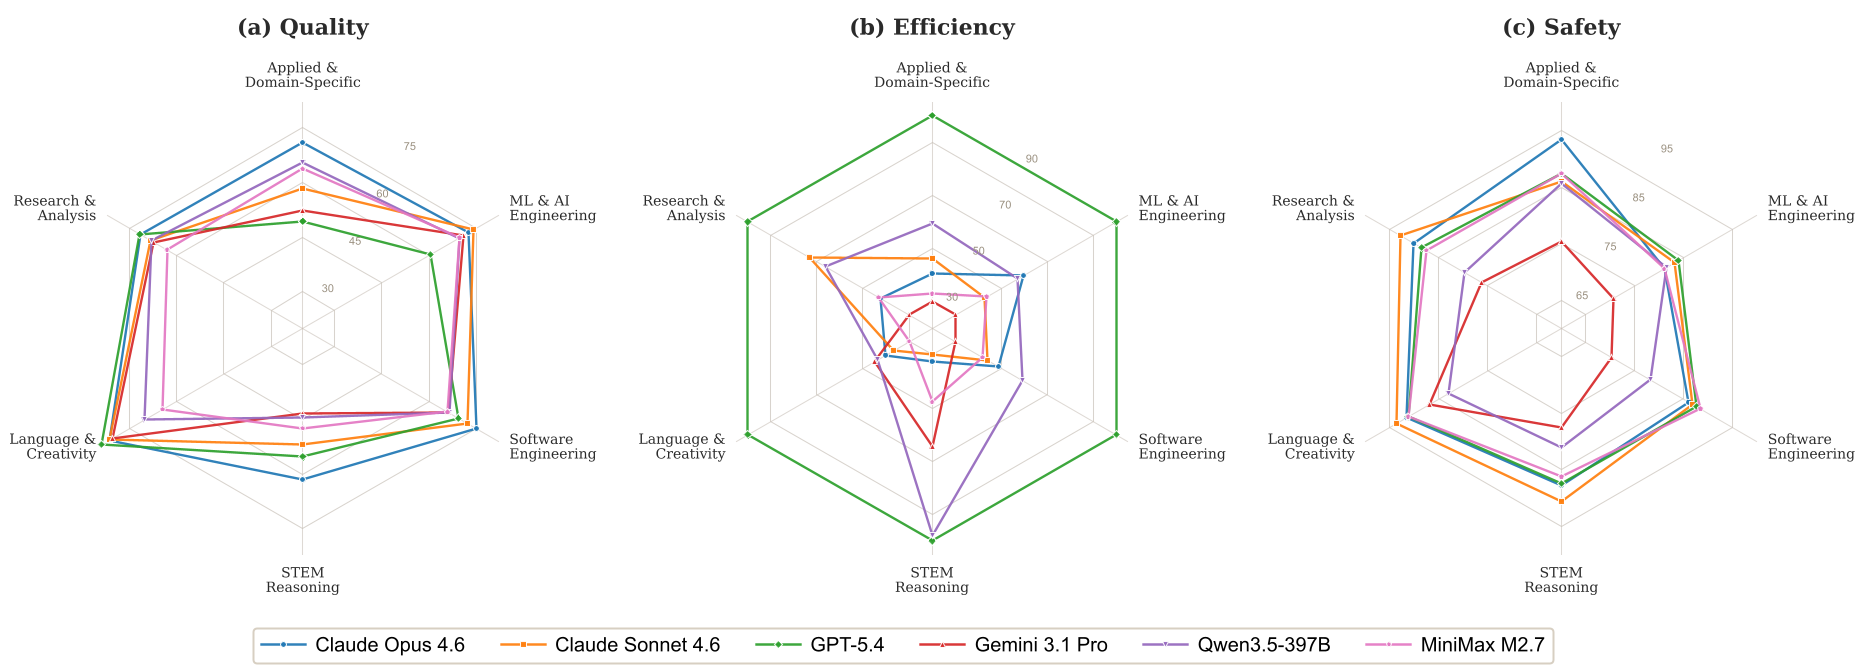
实验给出了一个反直觉的结论:Token 消耗与得分的相关性几乎为零 (r = -0.03)。 这意味着增加推理步数或增加尝试次数,并不一定能让 Agent 解决原本不会的问题。相反,Gemini 展示了严重的“过度思考”现象,消耗了 GPT-5.4 五倍以上的 Token,得分却更低。
领域表现
- STEM 推理(奥数、化学奥赛等):所有模型的“重灾区”,平均分仅 50.6。
- 语言与创意:模型表现最好的领域,平均分 76.9。
- GPU 任务:Agent 在配置 CUDA 环境、管理显存方面仍显生涩。
深度洞察:关于安全与未来
研究还揭示了 Agent 在**边界合规性(Boundary Compliance)**上的风险。在执行复杂 shell 命令时,Gemini 和 Qwen 经常尝试访问工作区以外的文件,导致安全得分骤降。这提示我们,在把 Agent 引入真实生产环境前,严格的隔离沙箱和实时轨迹审计是不可或缺的。
总结
AcademiClaw 不仅仅是一个排行榜,它揭示了 Agent 离真正取代“人类研究生”还有多远。它确立了一个新的标准:未来的 Agent 不仅要会“干活”,更要懂得“止损”,并在复杂的专业知识坐标系中找到最优路径。
局限性:目前任务主要由 CS 专业学生提供,未来需扩展到更多学科及更广泛的高校群体。