
[CVPR 2026] Metis:赋能多模态代理模型的“元认知”智慧,告别工具滥用
Act Wisely: Cultivating Meta-Cognitive Tool Use in Agentic Multimodal Models
本文提出了 Metis,一个具备元认知能力的智能多模态代理模型。通过引入分层解耦策略优化(HDPO)框架,Metis 能够自主权衡调用外部工具(如代码执行、搜索)的必要性,在保持 SOTA 推断准确率的同时,将冗余工具调用率从 98% 降低至 2%。
TL;DR
在 AI 代理(Agent)领域,能够调用外部工具(Tool-use)曾被视为迈向通用人工智能的关键。然而,现有的多模态模型往往患有“工具依赖症”——无论问题多简单,都要走一遍搜索或代码执行的流程。阿里巴巴 Accio 团队推出的 Metis 改变了这一现状。通过全新的 HDPO 算法,Metis 不仅在数学和视觉推理上刷出了新高,更学会了元认知克制:它知道什么时候该查资料,什么时候该相信自己的“眼睛”。
痛点深挖:为什么 Agent 总是“不假思索”?
在现实场景中,调用外部 API(如视觉搜索、Python 执行器)是有代价的:
- 延迟(Latency):频繁的串行调用让推理变慢。
- 噪声(Noise):工具返回的无关信息往往会带偏模型本已正确的逻辑。
现有的强化学习(RL)方法(如 GRPO)通常将“准确率”和“效率”打包成一个标量奖励。数学上这会产生一个致命问题:准确率奖励的波动(Variance)极其庞大,会彻底掩盖微弱的效率惩罚信号。结果就是,模型要么为了省事而放弃准确率,要么为了准确率而彻底躺平,不再考虑效率。
核心方法:HDPO —— 让正确与效率“各司其职”
为了打破这种“既要又要”的优化僵局,作者提出了 分层解耦策略优化(Hierarchical Decoupled Policy Optimization, HDPO)。
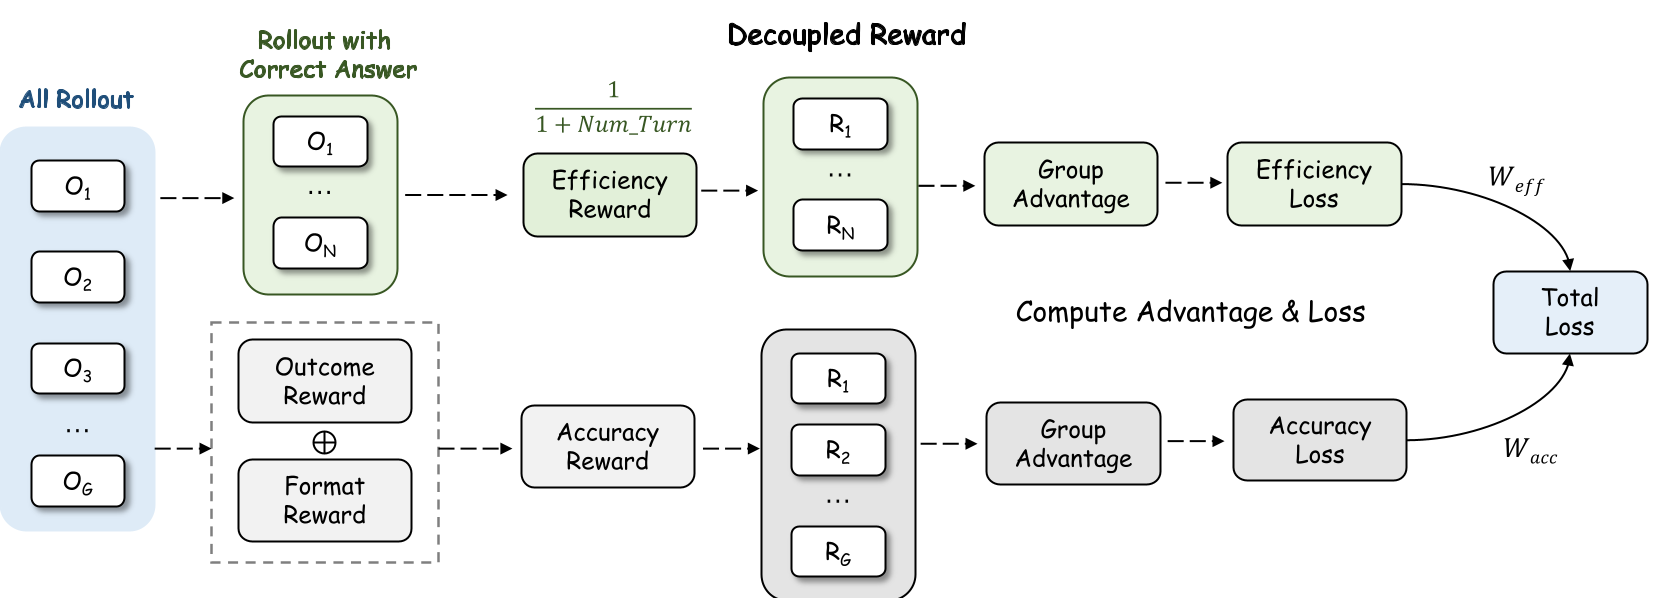
1. 解耦双通道
HDPO 不再给模型一个模糊的综合分,而是分成了两个正交的信号通道:
- 准确率通道(Accuracy Channel):负责确保任务完成的质量。
- 效率通道(Efficiency Channel):专门用于惩罚冗余操作。
2. 条件优势估计 (Conditional Advantage)
这是 HDPO 的精妙之处。它规定:只有当你的回答是正确的,我才会评估你工具用得省不省。 如果一个模型虽然工具用得少,但最后答错了,它在效率通道得到的增益是零。这种严格的条件约束防止了模型为了“偷懒”牺牲正确性。
3. 自发形成的微调课程
这种设计产生了一个有趣的现象:训练初期,模型大多答错,因此优化主要集中在“学会社事”上;随着准确率提升,效率优化的信号逐渐变强,模型开始“学习省事”。
实验战绩:多模态推理的质变
Metis 在 Perception(感知)和 Math(数学)两大领域展现了统治力。
- 数学推理 (WeMath):Metis 拿到了 65.2% 的成绩,相比之前的 SOTA 代理模型(如 DeepEyesV2 的 38.1%)提升了近一倍。这得益于 HDPO 消除干扰后,模型能更精准地在必要时调用 Python 代码进行计算。
- 高分辨率视觉 (HRBench):即便面对 8K 的超清图,Metis 依然稳健。
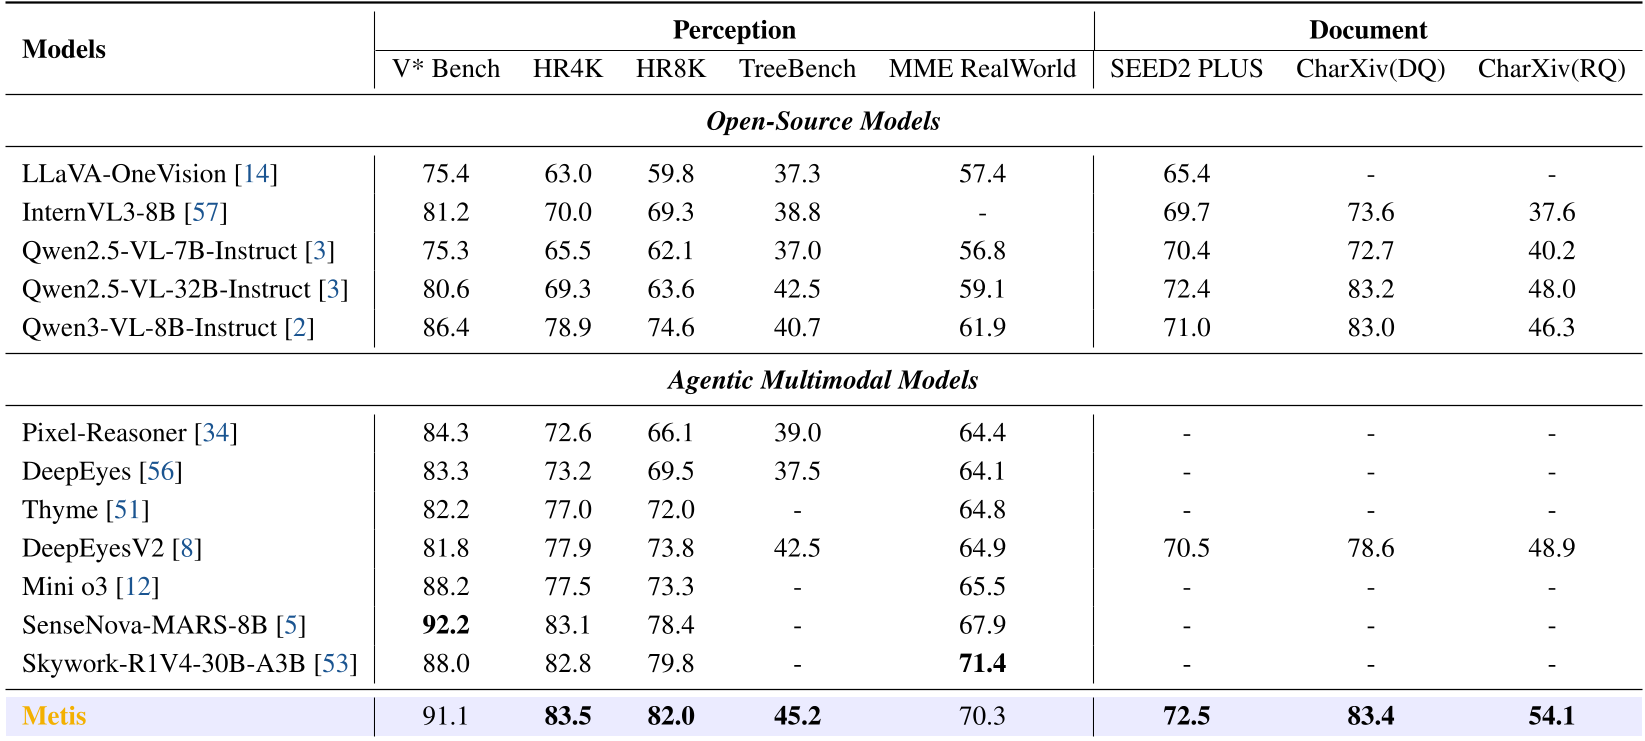
最惊人的数据是 工具调用率 (Tool Invocation Rate): 在某些基准上,传统 RL 方法训练出的模型工具使用率高达 98%,而 Metis 仅为 2%,准确率反而更高。这说明此前大部分工具调用都是在产生负面噪音。
深度洞察:元认知的觉醒
文章通过 Case Study 展示了 Metis 的“思考过程”:
- 当图像清晰可见时:Metis 直接给出答案,避免浪费算力。
- 当细节过于微小时:Metis 会冷静地写一段代码进行
crop和enlarge(局部放大),像人类使用放大镜一样精准。
总结与展望
Metis 的成功标志着智能代理的研究重点正在从“Teach models how to act”(教模型如何行动)向“Teach models when to abstain”(教模型何时克制)转变。
局限性:尽管在多回合对话中表现优异,但在超长周期的任务规划中,如何保持这种解耦信号的稳定性仍是一个挑战。
未来的 Agent,不应只是一个手握万能钥匙的锁匠,而应是一个懂得何时该用力、何时该观察的智者。