
ActCam:零样本联合相机与 3D 动作控制,重塑视频生成的电影级质感
ActCam: Zero-Shot Joint Camera and 3D Motion Control for Video Generation
本文提出了 ActCam,一种用于视频生成的 Zero-shot(零样本)联合相机与 3D 角色动作控制方法。该方法基于预训练的 Image-to-Video 扩散模型,实现了在无需额外训练或微调的情况下,同时精准控制角色的复杂动作轨迹与相机的 3D 运动路径。
TL;DR
在视频生成领域,如何让“演员”跳得好,且让“摄影师”配合得好,一直是个难题。ActCam 是一项由 Kinetix、牛津大学及 MBZUAI 联合推出的 Zero-shot 框架,它首次在不进行任何模型训练的前提下,实现了对角色 3D 动作和相机 3D 轨迹的精准联合控制。通过将 3D 几何先验巧妙地转化为扩散模型的 dense conditioning,它让普通 AI 模型瞬间具备了电影级的运镜能力。
背景:2D 控制的崩塌与 3D 的必然
目前的视频控制模型(如 ControlNet, AnimateAnyone)大多依赖 2D Keypoints。然而,当相机发生大幅度旋转或位移时,2D 信号会变得极其模糊——同一个 2D 投影可能对应无数种 3D 动作。更糟糕的是,如果环境深度是不变的,而你强行给了一个快速移动的 Pose,画面就会表现出诡异的“滑步”或背景撕裂。
以往的解决办法是“练”,即针对相机控制专门微调一个巨型 Transformer 模型(如 Uni3C)。但这带来了巨大的计算成本,且模型通用性极差。ActCam 的核心直觉是:既然 backbone(如 VACE)已经理解了深度图(Depth)和姿态图(Pose),那么我们只需在输入端把这两种信号在 3D 空间中物理对齐,模型就能自然地输出正确的结果。
核心黑科技:几何感知的条件调度
1. 场景解耦与合成 (Scene Transfer)
为了防止背景深度图中的“静态角色痕迹”干扰正在运动的新角色(这通常会导致重影),ActCam 采用了一套精密的预处理流程:
- Inpainting:先从参考图中把角色“抠掉”,填补出完整的背景。
- 3.D Anchor:利用 MoGe 等单目几何估计工具构建背景的 3D 场景。
- 精细对齐:使用带权重的几何对齐算法,将提取自驱动视频的 3D SMPL 动作模型“安放”在 3D 背景中,确保脚踏实地。
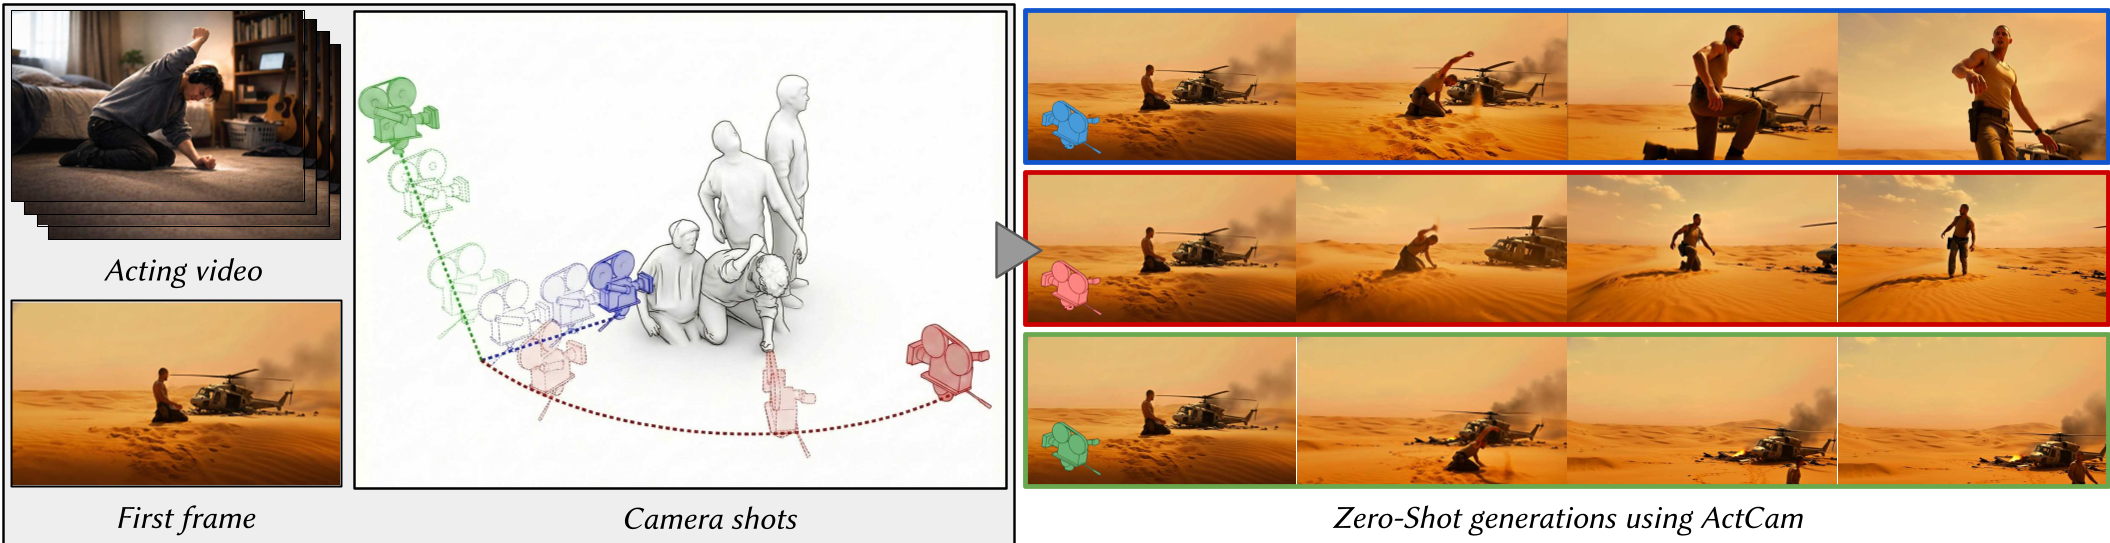 图 1:ActCam 整体流程。从单一参考图和 3D 相机路径出发,构建几何一致的控制信号。
2. 两阶段去噪 (Two-Phase Conditioning)
这是 ActCam 的灵魂所在。作者发现,如果全程强加深度约束,背景会变得过于死板,甚至连衣服褶皱都会被当成错误的几何波动而抹除。
- Phase 1 (早期):输入
Pose + Sparse Depth。利用高噪声阶段确定场景的宏观布局和视角变化。 - Phase 2 (后期):只保留
Pose。在细节生成阶段解放扩散模型,让其自由填充高频细节,保证视频的灵动感。
实验表现:越是大幅度运镜,优势越明显
在与 Uni3C 的对比中,ActCam 在处理复杂的绕拍、俯仰等运镜时展现了极高的稳定性。由于没有经过特定数据集的微调,它的成像质量(Imaging Quality)直接继承了基座模型的上限,同时也避免了动作跟随不紧密的问题。
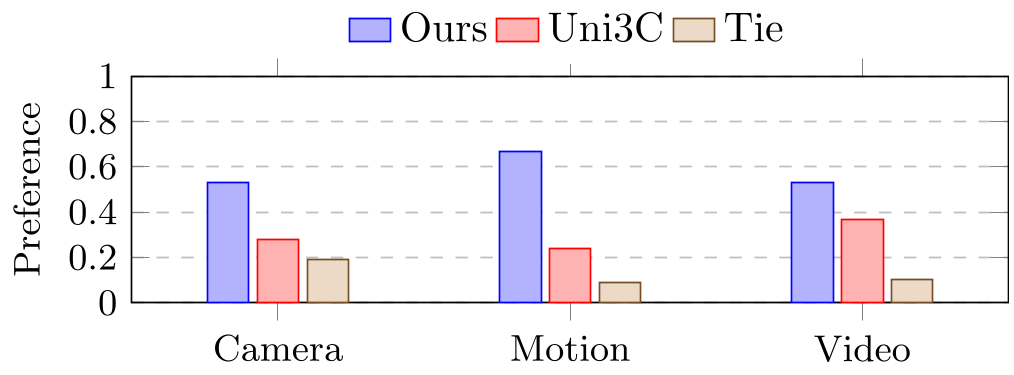 图 2:用户评分对比。ActCam 在相机贴合度、动作还原度和视觉质量上均大幅领先。
3D 动作稳定性
传统的 2D 方法在角色转身时常发生“肢体瞬移”,而 ActCam 结合了 GVHMR (3D Human Motion Recovery)。这意味着即使角色转到了背面,3D 模型的连贯性也能通过深度引导,传递给扩散模型。
深度洞察与总结
ActCam 的成功再次印证了 "Data/Geometry Engineering over Fine-tuning" 的趋势。与其费力不讨好地训练一个理解相机的专用模型,不如在推理时注入更符合物理直觉的条件信息。
局限性: 虽然 ActCam 是 Zero-shot 的,但它依赖于高性能的单目深度估计和 3D 人体恢复工具。如果前端的 3D 重建出现结构性错误,ActCam 也很难在后端生成时自行修正。此外,极其复杂的遮挡场景(如角色进入树丛后完全消失再出现)仍是此类方法的挑战。
展望: 随着万亿级参数的视频扩散模型(如 Sora、Lumina-Video)不断涌现,像 ActCam 这种能够即插即用的精密控制器,将成为 AI 电影工业化中不可或缺的“摄影控制台(DIT)”。