
[CVPR 2026] AdaMem:打破语义检索局限,构建用户中心的长周期对话“超级大脑”
AdaMem: Adaptive User-Centric Memory for Long-Horizon Dialogue Agents
本文提出了 AdaMem,一个面向长周期对话智能体的自适应用户中心记忆框架。该框架通过整合工作记忆、情节记忆、角色记忆和图谱记忆,结合问题感知的路由规划与多智能体协作,在 LoCoMo 和 PERSONAMEM 榜单上均创下了 SOTA 纪录。
TL;DR
在长周期对话(Long-horizon Dialogue)中,智能体往往会“失忆”或“张冠李戴”。本文提出的 AdaMem 框架通过引入自适应路由与四维结构化记忆(Working, Episodic, Persona, Graph),不仅让模型记住了“谁说了什么”,更理解了事件间的时序逻辑。实验证明其在时序推理任务上取得了 23.4% 的惊人增长。
背景:为什么简单的 RAG 搞不定长对话?
目前大多数 Agent 的记忆方案本质上是“平铺式检索”:把对话历史切成 Chunk,算个 Embedding,根据相似度捞回来。这种方法有三个致命伤:
- 语义误导:问“我的猫叫什么”,系统可能捞出一堆关于“狗”的讨论,仅仅因为它们都属于“宠物”主题,却由于语义间隔错过了真正的答案。
- 时序断裂:碎片化的存储丢失了“先发生 A,再导致 B”的因果链。
- 粒度僵化:有些问题需要精细到某句话,有些则需要宏观的角色画像,固定长度的 Chunk 无法兼顾。
核心机制:AdaMem 的四维记忆矩阵
AdaMem 不再把记忆看作一个大垃圾袋,而是将其组织为四个相互配合的层级:
- Working Memory:滑动窗口缓冲区,保存最即时的上下文。
- Episodic Memory:结构化的长期记录,包含事件、事实和摘要。
- Persona Memory:从情节中蒸馏出的用户画像,捕捉稳定的偏好。
- Graph Memory:核心创新!利用异构图连接消息、主题和实体,支持关系感知检索。
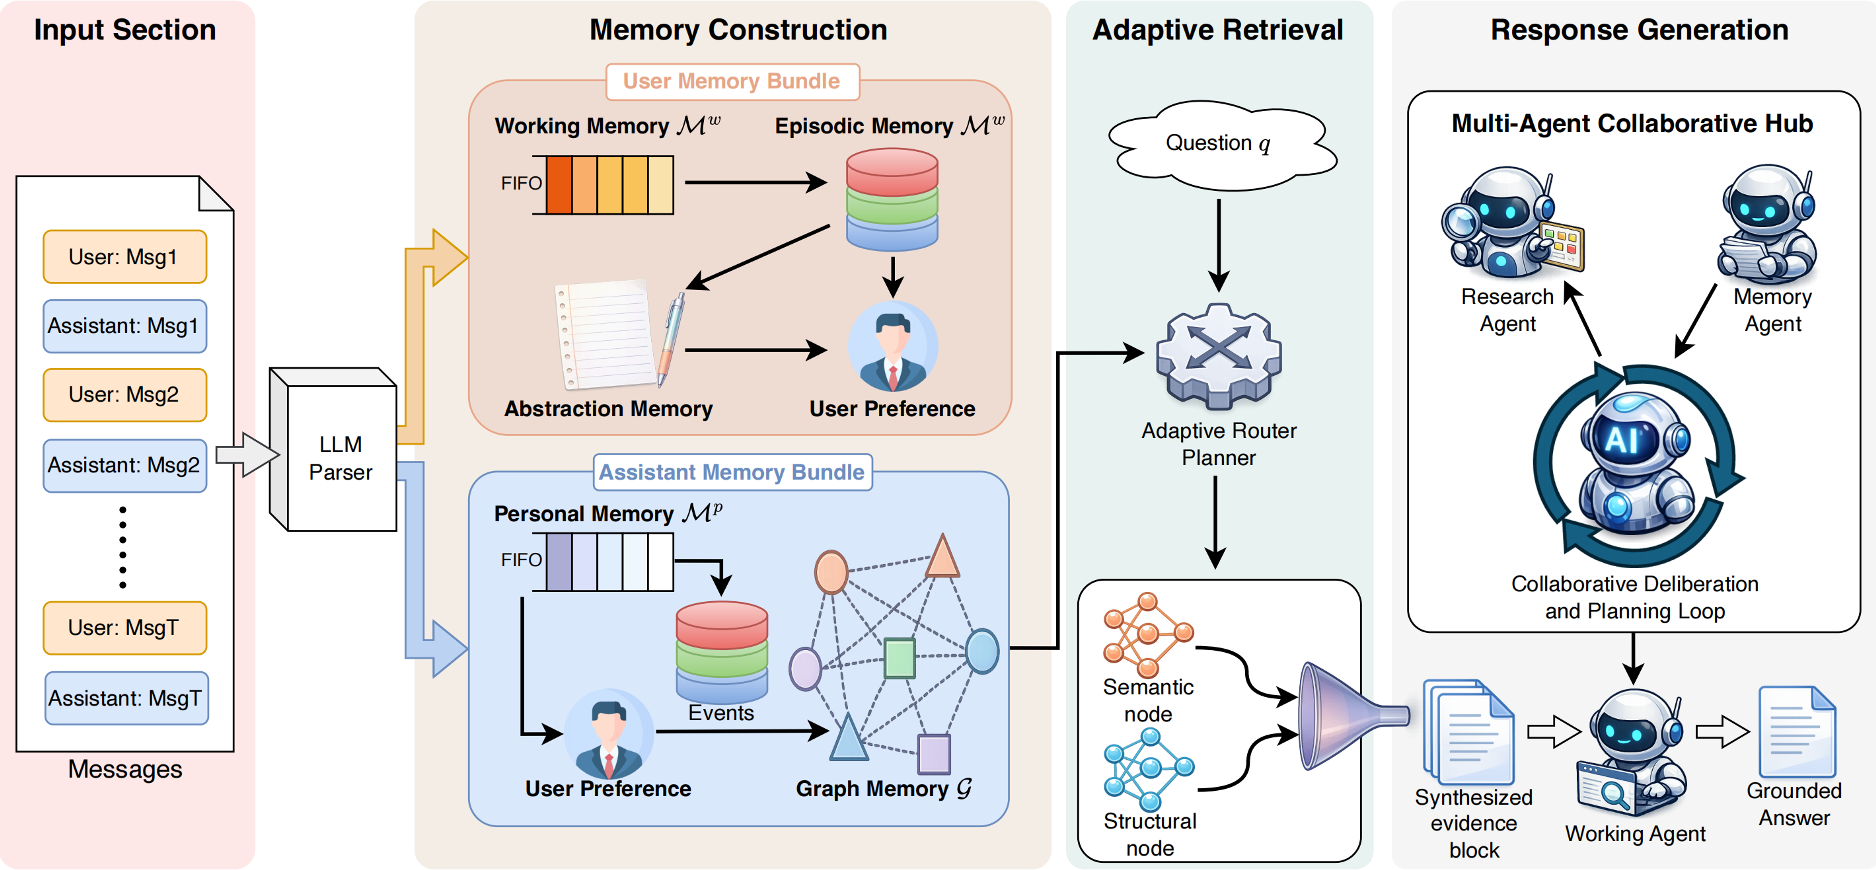
技术深度剖析:问题感知路由 (Question-Conditioned Retrieval)
AdaMem 的聪明之处在于它不会针对每个问题都动用昂贵的图检索。系统内置了一个路由规划器 (Route Planner):
- 如果是简单的实时事实查询,仅使用语义检索(Baseline)。
- 如果识别到“为什么”、“之后”、“关系”等关键词,则触发图谱扩展 (Graph Expansion),沿着
temporal_next或supports边寻找隐藏的关联。
这种“按需分配”的逻辑结合了三个专业智能体的协作:
- Memory Agent:负责日常的记忆整理与清洗。
- Research Agent:负责像侦探一样多轮搜索、整合证据。
- Working Agent:负责最后的端到端生成,确保回答简洁精准。
实验战果:全方位的 SOTA
在 LoCoMo 指标上,AdaMem 展示了降维打击般的逻辑链路重构能力。

关键发现:
- 消融实验:去掉 Graph Memory 后性能显著下降。这证明了在复杂推理中,关系边提供的价值远超单纯的向量距离。
- 时序推理:得益于
temporal_next边的设计,模型在处理“去年”、“在 A 之后发生的 B”这类问题时,召回率大幅领先。
深度洞察与总结
AdaMem 的成功标志着记忆系统正在从“存储层”向“认知层”进化。它不再是被动地存取文本,而是主动地维护各参与者(User & Assistant)的实体关系网。
局限性: 尽管 AdaMem 强大,但它的复杂度也带来了更高的 Token 成本和延迟(约 4.72s)。此外,正如论文中的失败案例所示,对于“隐含实体对齐”(例如将“那本书”关联到具体书名)以及更深层的符号化时间推理,模型仍有进步空间。
未来启示: 未来的 Agent 可能不再需要冗长的全量上下文,而是一个能够自我演进、自动进行事实归一化的结构化认知基座。AdaMem 为此提供了一个极具参考价值的工程范式。