
Adaptive Q-Chunking:让机器人学会“审时度势”地规划未来
Adaptive Q-Chunking for Offline-to-Online Reinforcement Learning
本文提出了 Adaptive Q-Chunking (AQC),一种针对离线到在线强化学习 (Offline-to-Online RL) 的自适应动作分块方法,通过在不同状态下动态选择最优的 Commitment Horizon,在 OGBench 和 Robomimic 等基准测试中达到了 SOTA 性能。
TL;DR
在机器人操作中,一成不变的规划周期(Horizon)往往意味着在精细操作时过于鲁莽,或在简单移动时过于迟钝。本文介绍的 Adaptive Q-Chunking (AQC) 通过一种创新的“优势对比”机制,实现了状态感知的动态分块选择:在自由空间大步流星(长分块),在接触瞬间小心翼翼(短分块),在复杂机器人操纵任务中刷新了 SOTA纪录。
痛点深挖:为何“一刀切”的规划会失效?
传统的强化学习(RL)要么每步重新决策(计算开销大,探索不连贯),要么固定执行一段动作序列(Action Chunking)。
作者敏锐地观察到,固定的分块大小存在本质矛盾:
- 接触动力学(Contact Dynamics):当机械臂尝试插入螺母或抓取物体时,微小的扰动会迅速发散。此时需要极高的反应速度(短分块)。
- 信用分配(Credit Assignment):在稀疏奖励场景下,长分块能让价值信号传播得更快,并产生更具物理一致性的探索(长分块)。
为什么不能直接对比不同长度的 Q 值? 数学上,由于折扣因子 的存在,较短路径的 值天生由于折扣更少而显得“更大”。这会导致智能体产生系统性偏差,永远倾向于选择最短的分块,从而失去了分块技术的初衷。
核心机制:AQC 的算法艺术
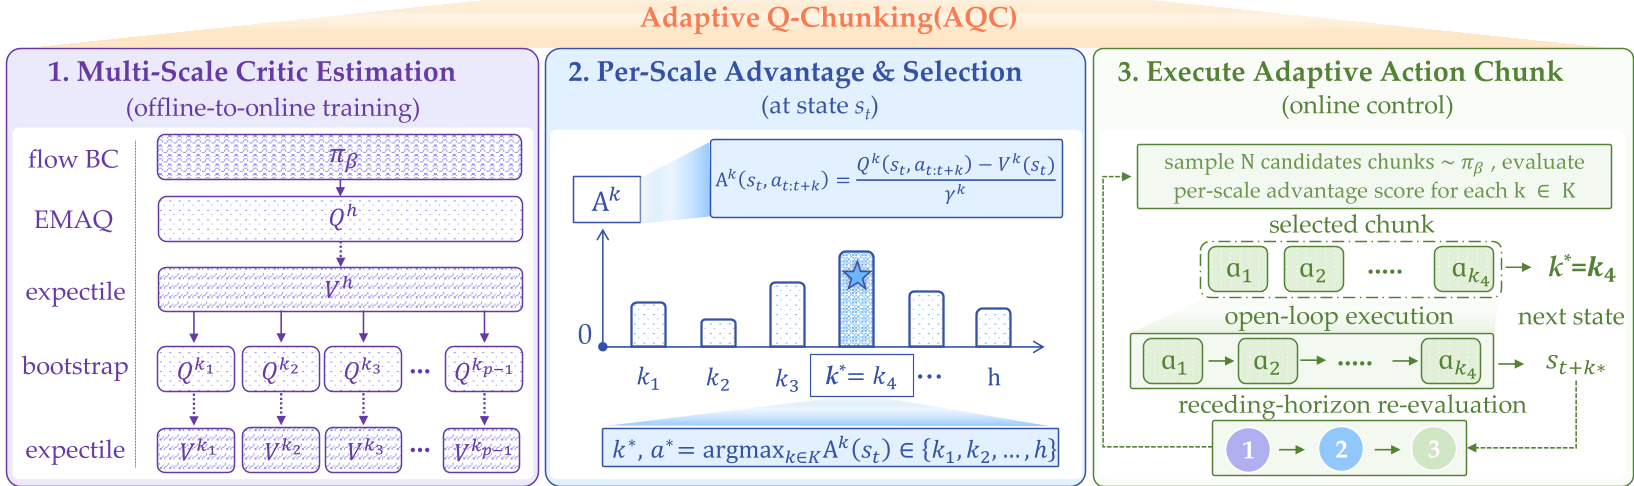
AQC 的核心在于:不比原始得分,比“进步程度”。
1. 优势驱动的选择准则
AQC 并不是直接挑选最大 Q 值的尺度,而是计算每个尺度 下的规范化优势: 这里 是行为策略在尺度 下的基准值。通过减去基准并除以折扣因子,AQC 消除了尺度的偏置,让 1 步规划和 25 步规划在同一“起跑线”上竞争。
2. 层次化 Bootstrap 训练
为了保证所有尺度的 Critic 逻辑自洽,作者设计了一个精妙的训练链:
- 主干网络:训练一个长程 。
- 分支网络:所有的短程偏 Critic () 都直接以这个长程 作为未来的目标。这种设计比传统的 1 步链式回传效率高出 倍。
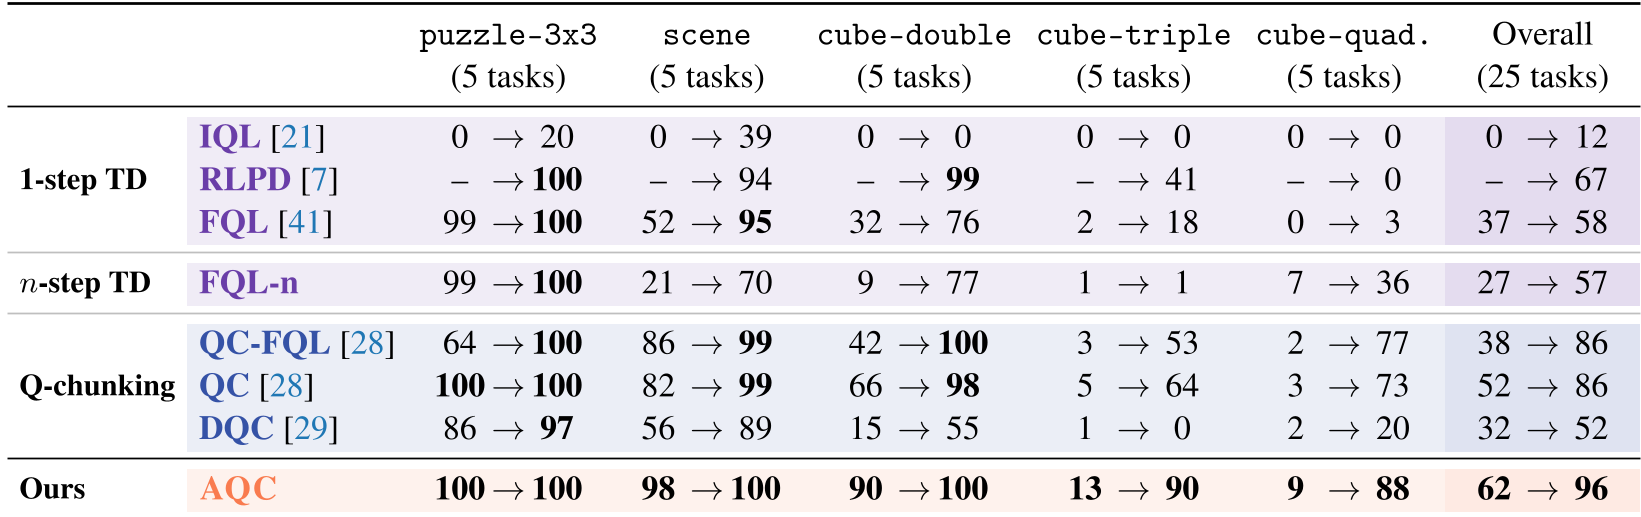
实验战绩:多维度的性能碾压
在 OGBench 的高难度序列任务(如四方块堆叠)中,AQC 展现了统治级的表现。
关键实验结果分析
- 灵活性验证:在 Robomimic 的
square(插桩)任务中,AQC 能够在接近插槽时自动收缩 Horizon,从而实现了极高的成功率提升。 - VLA 的“助推器”:将 AQC 接入 NVIDIA 或 Google 级别的 VLA 模型(如 GR00T)中,无需重新训练大模型底层,仅通过 Critic 筛选就能在复杂桌面任务上提升接近 16 个百分点。
深度洞察:不仅仅是加速
AQC 的成功不仅是一个工程上的技巧。从理论层面看,它解决了一个长期存在的难题:如何衡量不同时间抽象下的决策价值?
论文证明了:
- 噪声免疫性:在没有明确奖励信号的区域,优势选择器会退化为随机选择,而不是像传统方法那样产生由于函数近似误差导致的偏执(Bias)。
- 价值主导性:自适应策略在理论上严格优于任何固定分块策略。
总结与局限
AQC 为离线到在线 RL 提供了一个强大且优雅的工具。但它仍面临挑战,例如其候选分块集合 目前仍是预设的硬编码集合。未来的研究方向可能在于如何根据状态连续地、自动地生成最优的规划长度。
对于追求极致性能的工业级机器人方案,AQC 提供的这种“在自由中加速、在接触中静谧”的动态思维,无疑是通向通用机器人(Generalist Robot)的重要基石。