
BLF:当 LLM 拥有贝叶斯大脑,预测表现何以超越“超级预测者”?
Agentic Forecasting using Sequential Bayesian Updating of Linguistic Beliefs
本文推出了 BLF (Bayesian Linguistic Forecaster),一种专门用于二元事件预测的智能体系统。该系统通过结构化语言信念更新、多路径预测聚合及层次化校准机制,在 ForecastBench 榜单上超越了 GPT-5 和人类超预测者中位数,刷新了 SOTA 纪录。
TL;DR
如何在充斥着谣言和不确定性的互联网信息中拨云见日,精准预测未来?Google Research 的科学家们(包括 Kevin Murphy 等)推出了 BLF (Bayesian Linguistic Forecaster)。它不再只是简单地“问”模型一句话,而是构建了一个能够自我更新信念、多路径思辨、并能自动进行统计校准的智能体。实验证明,它不仅刷爆了 ForecastBench 榜单,还成为了首个在市场预测上稳赢“群众智慧(Crowd)”且媲美人类超级预测者的 AI 系统。
预测者的紧箍咒:为什么 LLM 以前算不准?
传统的 LLM 预测往往面临两个死穴:
- 证据过载与遗忘:把几百页搜索结果直接塞进 Context,LLM 很快就会失去焦点。
- 迷之自信:LLM 倾向于给出一个极端的 0 或 1,缺乏对概率的敬畏感,这在统计学上被称为“校准度差”。
作者的 Insight 非常直觉:预测本质上是一个贝叶斯更新过程。你需要先有一个先验(Base Rate),然后根据新证据(Evidence)不断修正你的信念(Belief),而不是看一眼搜索网页就盲目下结论。
核心方法:BLF 的三大支柱
1. 语言信念状态 (Linguistic Belief State)
这是 BLF 的“灵魂”。智能体在每一步 Tool-use 循环中,都会输出一个 JSON 对象,包含:
- 当前概率 :对结果的数值判断。
- 证据摘要:正方与反方的核心观点。
- 待解决问题:指导下一步该搜什么。
这种做法有效地将预测逻辑从冗长的上下文里解耦出来,就像一个老练的调查员在笔记本上不断勾画重点,而不是试图记住所有听过的传闻。
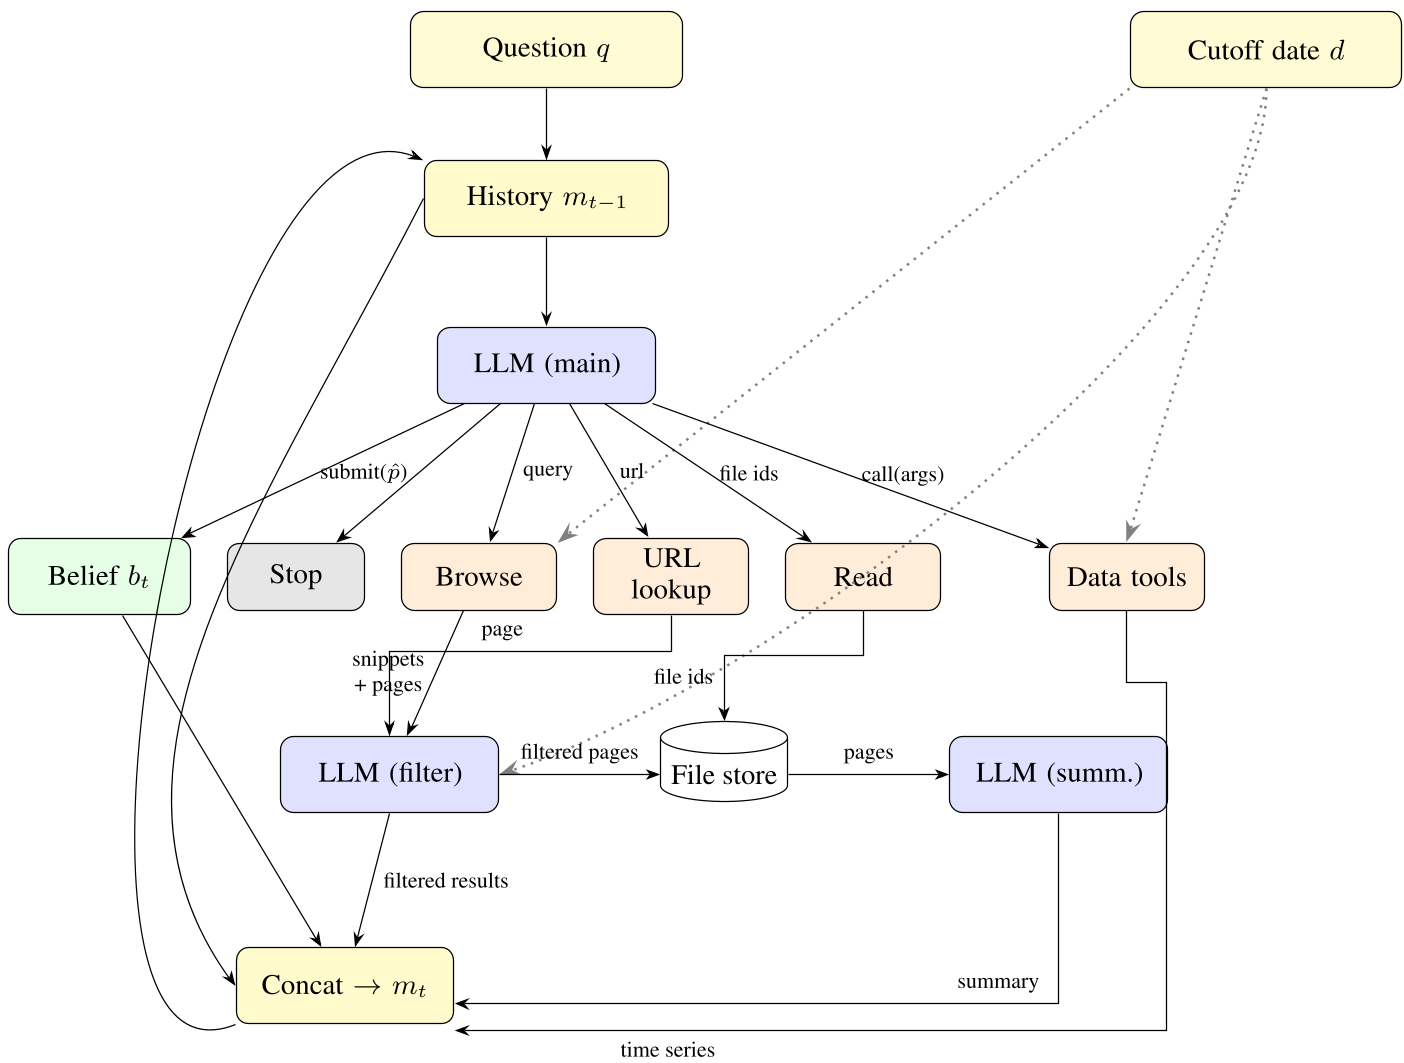 图 1: BLF 智能体循环。LLM 在每一步同步更新信念 并选择下一个动作 。
2. 多路径聚合 (Multi-trial Aggregation)
单次运行 LLM 存在极大的随机性。BLF 运行 5 个独立进程,并在 Logit 空间 进行平均。为了防止其中一个进程带偏整体,系统引入了类似 James-Stein 的收缩估计,当不同进程产生严重分歧时,系统会自动将预测值拉回 0.5(表示不确定)。
3. 层次化校准 (Hierarchical Calibration)
预测出的原始概率往往带有偏差。BLF 采用了层次化 Platt 缩放。它不仅学习全局的校准曲线,还会针对不同数据源(如来自 Wikipedia 的实时数据或来自 FRED 的经济指标)学习特定的“偏移量”。
战绩评估:突破“群众之声”
在包含 400 个实战预测问题的 ForecastBench 上,BLF 展现了统治级的表现:
- 击败 SOTA:显著优于 Cassi, GPT-5 和 Grok 4.20。
- 击败基准:在市场问题上,BLF 的 Brier Index 达到 85.2。值得注意的是,其他所有知名 AI 模型在面对市场价格(Crowd Signal)时,都无法实现显著超越,只有 BLF 做到了。
- 媲美人类:BLF 的难度调整 Brier 指数 (ABI) 为 71.0,几乎完美对齐了人类超级预测者的中位数 (70.9)。
 表 1: BLF 与 SOTA 方法在市场和数据集任务上的对比。可以看到 BLF 在各项指标上均处于压倒性优势。
深度洞察:为什么这种范式有效?
通过消融实验,作者揭示了一个令人惊讶的事实:维护一个结构化的信念状态,其提升效果(-3.0 BI)竟然直逼接入 Web 搜索本身(-4.6 BI)。这意味着在复杂的推理任务中,“如何思考”比“看到什么”更重要。
此外,作者展示了一个有趣的案例:在预测“Trump 重命名墨西哥湾为美国湾”这一事件时,不同的 Trial 路径展示了贝叶斯更新的魅力。有的 Trial 发现相关行政命令后概率飙升,但有的 Trial 进一步挖掘发现 WorldAtlas 采用的是静态地图,更迭周期长达 1-3 年,从而冷静地给出了“No”的预测(如图 2)。
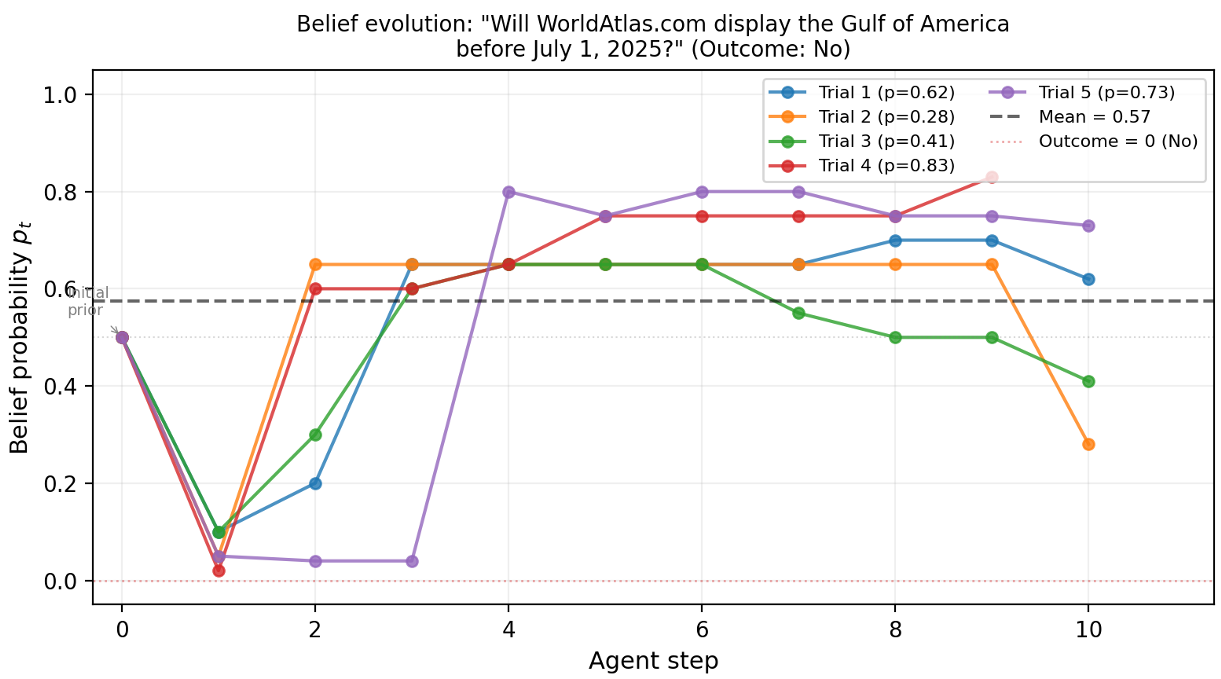 图 2: 不同实验路径的信念演化趋势,体现了多路径博弈对最终一致性的重要性。
总结与启示
BLF 的成功标志着 LLM 正在从“生成式玩具”向“高可靠决策工具”迈进。其核心价值在于提供了一套将不可靠的 LLM 原始推理转化为可靠概率输出的工程协议。
对于未来的智能体开发,这篇论文给出了明确的信号:不要指望更大的 Context Window 能解决一切,构建显式的、可解释的信念状态更新机制,才是通往 AGI 推断能力的正确道路。
局限性注记:目前 BLF 对纯数值类(如股票随机游走)的预测仍面临巨大挑战。未来可能需要将符号推理与更强的统计模型(如时间序列专门模型)集成,而不仅仅是依赖 LLM 的常识判断。