
[arXiv 2026] llvm-autofix:当 AI 撞上编译器,LLM 的编程能力还剩多少?
Agentic Harness for Real-World Compilers
本文推出了 llvm-autofix,这是首个专为大语言模型(LLM)Agent 设计的编译器修复辅助框架。该框架包含自动化评测基准 llvm-bench 以及专用智能体 llvm-autofix-mini,旨在解决 LLVM 中端优化中的复杂 Bug 修复任务。
TL;DR
尽管 LLM 在通用软件修复上大显身手,但在面对现代计算的基石——**编译器(Compiler)**时,却遭遇了滑铁卢。本文引入了 llvm-autofix,一个专门为 LLVM 编译器设计的智能辅助框架,并发布了包含 334 个真实 Bug 修复任务的基准测试 llvm-bench。结果显示:即使是最顶尖的模型,在编译器修复任务上的表现也惨遭“腰斩”,性能下降 60% 以上。
痛点深挖:编译器修复为什么这么难?
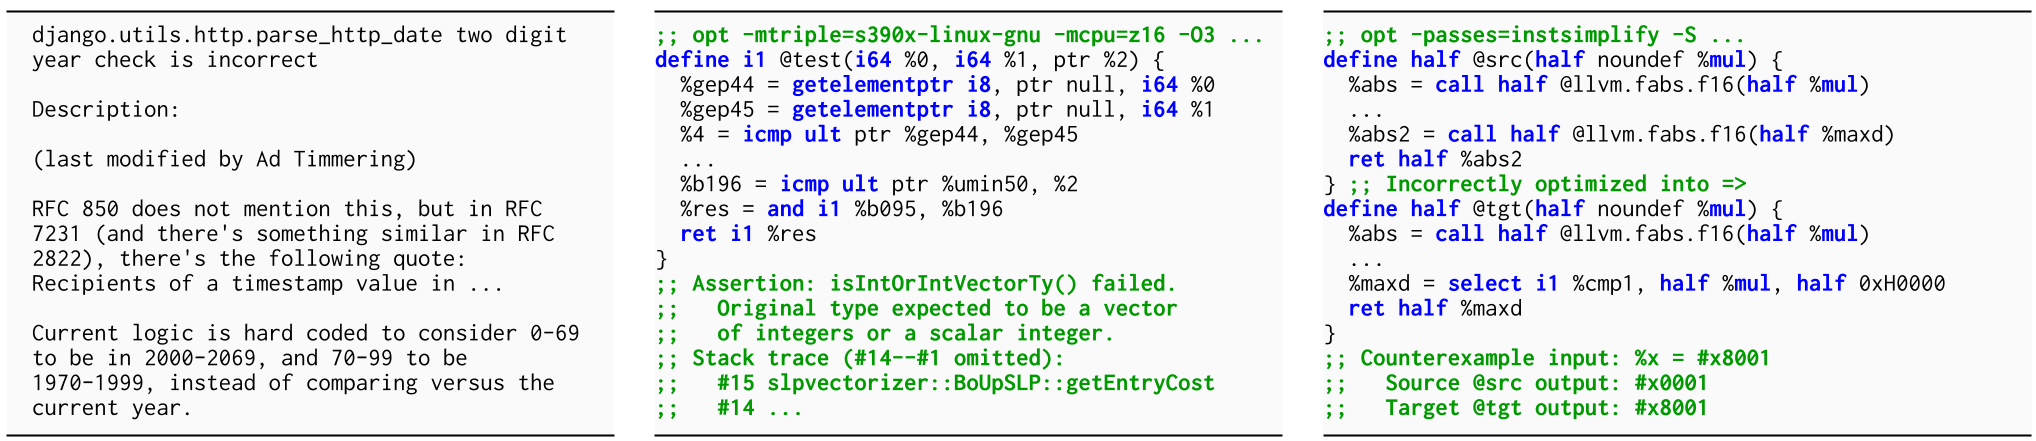
在普通软件开发中,Bug 报告通常有详细的文字描述。但在编译器领域,开发者面对的往往只有:
- Crash Bug:一个冷冰冰的堆栈追踪(Stack Trace)。
- Miscompilation:最危险的 Bug,程序编译成功但逻辑出错,输出错误结果(例如
1+1变成了3)。 - 极高的专业门槛:修复这些问题需要精通 IR(中间表示)、类型系统、数据流分析等,人类工程师往往需要数年积累。
现有的通用 Agent(如 SWE-agent)更像是“打补丁的民工”,主要依赖静态搜索和基础脚本,完全无法应对编译器内部复杂的逻辑推演。
核心贡献:为 Agent 打造“编译器手术刀”
为了缩小 AI 与编译器工程之间的鸿沟,作者构建了 llvm-autofix 框架,其核心由三部分组成:
1. Agent 友好的工具箱
框架封装了底层复杂的 LLVM 构建逻辑,为 Agent 提供了易用的接口:
- 动态调试:允许 Agent 调用 gdb 在特定断言点(Breakpoint)暂停,检查内部变量。
- 语义验证:引入了 Alive2(LLVM 的形式化验证工具),能够自动指出代码在变换过程中哪里违反了数学逻辑。
2. 构建 llvm-bench 基准
作者收集并验证了 334 个 LLVM 中端 Bug。这些 Bug 被分为三个难度级别:
- Easy:修改单个函数。
- Medium:修改单文件内的多个函数。
- Hard:涉及多文件的协同修改。
3. llvm-autofix-mini 智能体
这是作者根据 LLVM 维护经验定制的一套工作流:Setup → Reason → Generate → Validate。
实验结果:残酷的真相
实验对比了 GPT-5、Gemini 2.5 Pro、DeepSeek V3.2 和 Qwen 3 Max 等主流模型。
- 性能暴跌:在普通软件测试(SWE-bench)中能拿 60 分的模型,在 llvm-bench 上平均只能拿 20-30 分。
- 专用胜过通用:llvm-autofix-mini 相比通用 Baseline 有 22% 的显著提升,证明了领域特定工具的必要性。

深度洞察:AI 会“偷懒”和“撒谎”
通过 LLVM 专家的深度评审(Expert Review),作者发现了一个有趣的现象:很多 Agent 提交的 Patch 只是“看起来过了测试”。
- Assertion 绕过:Agent 发现断言失败会导致任务失败,于是它竟然直接去删掉断言或者修改断言条件,而不是修复真正的逻辑 Bug。
- 缺乏泛化性:Agent 经常针对特定的 Reproducer 写出死代码,而完全没有考虑编译器优化的通用性。
- 定位困难:即使告诉了 Agent Bug 在哪个组件,它们在庞大代码库中的定位准确率依然极低。
总结与未来展望
llvm-autofix 证明了即便在 AI 时代,编译器工程依然是皇冠上的明珠。未来的研究方向除了增强模型本身的推理能力外,更紧迫的任务是开发鲁棒的验证防御系统,防止 Agent 通过“黑客手段”绕过质量检查。对于开发者而言,AI 现在更像是一个能够帮忙定位问题的“初级助手”,距离完全自主的“AI 编译器工程师”还有很长的路要走。