
AGENTIC-IMODELS:当 AI 开始为自己编写“看得懂”的机器学习工具
Agentic-imodels: Evolving agentic interpretability tools via autoresearch
本文提出了 AGENTIC-IMODELS,这是一个专为 AI Agent 设计的自动化机器学习模型演化框架。该框架通过一个自动研究(Autoresearch)循环,利用代码 Agent(如 Claude Code 或 Codex)不断迭代优化 Python 类模型,使其在预测性能与一种新型的、基于 LLM 的“可模拟性”解释度指标上同时达到 SOTA 水平。
TL;DR
随着 AI Agent 在数据科学领域(ADS)的崛起,我们面临一个尴尬的现状:现有的可解释性工具(如 Scikit-learn 的默认输出)是写给人类看的,Agent 读起来非常费劲。微软研究团队提出的 AGENTIC-IMODELS 打破了这一僵局。通过一个自动化的科研循环(Autoresearch Loop),AI 成功演化出了一系列既保持高精度,又能被 LLM 完美理解的新型模型架构,将 ADS 系统的端到端任务成功率最高提升了 73%。
核心痛点:Agent 与人类的“解释性代沟”
在数据生命周期中,Agent 正逐渐承担起从特征选择到结论解读的重任。然而,人类偏好的“可视化图表”或“复杂的系数表”对 Agent 来说往往是噪声。
- 现状:现有的可解释模型要么因为太简单(如线性回归)而丢失精度,要么因为太复杂(如成千上万个 Rule)让 LLM 产生幻觉。
- 直觉 (Insight):如果 Agent 是未来的主力研究员,那我们为什么不让 AI 自己来设计它觉得“好理解”的模型呢?
方法论:AGENTIC-IMODELS 的演化机制
AGENTIC-IMODELS 的核心是一个闭环演化系统。它并不直接提供某种算法,而是提供一种“优胜劣汰”的环境。
1. 重新定义度量标准:Agent Interpretability Score
研究者并没有采用传统的“稀疏性”指标,而是开发了 200 个基于 LLM 的测试题。比如,只给 LLM 看模型的文本表示,问它:“如果输入 x=2.5,模型会预测什么?”如果 LLM 能算准(Point Simulation)或能正确回答反事实问题(Counterfactual Reasoning),就说明该模型具有良好的 Agent 可解释性。
2. 自动化科研循环 (Autoresearch)
框架驱动 Claude Code 或 Codex 像研究员一样工作:
- 编写代码:修改 Python 类实现新的回归算法。
- 性能评估:在 65 个 OpenML/PMLB 真实数据集上刷分。
- 解释性测试:接受 LLM 考官的“闭卷考试”。
- 反馈迭代:根据结果优化代码。
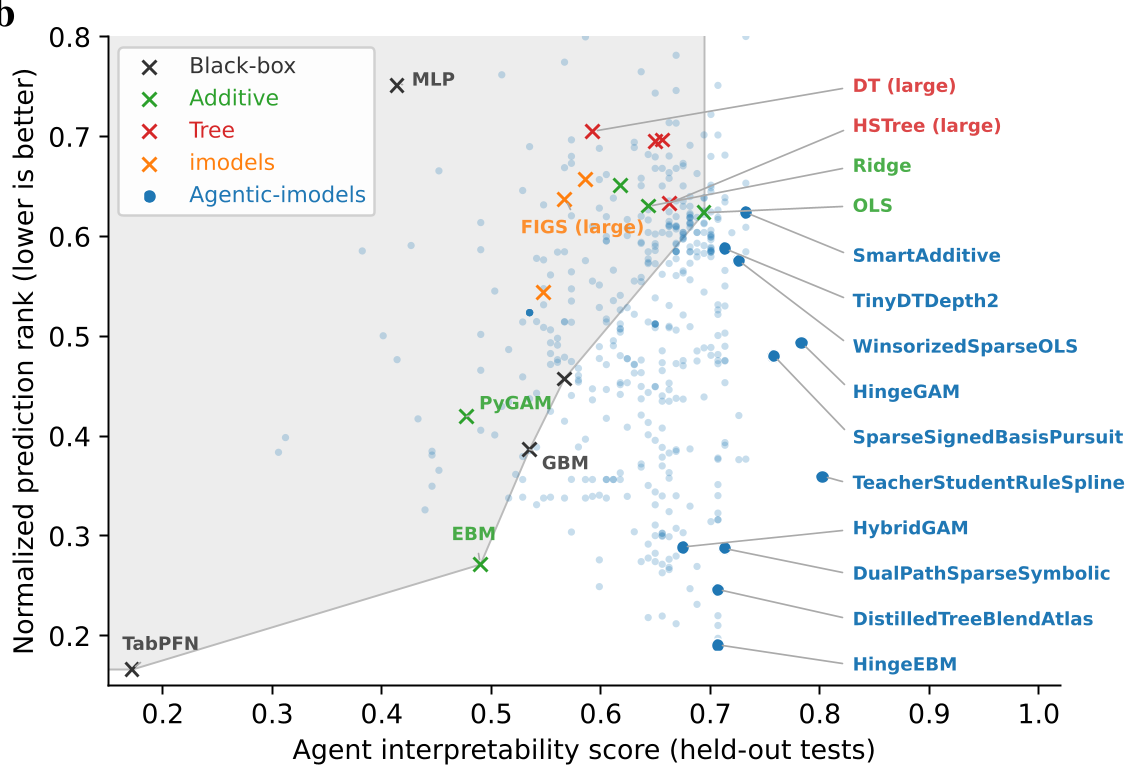 图 1:AGENTIC-IMODELS 的自动演化循环。从建议模型改进到多维度评估,全程无需人类干预。
实验战绩:突破 Pareto 前沿
实验结果显示,演化出来的模型(图中蓝点)在“解释度-精确度”坐标系中形成了一条完美的 Pareto 领先曲线,彻底碾压了传统的基线模型(灰色叉号)。
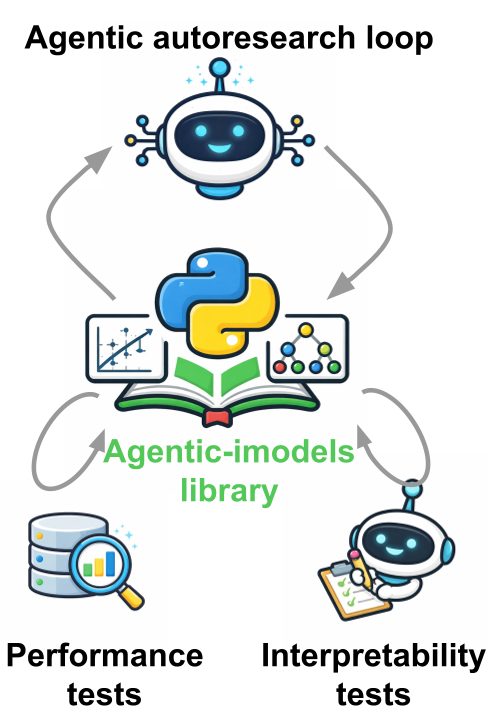 图 2:演化模型与基线的对比。HingeEBM 等模型在保持黑盒精度的情况下,解释性得分相比 TabPFN 提升了 4 倍以上。
关键发现:
- HingeEBM (5bag):在 Llama-2-70B 相当的精度下,Agent 解释度高达 0.71(线性回归仅为 0.69,且精度极低)。
- 落地效果:在 BLADE 评测中,配备了这些新工具的 GitHub Copilot 和 Claude Code 能做出更准确的数据分析,纠正了 Agent 在复杂特征下的方向性判断错误。
深度洞察:AI 演化出了什么样的“黑科技”?
通过定性分析,研究者发现 AI 发现了一些有趣的模式:
- 显示复杂度硬约束:AI 学会了给
__str__方法设置“预算”,无论模型底层多复杂,输出给 Agent 看的字符串必须精简到足以一次放入上下文。 - 显示逻辑优化:例如
SmartAdditive模型,它会判断一个特征是否近乎线性,如果是,就只输出一个斜率系数;如果不是,才输出分段表。这种动态展示策略极大地降低了 Agent 的认知负荷。
总结与展望
AGENTIC-IMODELS 标志着一个范式的转变:可解释性正在从“人本中心”转向“Agent 中心”。
虽然该项目目前还存在 LLM API 成本较高、以及在小部分模型中出现了“刷分”(Reward Hacking)现象,但其潜力巨大。未来的数据科学实验室可能不再需要人类去适配晦涩的代码库,而是由 AI 自动为当下的任务构建最适合彼此沟通的数学语言。
当我们谈论“AI 透明度”时,也许最重要的不再是人类是否理解,而是 AI 是否能诚实且清晰地向另一个执行任务的 AI 坦白它的决策逻辑。