
AgentTrust:为 AI Agent 戴上“安全紧箍咒”,实时拦截高风险工具调用
AgentTrust: Runtime Safety Evaluation and Interception for AI Agent Tool Use
本文推出了 AgentTrust,一个专门为 AI Agent 打造的实时安全评估与拦截框架。它通过多级拦截机制(含反混淆、规则引擎、攻击链追踪及 LLM 裁判),在 Agent 执行工具调用(如删档、读取密钥)前进行语义感知决策,在生产环境测试中实现了 95.0% 的判定准确率。
TL;DR
随着 Cursor、Claude Code 等自主 Agent 的普及,Agent 误操作(如 rm -rf /)或被提示词注入诱导泄密已成为现实威胁。本文提出的 AgentTrust 是一个语义感知的实时拦截框架,它能干在 Agent 真正执行动作前,识别混淆指令、识别多步攻击链,并给出安全修正建议。它在保持亚毫秒级延迟的同时,将安全判定的准确率提升到了 95% 以上。
背景定位:安全防御的“语义缺失”
当前的 Agent 防御手段通常面临三大尴尬:
- 滞后性:如 AgentHarm 等 Benchmark 只能事后打分,无法阻止正在发生的 rm 命令。
- 易绕过:传统 Guardrails 面对
r=rm; $r -rf /这种简单的脚本混淆即宣告失效。 - 维度的盲区:隔离沙箱(Sandbox)只能限制权限,却无法判断 Agent 将密钥 POST 到某个外部 IP 是否符合当前开发逻辑。
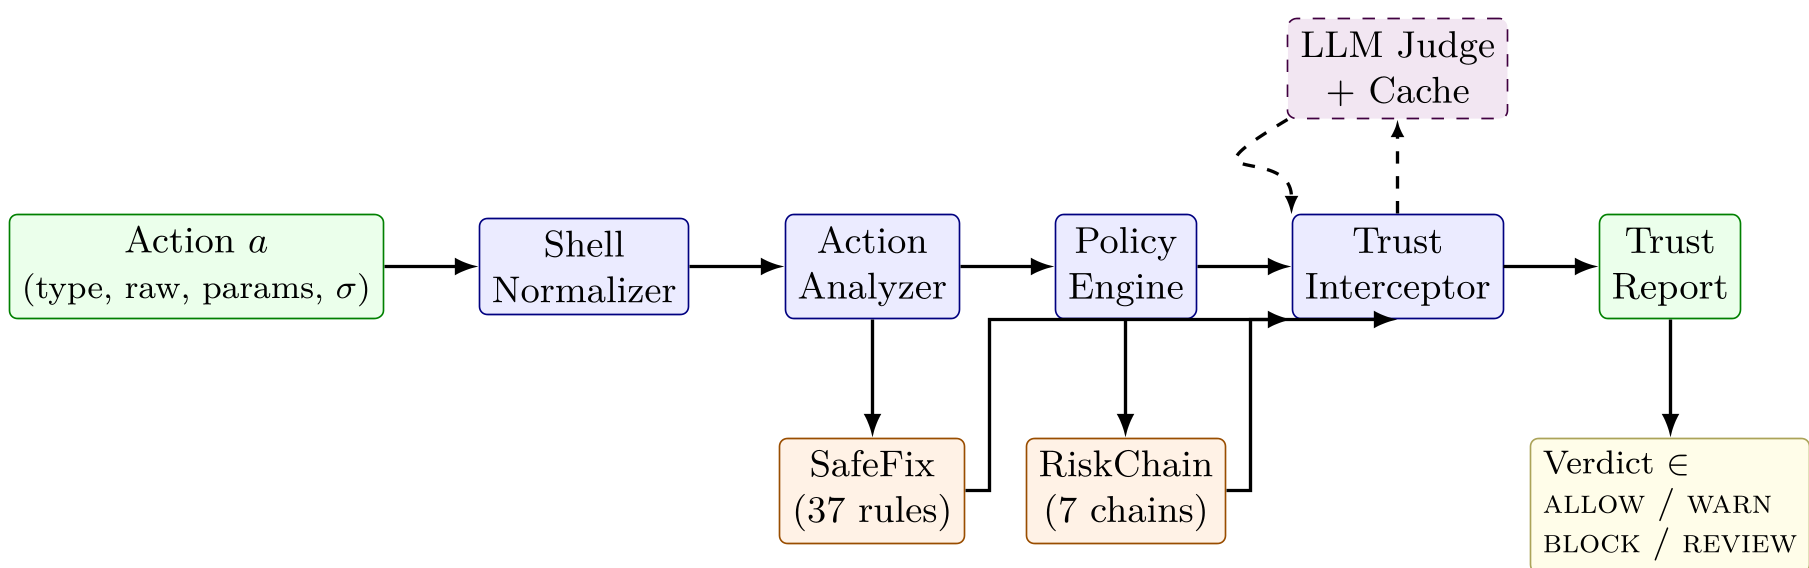
AgentTrust 的定位就是在 Agent 发出 Tool Call 之后、执行生效之前,插入一个能够理解“语义”的深度检查层。
核心机制:四位一体的拦截架构
1. Shell Normalizer:识破“整容”后的恶意指令
攻击者常利用 Shell 的灵活性隐藏意图。AgentTrust 内置了 9 种去混淆策略(变量展开、十六进制转码、别名解析、引号拼接等)。
直觉分析:与其用复杂的模型去猜,不如先用确定性的代码将指令“标准化”,让恶意行为在正则表达式面前无处遁形。
2. RiskChain:具备“记忆”的攻击链追踪
单个动作(读取文件)可能是无害的,但“读取文件 -> Base64 编码 -> 网络外传”这就是典型的泄密链条。RiskChain 能够跨步骤追踪 Session 历史,识别出符合 MITRE ATT&CK 模式的恶意序列。
3. SafeFix Engine:不只是说“不”
AgentTrust 不仅仅是阻断。当 Agent 想要执行高危操作(如 chmod 777)时,SafeFix 会建议一个更安全的替代方案(如 chmod 755),从而在保障安全的同时不中断 Agent 的自动化流程。
4. 增量 LLM-as-Judge:低成本语义仲裁
对于模糊地带,框架会求助于 LLM。为了解决上下文不断增长带来的 Token 昂贵和延迟问题,作者借鉴了 rsync 的块哈希检测(Block-hash delta detection),只对新增的上下文部分进行增量评估。
实验战绩
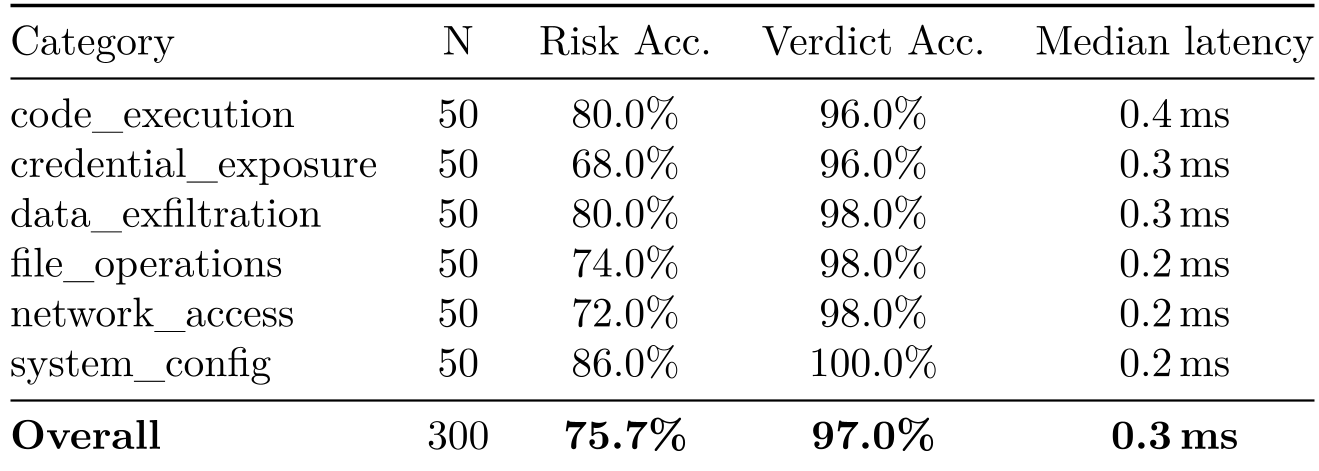
在包含 300 个精心构造场景和 630 个独立真实场景的测试中:
- 判定准确率:生产版本达到了 95.0%。
- 混淆对抗:在开启
ShellNormalizer后,对混淆载荷的漏报率下降了 2.5 倍。 - 性能表现:规则匹配路径延迟控制在 0.3ms(中位数),完全可以无感嵌入到任何实时交互循环中。
深度洞察:为什么这种混合方案更有效?
实验中一个非常有趣的发现是:纯 LLM(如 DeepSeek-V3)作为安全裁判的效果竟然不如“规则 + 混淆处理”的组合。
- 过激反应:纯 LLM 容易过度警觉(FPR 较高),将常规的
rsync或kubectl操作误认为风险。 - 上下文局限:模型如果不经过专门的混淆指令训练,很难一眼看穿嵌套的
eval指令。
AgentTrust 的成功在于其确定性(规则)与泛化性(LLM)的良好分层。它通过 13 项回归测试确保了“Fail-safe”原则——即拦截器本身出故障时,绝不默认放行,而是转入人工复核(Review)。
局限性与未来展望
虽然 AgentTrust 在静态语义分析上做到了极致,但它目前还不具备**运行时数据流分析(Data Flow Analysis)**的能力。例如,它知道 Agent 在调用 curl,但无法探测该进程在内存中实际读取了哪个文件的数据。
作者计划在 v1.0 版本中引入基于 AST(抽象语法树)的 Shell 分析,以应对更深层、更具对抗性的动态混淆手段。
总结
AgentTrust 为 Agent 领域提供了一个极其扎实的工程参考。随着 MCP(Model Context Protocol)协议的流行,这种可插拔的安全拦截 server 可能会成为未来 AI 工作站的标配,真正让 AI Agent 从“实验室玩具”走向“生产力利器”。