
AgentV-RL:从简单评分到深度审计,重塑 LLM 的推理“指南针”
AgentV-RL: Scaling Reward Modeling with Agentic Verifier
本文提出了 AgentV-RL,一种利用 Agentic Verifier(代理验证器)增强大语言模型推理的研究框架。该方法通过将奖励建模(Reward Modeling)转变为多轮且具备工具调用能力的代理协作过程,在数学推理任务中显著优于传统的 ORM 和 PRM。
TL;DR
验证器(Verifier)一直是 LLM 推理能力的“第二大脑”。然而即便最强的验证器也会被看似逻辑自洽的错误答案所误导。复旦大学等机构提出的 AgentV-RL 框架,通过引入由“正向/反向代理”构成的双向审计机制,配合 Python 外部工具,将原本盲目“打分”的奖励模型转化为具有严密逻辑思维的“独立审计师”,在 4B 参数量级下实现了对 70B 模型的跨代跨度超越。
痛点深挖:验证器的“降智”时刻
在 Test-Time Scaling (TTS) 范式中,模型生成的解法质量很大程度上取决于验证器的判断。但现有的 ORM(结果级奖励模型)和 PRM(过程级奖励模型)存在两大致命伤:
- 错误传播 (Error Propagation):验证器往往会被原本错误的解法引导,产生“盲目认同”。
- 外部对齐缺失 (External Grounding):面对复杂的数值计算或知识密集型任务,验证器自身也会产生幻觉。
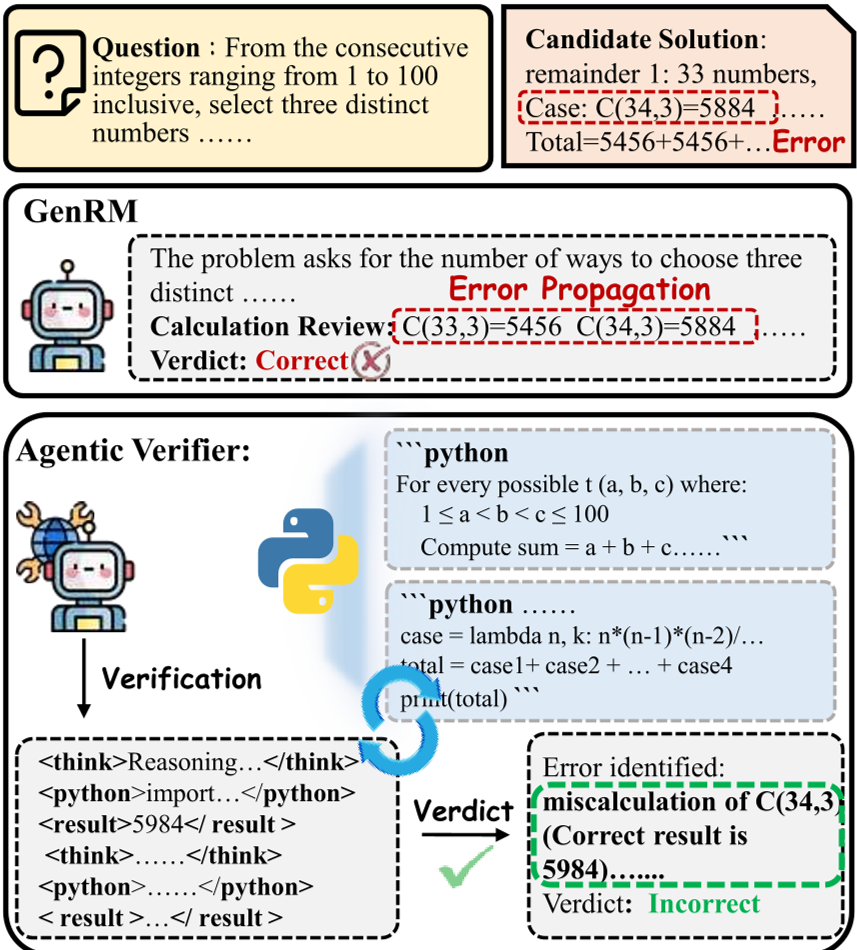 如图 1 所示,普通 GenRM 容易迷失在错误的解法路径中,而 Agentic Verifier 则通过严密的双向审核发现问题。
方法论:正反合一的双向代理架构
AgentV-RL 的核心在于将验证任务解构为三种阶段:计划(Plan)-> 验证(Validate)-> 判定(Verdict)。
1. 正向代理(Forward Agent):充分性检查
类似于老师批改作业,从题目给出的前提(Premises)出发,逐步检查每一步推导是否严谨。它会调用 Python 解释器来验证每一步的算术准确性。
2. 反向代理(Backward Agent):必要性检查
这是一种更高阶的数学直觉——“逆向求证”。它从结论出发,反向审计前提条件是否为结论的必要来源,从而识别出那些“答案凑对了但逻辑跳跃/缺失”的假阳性样本。
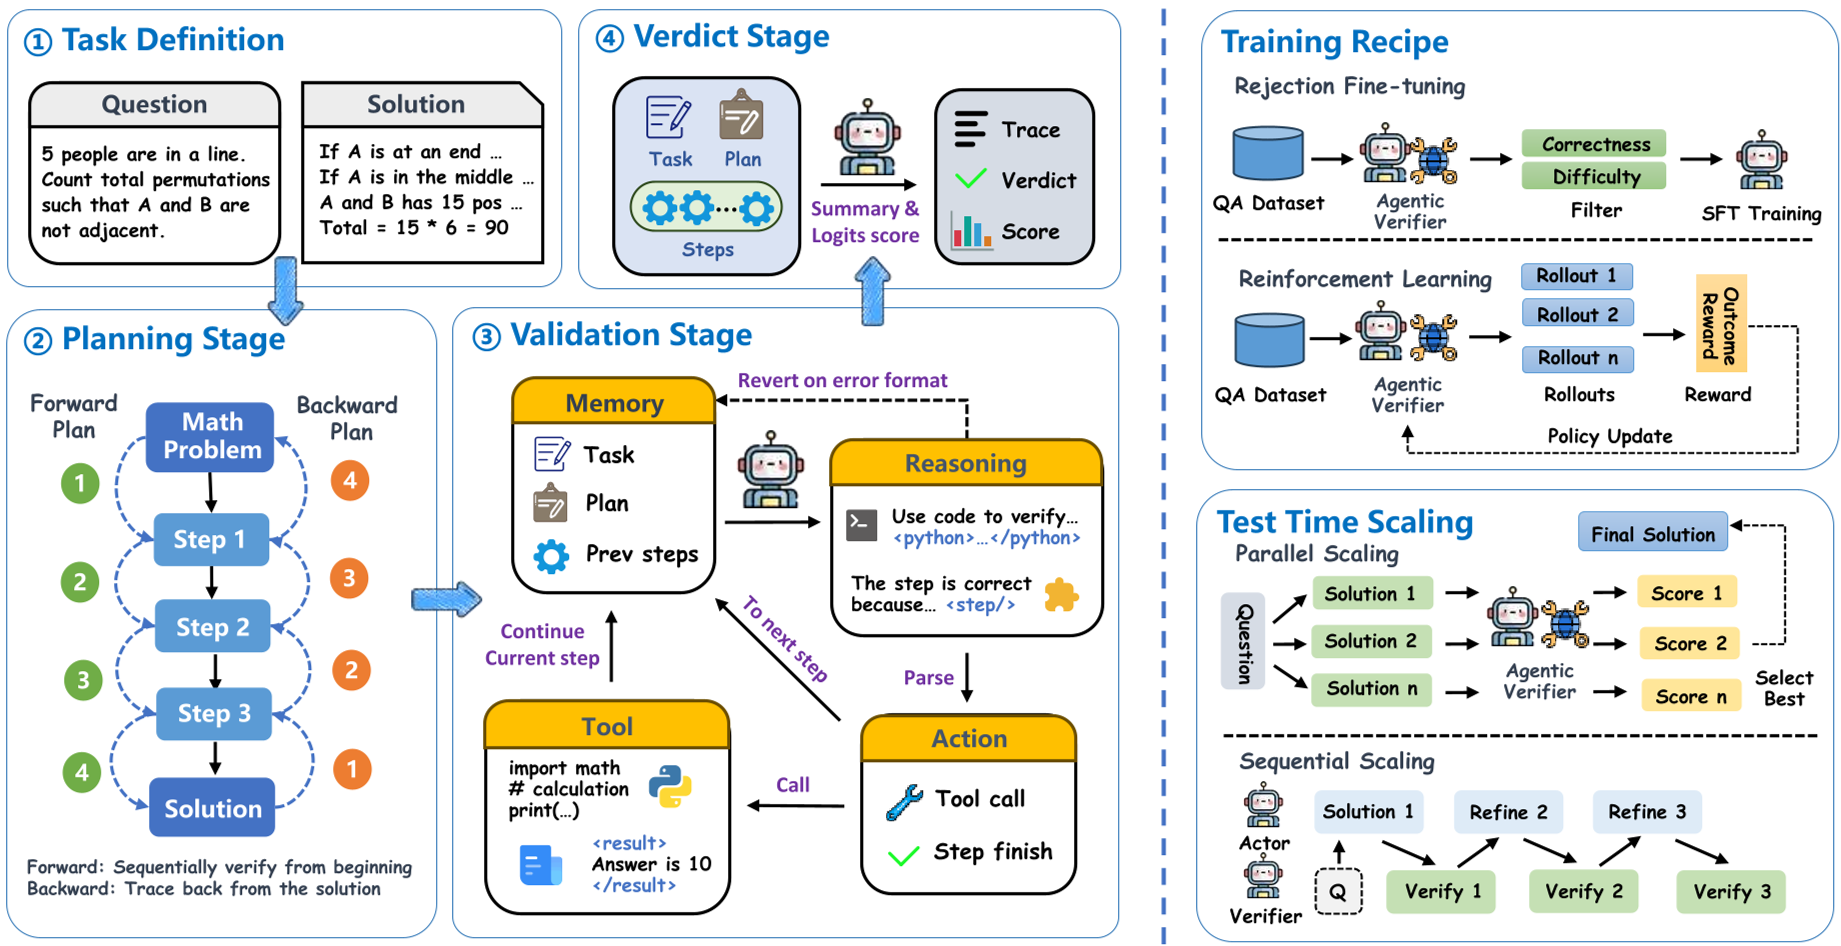 AgentV-RL 的多轮迭代与工具增强架构。
实验与结果:小参数战胜巨兽
在 Best-of-N (BoN) 实验中,基于 Qwen3-4B 的 Agentic-Verifier 展示了恐怖的战斗力:
- 在 MATH500 任务中高达 79.0% 的准确率,轻松碾压参数量大其 10 倍以上的 INF-ORM-Llama3.1-70B。
- 在 AIME24 等竞赛级难题中,随着推理步数 N 的增加,模型表现出极强的缩放能力(Scaling Law)。
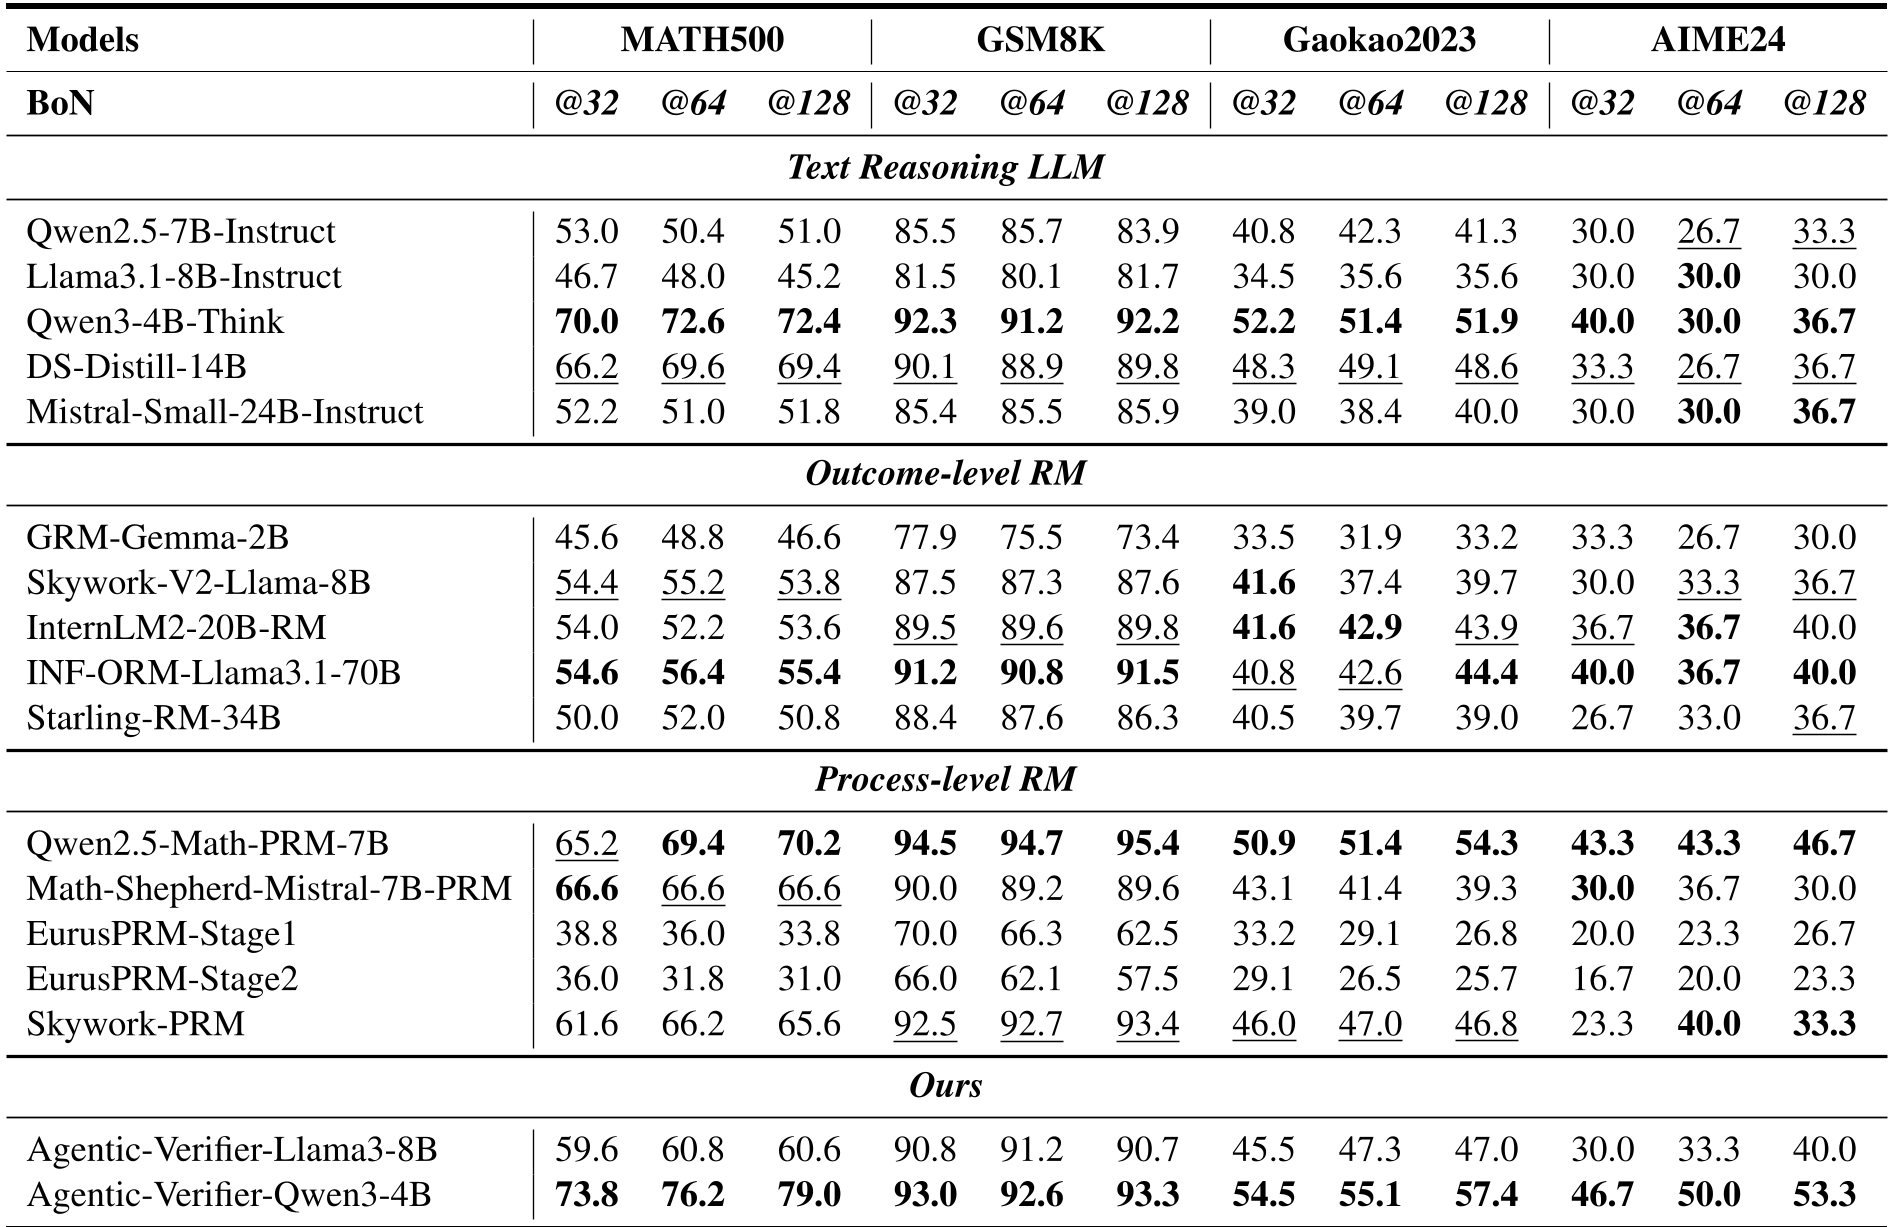 表格 1 展示了 Agentic Verifier 在多个榜单上全面超越现有 SOTA 模型。
深度洞察:为什么它更强?
- 双向协同的化学反应:消融实验证明,正向和反向代理在识别错误时具有互补性(Synergistic)。
- RL 释放的推理潜力:通过 GRPO(Group Relative Policy Optimization)强化学习,验证器学会了主动探索和利用工具,而非被动地进行下一步预测。
- 迭代修复的导师效应:作为反馈提供者(Turn 1/2/3),它产生的批评建议显著加速了 Actor 模型自我更正的速度。
总结与局限
AgentV-RL 的出现标志着奖励建模进入了“代理化”时代。它不再是一个黑盒打分机,而是一个可以对话、可以写代码验证、可以反复推敲的审计助手。
不足之处在于其推理成本较高(Token 量和延迟显著增加),如何平衡审计的精度与算力成本,将是未来走向端侧或大规模部署的关键瓶颈。