
AGPO:拒绝推理平庸——京东提出非对称群体策略优化,攻克 LLM “推理边界收缩”难题
AGPO: Asymmetric Group Policy Optimization for Verifiable Reasoning and Search Ads Relevance at JD
本文提出了 AGPO(非对称群体策略优化),一种旨在解决强化学习验证奖励(RLVR)中“推理边界收缩”问题的算法。通过非对称的优势估计和负样本主导策略,AGPO 在数学推理(MATH, AIME)及京东搜索广告场景中均达成 SOTA 性能。
TL;DR
在强化学习(RLVR)领域,我们常面临一个尴尬局面:模型 Pass@1 变准了,但 Pass@k(大样本下的覆盖率)却变差了。京东出品的 AGPO (Asymmetric Group Policy Optimization) 通过“非对称动态优势估计”一举解决了这一痛点。它通过抑制简单正确路径的过度学习、强化稀有路径和负样本驱动,不仅在数理榜单刷新记录,更在京东搜索广告实测中实现 GMV 与收益双增。
1. 痛点:为什么 LLM 被 RL 训“傻”了?
传统的强化学习如 PPO 或 GRPO 遵循一种“识别并放大”(Identify-and-Amplify)的逻辑。当基座模型偶然跑通了一条简单的推理路径时,算法会疯狂给这条路径“打钱”。
但这会导致严重后果:
- 分布崩塌 (Distribution Collapse):模型为了稳拿奖励,变得极度保守,只会重复最简单的逻辑。
- 推理边界收缩:原本基座模型在 256 次尝试中可能碰巧解出难题,经过 RL 训练后,模型可能在 256 次尝试内都只会在错误方向上原地踏步。
2. 核心直觉:非对称的艺术 (Why it works)
作者团队认为,RLVR 的核心挑战是如何提高采样效率(Pass@1)的同时,保护基座模型珍贵的探索能力(Pass@k)。AGPO 的设计逻辑非常具有物理直觉:
- 让负样本说话:负样本强化(NSR)本质上是一种“剪枝”。它告诉模型哪些路不准走,剩下的概率空间会自然流向那些由先验知识支撑的正确路径,这比直接强灌正确路径要稳健得多。
- 对“平庸”保持冷漠:如果一个问题大部分样本都答对了(Trivial Case),AGPO 会降低对其正向奖励的幅度,防止模型陷入这种低级趣味的过度优化中。
- 悬赏“稀有”解法:当群体中仅出现极少数正确路经时,AGPO 会分配极高的优势值,挖掘那些潜藏在长尾分布中的复杂逻辑。
3. 方法论详解:架构与公式背后的逻辑
AGPO 在优势估计函数 中引入了两大核心修正:
- Constraint Factor ():在计算群体优势时引入方差调节因子,防止奖励信号在小样本波动时出现尖峰,平滑训练动态。
- Gated Negative Term ():无论群体表现如何,对错误路径始终保持一个基准的负向推力。
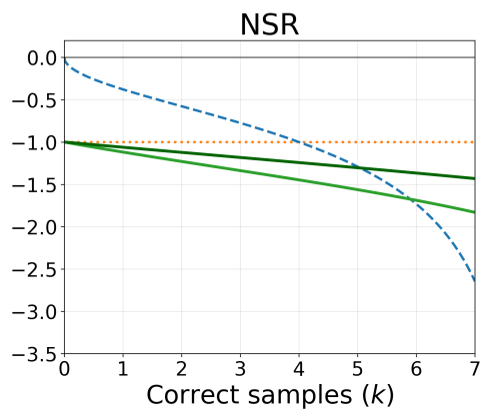 图 1:优势函数对比。相比 GRPO 的剧烈震荡,AGPO 表现出更稳定的近线性增长趋势,尤其在负采样域(NSR)具有更强的支配地位。
4. 实验战绩:数学与工业的双重胜利
数学推理的表现
通过对 Qwen2.5-Math-7B 的训练,AGPO 在 MATH、Olympiad 和 AIME 三大榜单上均展现了恐怖的扩展性 (Scaling)。
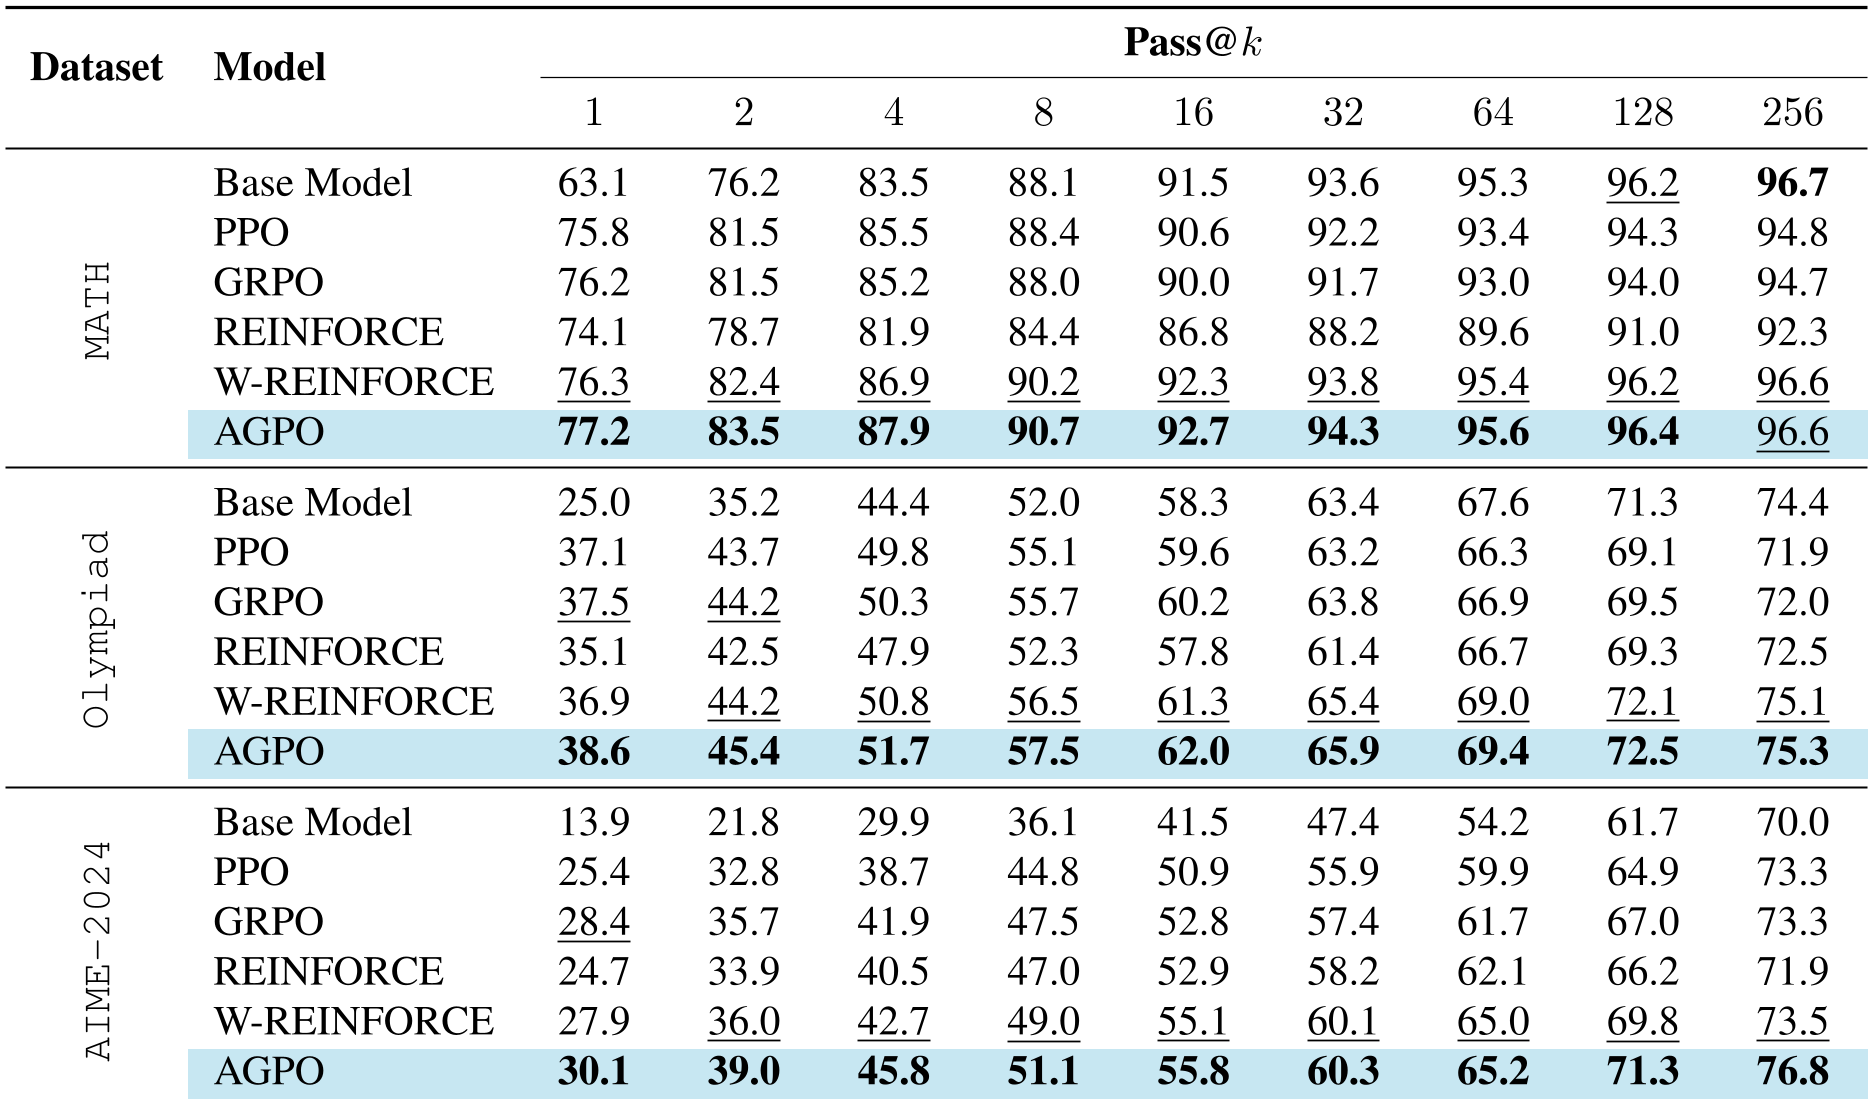 表 1:在 AIME-2024 上,AGPO 准确率从 13.9% 飙升至 30.1%。请注意 时的表现,AGPO 是极少数能维持(甚至超越)基座模型边界的算法。
工业级落地:搜索广告相关性
在京东搜索场景下,AGPO 优化后的 8B 模型作为“教师机”为下游轻量化 BERT 标注数据。实测显示:
- PIR (不相关率):显著下降 25%。
- 业务指标:线上 A/B 测试中,CPM 提升 0.50%,GMV 提升 0.21%。这证明了推理能力的提升直接转化为对长尾搜索词更好的语义理解。
5. 训练动力学分析
为什么 AGPO 能持久?秘密在于熵 (Entropy) 的维持。图 3 显示,标准 PPO/GRPO 的熵在训练早期就迅速衰减,而 AGPO 由于采用负采样主导,其策略分布保持了更高的多样性,这为后期的持续优化提供了“燃料”。
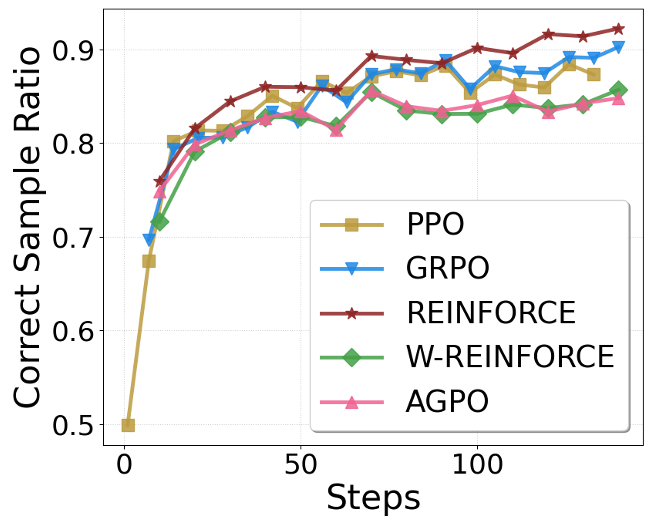 图 3:熵值维持对比。AGPO 和 W-REINFORCE 有效缓解了策略塌陷。
总结与局限
AGPO 证明了在 RLVR 时代,“少即是多(Less is more)”:对正确路径的克制反而能换来更广阔的推理边界。
局限性:
- 冷启动难题:如果基座模型本身 Pass@1 为 0(如 Llama-3.1 面对 AIME-2025),AGPO 依然无法“无中生有”。
- 长程稳定性:在超大规模迭代(数百步以上)时,即便有 NSR 保护,性能仍可能出现缓慢漂移,需要更精细的 KL 约束。
这种“非对称”的思考方式,为未来构建 o1 级别的推理模型提供了一个极具参考价值的路线图。