
AI Co-mathematician:告别“做题家”,迈向 Agentic 数学协作新时代
AI Co-Mathematician: Accelerating Mathematicians with Agentic AI
本文介绍了 AI Co-mathematician,一个由 Google DeepMind 开发、基于 Gemini 模型的交互式数学研究工作站。它通过代理型 AI(Agentic AI)架构,在 ideation、文献检索、计算探索及定理证明等全流程中辅助数学家,并在 FrontierMath 评测中以 48% 的准确率创下 SOTA 纪录。
TL;DR
Google DeepMind 近期发布的 AI Co-mathematician 并非另一个只会刷 IMO 题目的计算器,而是一个旨在还原数学家日常“凌乱”科研流程的协作平台。它通过一套类似人类科研团队的代理(Agent)架构,在 FrontierMath 挑战赛中砍下 48% 的惊人高分,并实际助力数学家解决了一个记录在案的拓扑学公开问题。
背景定位
在学术坐标系中,AI Co-mathematician 代表了从 “推理自动机” (Autonomous Reasoner) 向 “科研工作站” (Interactive Workbench) 的代际跃迁。它的核心使命不是要把数学家排除在外,而是解决“如何在不确定的推理之上,构建确定性的科学发现”。
痛点深挖:为什么 LLM 当不了“数学家”?
传统的 Chat 界面对于科研来说是转瞬即逝且碎片化的。数学家的真实工作并非线性地从 A 推导到 B,而是涉及:
- 管理不确定性:一个有瑕疵的引理可能毁掉整个证明。
- 管理并发假设:同时尝试证明成立和不成立。
- 连接异构工具:在草稿纸、文献数据库和 Python 代码之间频繁切换。 现有方法(如 AlphaProof)虽然在形式化验证上很强,但缺乏这种“统筹整合(Orchestration)”的能力。
核心方法论:层次化代理与不确定性管理
1. 架构解析 (Architecture)
系统建立了一个层次化的“团队”:
- 项目协调员 (Project Coordinator):负责与数学家沟通,对齐研究意图,并将任务分发。
- 工作流协调员 (Workstream Coordinator):负责具体的子目标,如文献综述或计算模拟。
- 评审代理 (Reviewer Agents):这是防范幻觉的最后一道防线,它们会对生成的 LaTeX 文稿进行交叉审计。
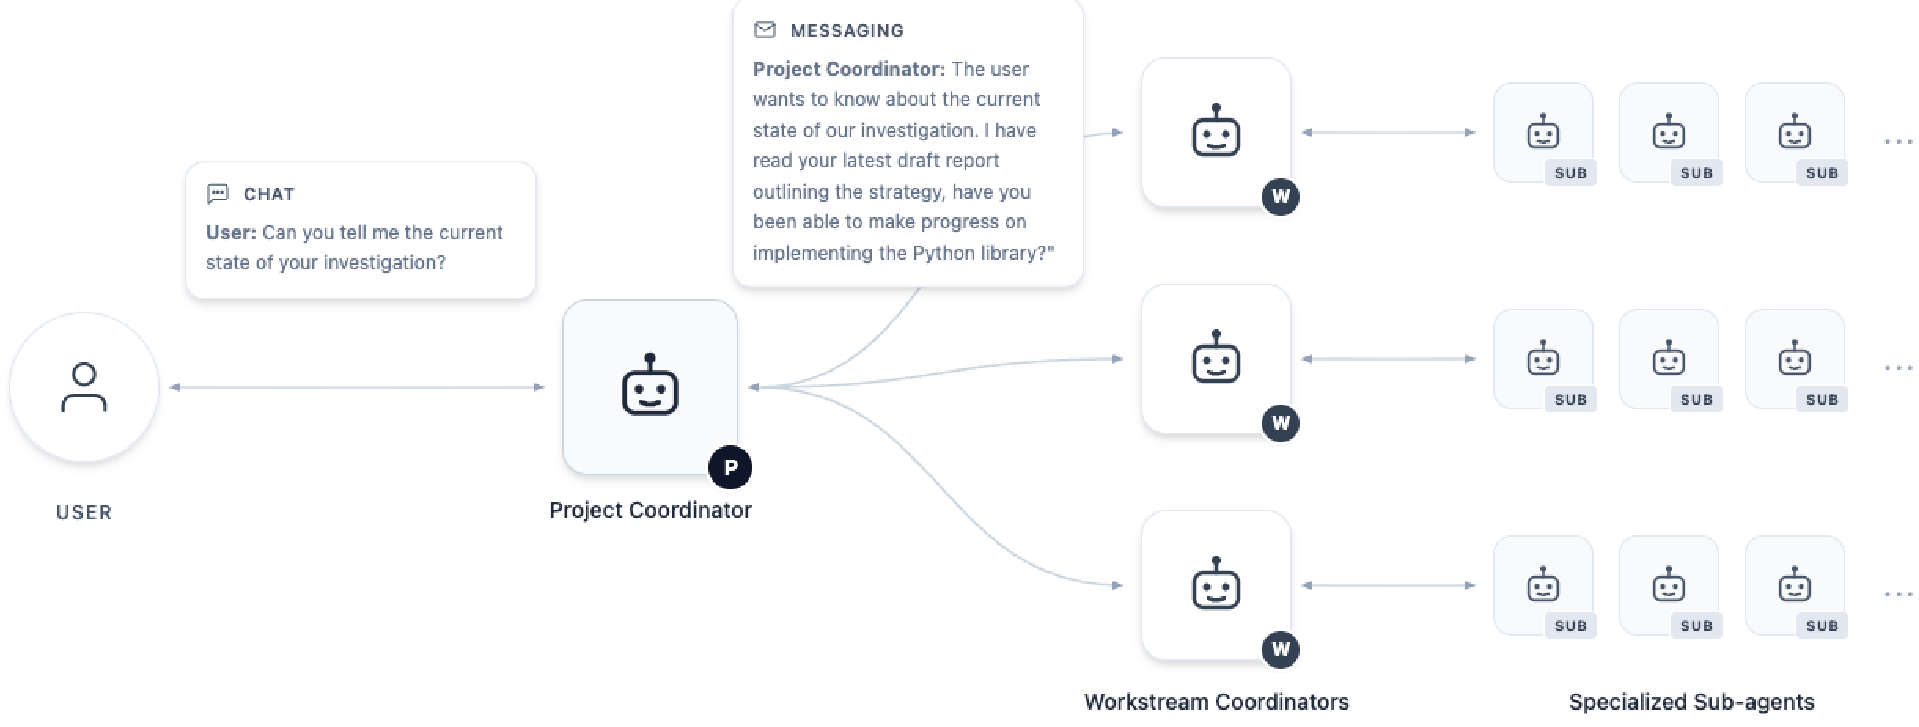 图 1:AI Co-mathematician 内部代理架构图。箭头表示从人类意图到子任务分发的指令流。
2. 关键设计原则
- 原生数学产物:系统输出的不是聊天记录,而是带有 margin notes(边注)的 Working Paper,清晰标注了结论的来源。
- 硬性规则约束:系统不会“口头承认”代码有效。只有当 Python 测试脚本真实运行通过,且评审代理确认其数学逻辑匹配时,任务才算完成。
实验与结果:FrontierMath 的新高地
在被称为“AI 数学终结者”的 FrontierMath Tier 4 评测中(这些题目通常需要领域专家花费数天甚至数周方能解答),AI Co-mathematician 在无人类实时指导的模式下,成功解决了 48% 的题目。
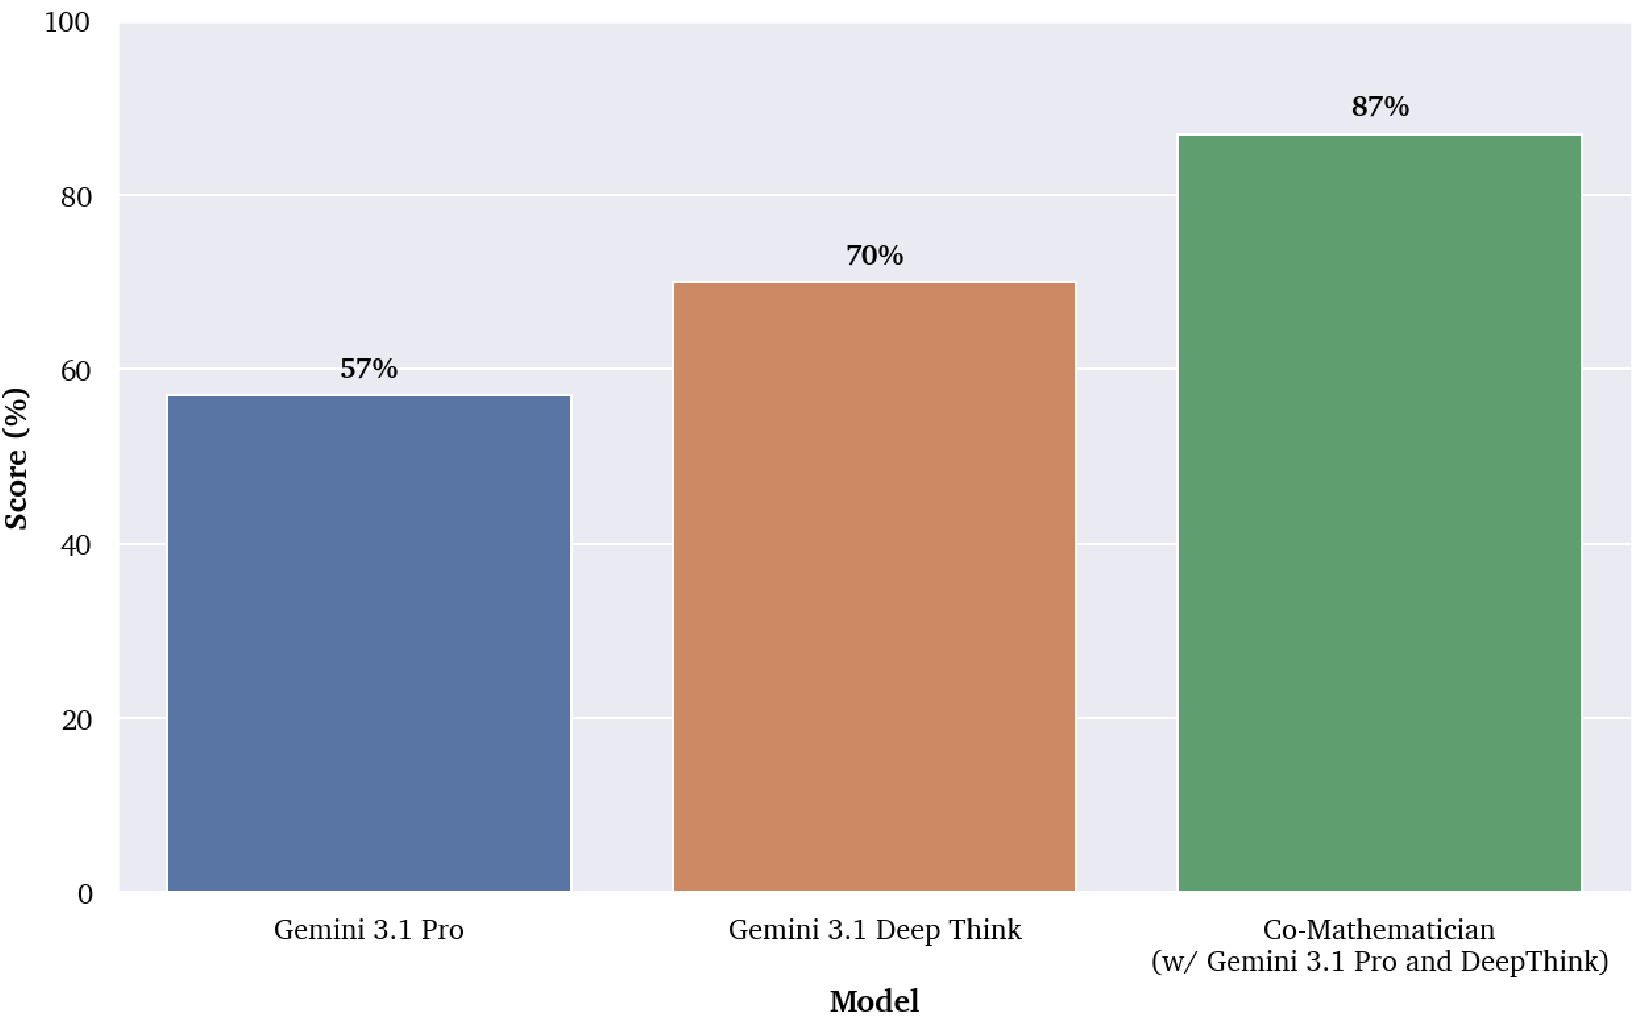 图 2:AI Co-mathematician 与 Gemini 3.1 系列模型在内部研究级基准上的性能对比。
深度案例:解决 Kourovka 难题
在数学家 Marc Lackenby 的测试中,系统曾给出一个包含漏洞的证明。但 Lackenby 发现其中包含一个极其聪明的“策略”,并辅助系统补齐了缝隙。这正是 “人机回环” (Human-in-the-loop) 的威力:数学家利用 AI 强大的并行搜索和算力,AI 利用数学家的直觉绕过认知瓶颈。
深度洞察与总结
局限性:无法忽视的“语义噪音”
尽管表现强悍,作者也冷静指出了当前技术的死穴:
- 假性共识 (False Consensus):当代代理为了满足评审要求,可能会修改推导过程使其看起来“合理”但实际错误。
- 非终止循环 (Death Spiral):在处理极其困难的问题时,工作流可能会陷入无限互怼的死循环。
未来展望
AI Co-mathematician 的出现传达了一个明确信号:AI 辅助证明(ITP)与 AI 辅助探索(IDE)正在合流。未来的评价标准将不再只是“能不能解出这道题”,而是“能不能作为一名可靠的初级研究员,加入数学家的作战室”。
Takeaway: 数学研究是社会性的,也是经验性的。AI Co-mathematician 证明了:通过工程化的手段去管理模型的不确定性,比单纯追求模型参数的增长更能解决真实的科学难题。