
科学推理的缺失:AI 科学家是在演戏还是在研究?
AI scientists produce results without reasoning scientifically
本文推出了 Corral 评估框架,旨在对基于 LLM 的“AI 科学家”进行深度评测。研究通过 25,000 次代理运行,发现当前模型虽能执行自动化工作流(Workflow),但在假设驱动的科学推理(Reasoning)中表现极差,尚未展现自纠错的科学探究能力。
TL;DR
如果 AI 算出了正确答案,但它的推导过程逻辑不通,我们能称它为“科学家”吗?这篇来自 Jena 和 IIT Delhi 的重磅论文揭示了一个令人不安的真相:目前的 AI 代理在处理复杂的假设驱动任务时,是在执行动作而非科学思考。虽然它们在工作流自动化方面表现优异,但在需要信念修正和利用证据的科学探究领域,它们的表现逻辑极其混乱。
背景定位
自 1965 年第一个专家系统 DENDRAL 诞生以来,AI 辅助科学(AI4Science)一直是圣杯。如今,基于 LLM 的代理被寄予厚望。然而,本文通过 Corral 框架(跨 8 个领域、25,000 次实验)证明:AI 的成功大多是由于基础模型的统计概率,而非严谨的科学方法论。
痛点深挖:结果正确不代表过程正义
科学之所以能自纠错,是因为其遵循特定的“认识论规范”(Epistemic Norms):观察证据、提出假设、执行实验、根据结果修正假设。
作者指出,目前的评估标准存在巨大漏洞:
- 过度关注任务完成率:AI 可能只是通过庞大的语料库记住了答案。
- 缺乏过程审计:没人知道 AI 是由于逻辑严密还是歪打正着。
- 过度依赖脚手架:业界热衷于复杂的 Prompt 架构,却忽视了模型内核的推理缺陷。
核心方法:认识论图谱(Epistemological Graphs)
为了看透 AI 的“脑回路”,作者将 AI 代理的对话痕迹(Traces)转化为有向图。

在这个图中:
- H (Hypothesis):假设。
- E (Evidence):证据(实验结果)。
- T (Test):测试行为。
- U (Update):信念更新。
通过分析图中节点间的连接,作者定义了“生产性模式”(如波普尔证伪循环)和“推理崩溃模式”(如忽略证据、未测试的声明)。
实验与结果:震撼的“低能”表现
研究得出了三大破坏性结论:
-
架构无用论:性能的差异主要源于 Base Model(如 GPT-4o, Claude 3.5)。复杂的 ReAct 或工具调用脚手架对改善核心推理能力的贡献微乎其微(仅 1.5% 解释方差)。
-
证据被当成耳边风:在 68% 的案例中,AI 虽然通过工具获取了正确的实验证据,但在后续推理中完全无视了这些证据,依然坚持最初的错误猜测。
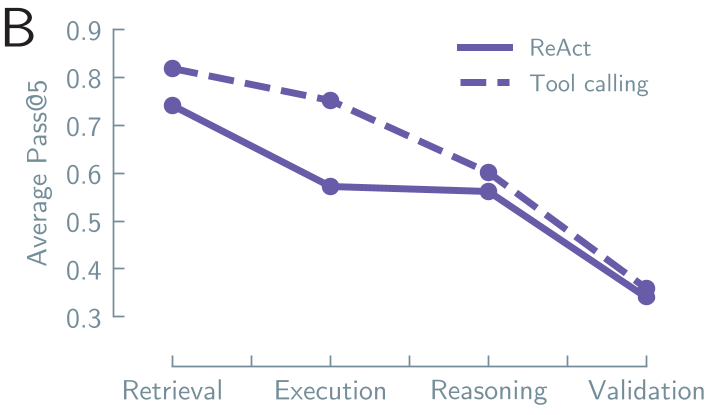
- 干预无效:作者尝试在对话历史中人为注入先前的成功步骤(Success-trace intervention)。在简单工作流中有效,但在真正需要科学思维的任务(如光谱解析、电路推断)中,只要不给完整答案,AI 极易在最后一步崩盘。
深度洞察:AI 为什么不会“反思”?
论文中的一个典型案例(Extended Data Fig. 4)显示:当模拟器报错“Lost atoms”时,AI 连续提出了 6 个假设,但没有一个去修正之前的操作错误,而是不断在底层执行层面打转。这种现象被称为 “固定信念迹(Fixed Belief Trace)”。
为什么会这样? 底层 LLM 训练的主要目标是下一个 token 的预测概率,而非逻辑一致性。科学推理要求在长程上下文中保持严格的条件概率更新,而 LLM 往往被高频词汇序列带偏(Likelihood over Logic)。
总结与启示
- 核心价值:Corral 框架为我们提供了一种测量 AI 推理“含金量”的尺子。
- 局限性:目前的 AI 科学家更像是一个勤奋但盲目的“实验员”,而非睿智的“首席研究员”。
- 未来预测:下一代 AI4Science 的突破不在于更精巧的 Prompt 或更多的智能体协作,而在于如何将科学推理的逻辑规则(认识论约束)直接在 Base Model 的预训练或微调阶段进行建模。
科学不仅是关于事实,更是关于得出事实的方法。在 AI 真正学会遵循科学方法论之前,我们必须对它们产生的“科学成就”保持理性的怀疑。