
[CVPR 2026] NUMINA:让视频生成学会“数数”,突破 T2V 模型数值对齐瓶颈
When Numbers Speak: Aligning Textual Numerals and Visual Instances in Text-to-Video Diffusion Models
本文提出了 NUMINA,一个针对视频生成扩散模型(T2V)的无需训练(training-free)的数值对齐框架。该框架通过“识别后引导”(identify-then-guide)机制,精准控制视频中生成物体的数量,显著提升了模型在复杂指令下的计数准确性。
TL;DR
尽管当前的视频生成模型(如 Wan2.1, CogVideoX)生成的画面已经足够精美,但它们在逻辑层面常常“不识数”。本文提出的 NUMINA 是一个无需微调、即插即用的框架,它通过挖掘 DiT 模型内部潜在的注意力机制来识别物体布局,并通过动态干预注意力分数,强制模型生成精确数量的物体,在 CountBench 基准上取得了显著的性能提升。
核心痛点:为什么 AI 总是“数不清”?
作者通过实验发现,T2V 模型(特别是基于 Diffusion Transformer 的模型)在处理数字时有两个核心缺陷:
- Semantic Weakness:相比于名词(Nouns)有明确的注意力中心,数字词(Numerals)的交叉注意力图通常非常弥散,导致模型不知道要把“3”这个指标映射到哪个具体区域。
- Instance Ambiguity:在时空潜空间中,几个相邻的同类物体(如三只连在一起的猫)往往被模型视为一个整体,缺乏实例级别的边界意识。
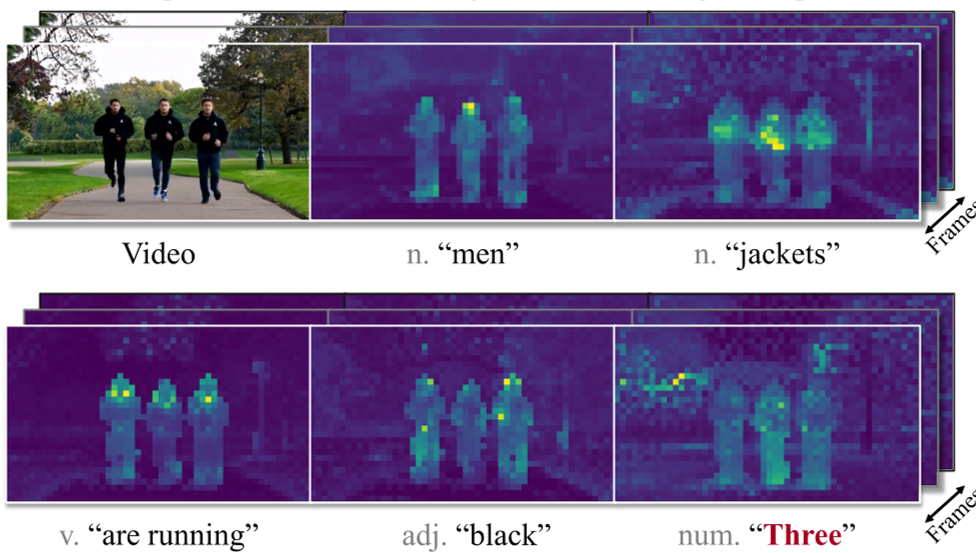 如图所示,名词(如 cats)有清晰的响应区域,而数字词的响应非常模糊。
Methodology:从识别到引导的闭环
NUMINA 的工作流分为两个精密阶段:
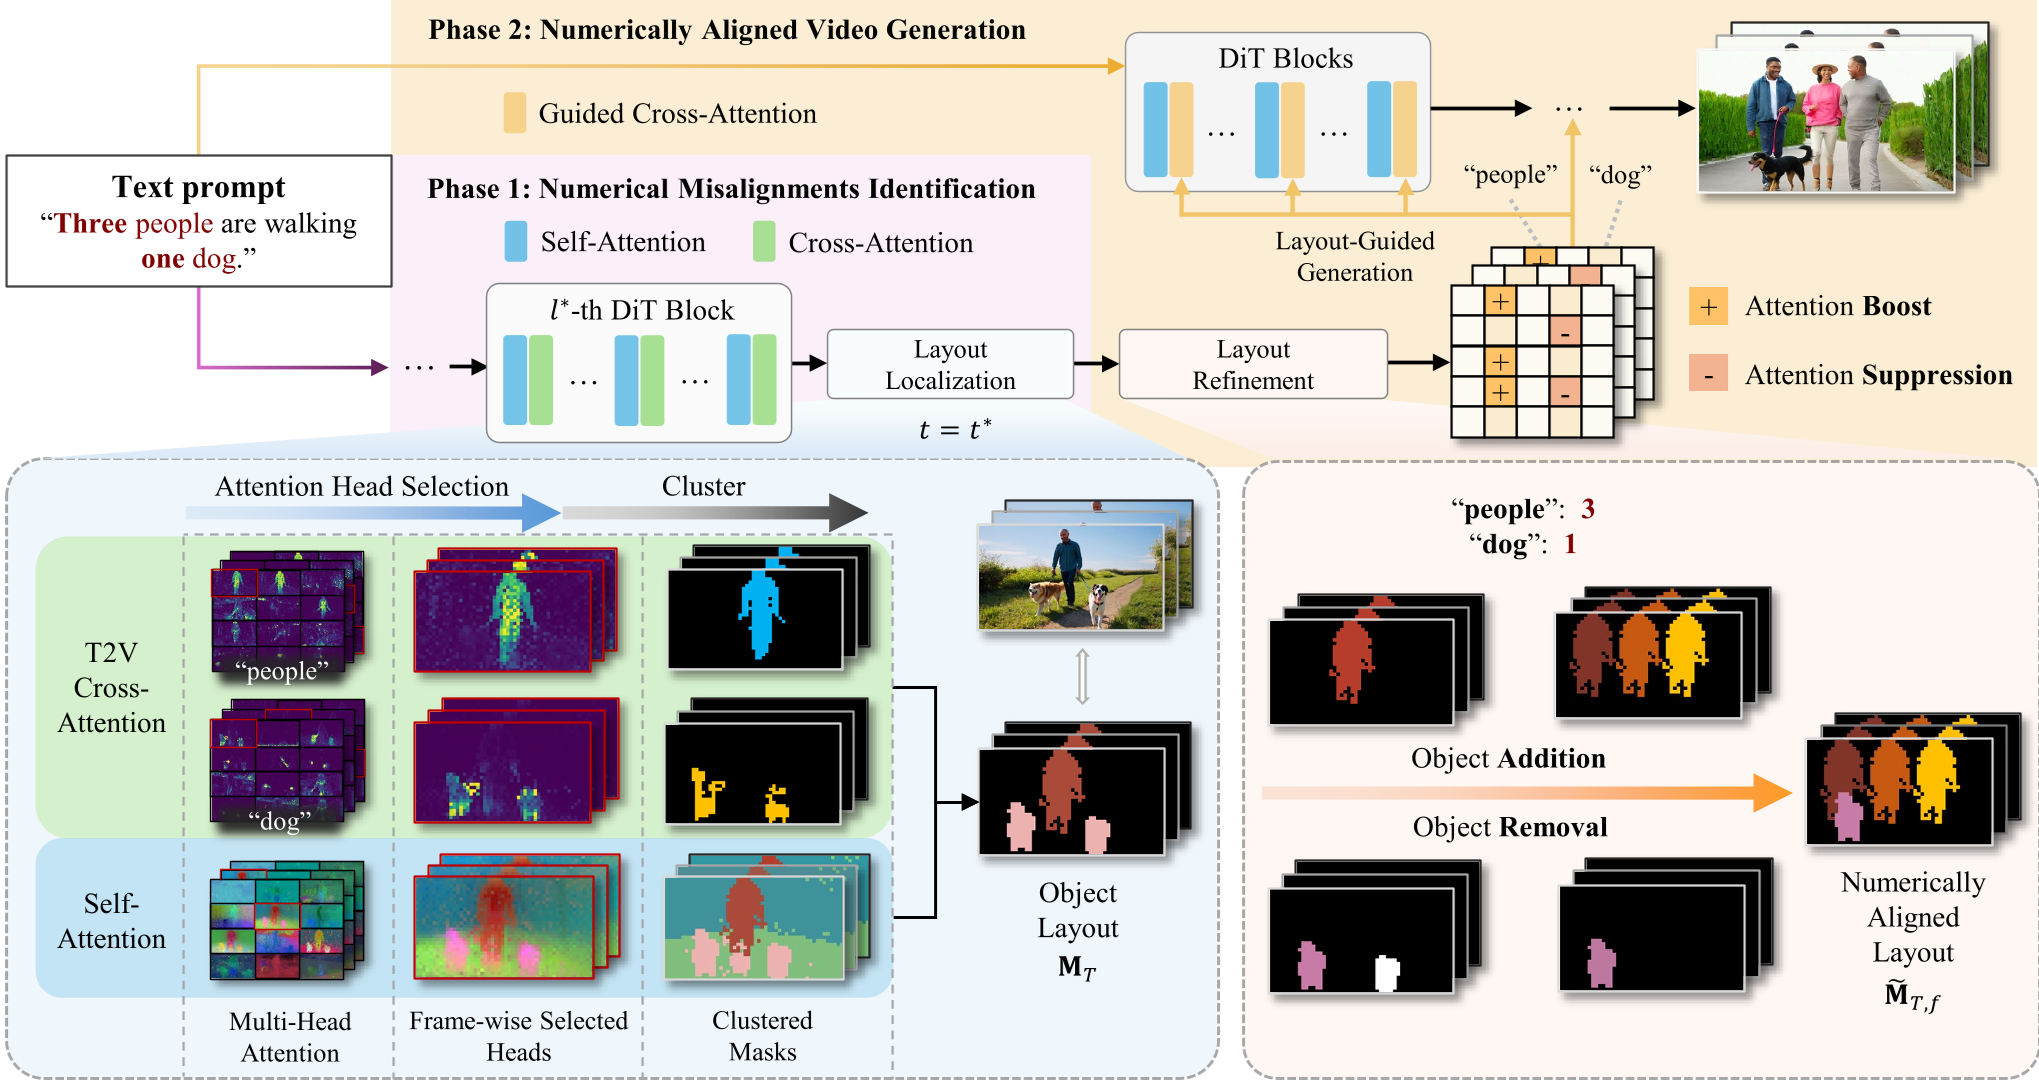
1. 数值对齐识别 (Numerical Misalignment Identification)
在去噪的早期阶段(如 ),作者发现某些特定的注意力头已经产生了个体化特征。
- 自注意力头选择:通过 PCA 投影和边缘清晰度等 3 个指标打分,自动选出最能区分物体边界的那个“神头”。
- 交叉注意力头融合:结合名词 token 的注意力图,以此确定物体的具体品类位置。
- 生成显式布局:利用聚类算法(Mean-shift 和 DBSCAN),将隐约的注意力信号固化为一张“可数”的 Mask 图。
2. 数值对齐生成 (Numerically Aligned Generation)
一旦识别出生成的数量不对,NUMINA 会进行干预:
- 布局精修 (Layout Refinement):如果要删掉一个物体,就擦除面积最小的 Mask;如果要增加,就寻找空间最优位置(基于重叠度、中心点距离和时间稳定性)插入一个模板 Mask。
- 注意力调制:在后续的去噪步中,通过偏置项(Bias term)增强新实例区域的注意力,或者抑制被删除区域的响应。
实验战绩:低成本实现高精度
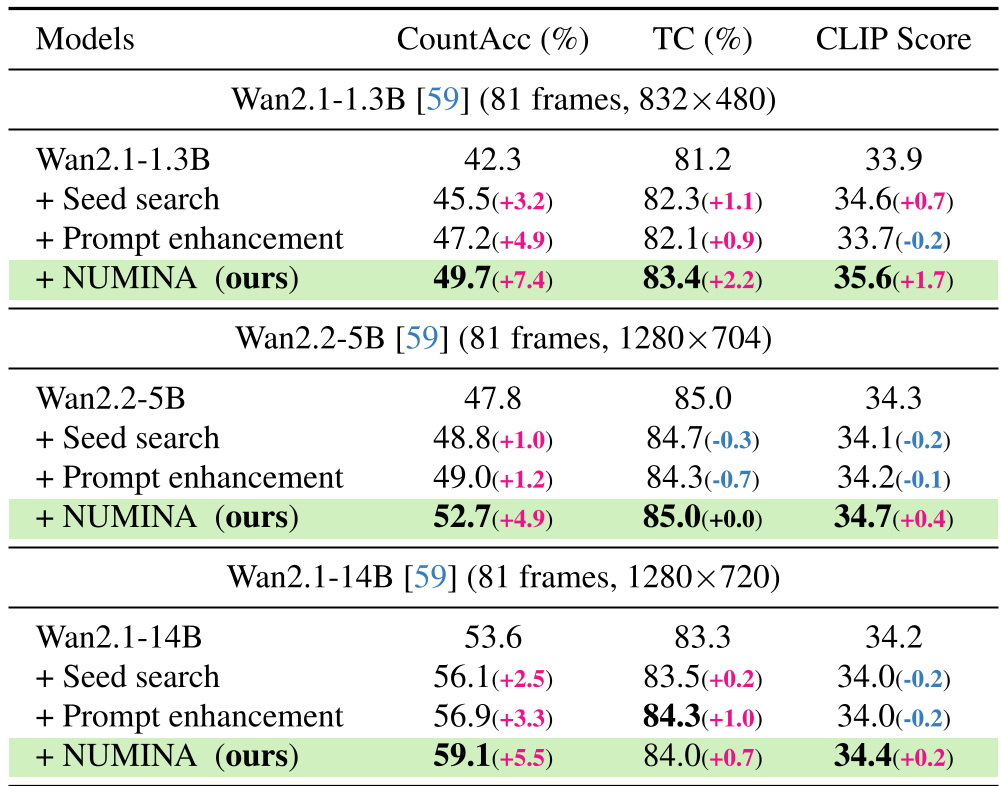
作者引入了 CountBench,专门测试 1-8 个物体的生成。结果显示:
- 超越体量限制:使用 NUMINA 增强的 1.3B 小模型,在计数准确率上竟然超过了未增强的 5B 模型。
- 广泛适配性:除了 Wan 系列,该方法还能无缝移植到采用全注意力机制(MMDiT)的 CogVideoX 上。
- 性能提升:在 Wan2.1-1.3B 上准确率提升了 7.4%,在保持视频画质的同时,CLIP Score 反而因为语义逻辑的完善而提升了。
深度洞察与总结
NUMINA 的成功给了我们一个重要启示:扩散模型并不是没有能力控制数量,而是这种能力被埋藏在特定的注意力通道中,需要精密的“探针”去提取和校准。
局限性与未来
尽管 NUMINA 表现出色,但在处理极端密集场景(如数百个物体)或注意力头发生过度分割(将物体的头和身体识别为两个物体)时仍会失效。未来的研究方向可能会引入更强的感知分组(Perceptual Grouping)先验,以实现真正的万物皆可对齐。
Takeaway:NUMINA 是一种低成本(Training-free)、高效(兼容加速器)的视频逻辑优化方案,是迈向物理逻辑一致的 T2V 模型的重要步伐。