
Flow Matching 的惊人稳定性:为什么砍掉一半数据后效果反而更好了?
The Amazing Stability of Flow Matching
本文系统研究了 Flow Matching (FM) 模型在数据、架构和配置变动下的稳定性,通过 CelebA-HQ 实验发现即使裁剪 50% 的训练数据,生成的样本质量及多样性依然极高。作者提出了多种数据裁剪策略,并证明 FM 模型在相同随机种子下倾向于收敛至视觉相似的输出。
TL;DR
在生成模型训练动辄消耗数百块显卡的今天,来自斯图加特大学和多特蒙德大学等机构的研究者发现:Flow Matching (FM) 模型具有极强的“稳定性性”。即使你把训练集删掉一半,或者把 Transformer 架构换成 U-Net,只要随机种子(Seed)相同,模型生成的图像在视觉和语义上依然高度相似,甚至通过精细的“数据节食(Data Diet)”,模型的 FID 评分还能不降反升。
痛点深挖:数据越多越好吗?
当前的生成大模型(如 Stable Diffusion 3, SDXL)过度依赖于海量数据的“暴力堆砌”。学术界一直存在一个疑问:模型学到的究竟是数据的分布,还是某种更本质的几何结构?
在 Diffusion 模型中,由于其目标函数与 Schrödinger Bridge(熵输运优化)相关,稳定性已有理论支持。但对于 Flow Matching 这种通过 ODE(常微分方程)输运噪声到 clean 数据的模型,其速度场 在面对训练集大幅度扰动时是否会“跑偏”?如果能证明它足够稳定,我们就能用更少、更精炼的数据训练出同样甚至更好的模型。
方法论详解:如何给 Flow Matching “节食”
作者提出了三种核心裁剪(Pruning)策略来测试 FM 的底线:
- 梯度分数 (Grad):计算样本对模型参数更新的贡献度,保留影响力最大的数据。
- 损失分数 (Loss):保留预测速度场偏离目标最大的“困难样本”。
- 聚类平衡 (Clustb):利用 CLIP 编码后进行 K-Means 聚类。
- Insight:作者发现仅仅保留困难样本(高 Loss)反而会带偏模型,因为这些样本往往处于低密度区;而平衡聚类中心分布(即 Clustb)能让模型更均匀地感知数据流形。
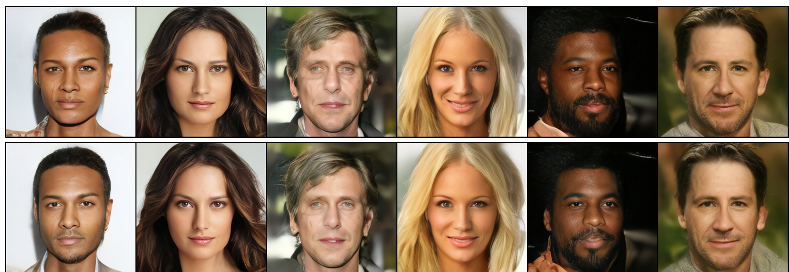 上图展示了模型在不同扰动下的鲁棒性表现。
核心发现:穿越噪声的“定力”
1. 互斥数据的“殊途同归”
研究者将 CelebA-HQ 数据集分成两个完全不重叠的子集。令人惊讶的是:在相同种子下,两个模型生成的脸部几乎完全一致(见下图 a),ArcFace(人脸识别模型)给出的相似度远超随机配对。
2. 架构剧变下的语义保留
即使将 6.75 亿参数的 DiT-XL 缩小到 3300 万参数的 DiT-S,甚至是彻底更换模型范式(从 Transformer 换到卷积 U-Net),尽管细节(如皮肤纹理)有变,但人物的性别、表情、构图等全局属性依然被精准保留(见下图 b)。
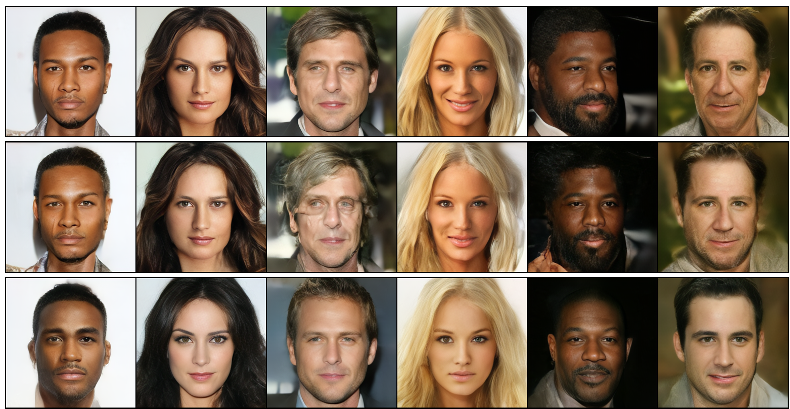 (a) 两个互斥随机子集训练生成的对比;(b) 不同模型架构生成的对比。
实验与结果:少即是多
在定量分析中,作者发现了一个反直觉的结论:
- 随机裁剪 50%:FID 从 24.24 轻微下降至 25.25。
- 平衡聚类裁剪 (Clustb):FID 居然优化到了 22.80。
这说明 FM 模型并不需要冗余的样本,它更需要分布均匀的样本来支撑起速度场的骨架。

深度洞察:Flow Matching 的未来
为什么 FM 这么稳? 作者认为,FM 学习的是一种平衡的导向。即使局部数据缺失,ODE 的积分过程也具有平滑效应,使得全局轨迹只会发生微小的局部调整。
局限性分析:
- 当移除整个类别(如删掉所有男性脸)时,对应的噪声区域会被“重路由”到现有的类别上。这意味着 FM 虽然稳,但无法“无中生有”。
- 目前的实验主要集中在人脸(CelebA-HQ),对于极其复杂的多模态场景(如 ImageNet),稳定性的边界可能有所不同。
总结: 这项研究为“高效训练”打开了新窗口。未来的生成模型可能不再需要贪婪地吞噬所有网络抓取的数据,通过智能的数据裁剪与平衡,我们能在保持生成预期的同时,显著降低碳排放与存算压力。