
AnisoAlign:重塑模态鸿沟,让纯文本数据成为 MLLM 的“视觉能源”
Anisotropic Modality Align
本文提出了 AnISOAlign,一种基于各向异性几何校正的非配对模态对齐框架。该方法通过将共享表征空间分解为优势子空间并引入块状极坐标映射,成功在不依赖配对数据的情况下,将文本表征转化为高质量的视觉替代表征,并在多模态大模型(MLLM)任务中达到 SOTA 性能。
TL;DR
训练多模态大模型(MLLM)一直受困于高质量“图文配对”数据的稀缺。本文通过深度的几何诊断发现:模态鸿沟并非简单的“均值偏移”,而是一种低维、各向异性的结构化残差。基于此,作者开发了 AnisoAlign 框架,通过两阶段几何校正,在不使用任何真实图像的情况下,仅靠纯文本就训练出了性能媲美甚至超越配对数据的 MLLM。
1. 痛点:被误解的“模态鸿沟”
在 OpenAI CLIP 等对比学习模型中,图像和文本虽然被映射到同一空间,但在几何上总是保持距离。
前人通常认为:只要把文本向量的中心点挪到图像向量的中心点(均值修正),问题就解决了。但本文作者通过数学诊断无情地戳破了这个幻象:
- 均值修正仅能消除约 10% 的差异:即便中心点对齐了,两者的协方差形状依然大相径庭。
- 各向异性残差(Anisotropic Residual):残差分布在极少数几个方向上异常集中(各向异性比率高达 28.6),这才是阻碍模态互换的元凶。
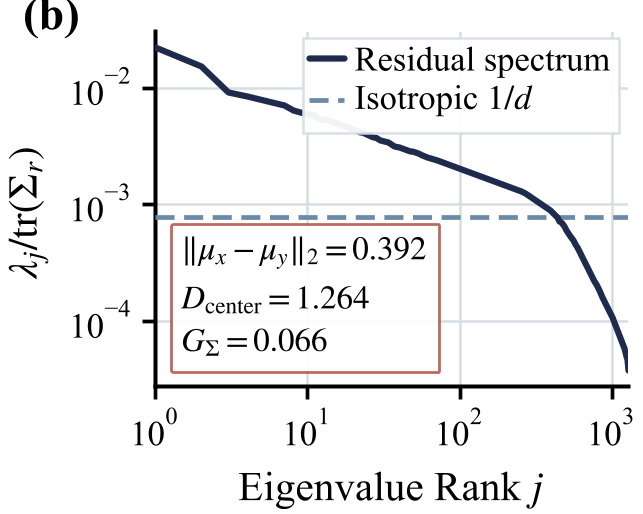 图 1:实验证明,简单的均值修正后,大部分跨模态残差依然存在。
2. 核心直觉:什么是真正有效的对齐?
作者提出了一个关键原则:有效的对齐必须在纠正残差的同时,保护源模态的语义几何结构。
如果单纯为了贴合目标分布(如引入高斯噪声),语义会被破坏(Semantic Collapse);如果只保语义,则无法进入目标的有效分布区。为了平衡这两者,AnisoAlign 引入了块状极坐标(Blockwise Polar Coordination)。
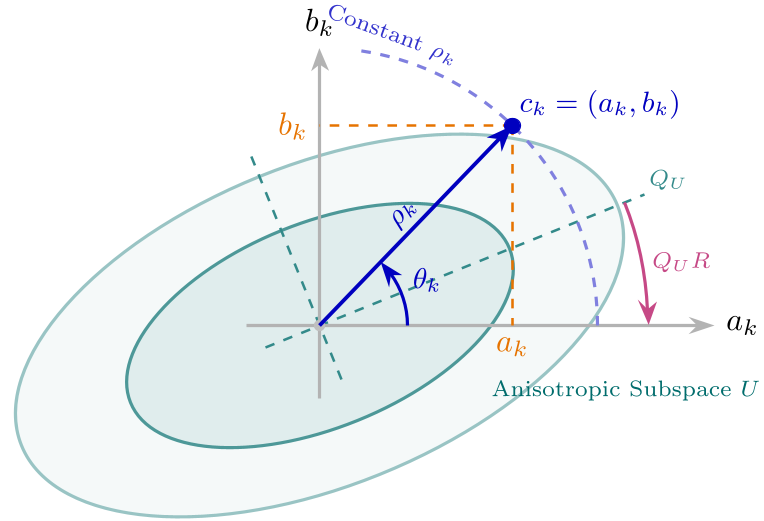 图 2:在优势子空间 U 中进行各向异性圆周解耦。
3. Methodology:两阶段几何手术
AnisoAlign 的校正过程极为精妙,像是一场精密的微创手术:
- 子空间分解:利用联合协方差矩阵,将空间划分为包含核心信息的优势子空间 和正交补空间 。
- 极坐标建模:在 空间内,将向量表达为半径(能量)和相位(方向)。因为各向异性主要体现在特定的相位偏好上。
- 第一阶段(学习先验):仅在目标模态(图像)上学习相位分布的评分先验(Score Prior),捕捉图像特征在相位空间中的“节奏”。
- 第二阶段(有界修正):将文本向量基于之前的先验进行调整。关键点在于有界(Bounded):通过 Tanh 函数限制修正幅度,确保文本向量不会被过度扭曲,从而保留原始语义。
4. 惊人的实验战绩:文本胜过图像?
最引人注目的是其“以简御繁”的能力:
- 零图像训练:在完全不接触真实图像的情况下,AnisoAlign 在 MME (72.96) 和 MMStar 等多个评测基准上刷新了纯文本训练的记录。
- 超越配对数据:当研究者将文本数据规模扩大到 2M 时,其训练出的模型平均得分(52.75)微弱超过了使用真实 1M 图文配对数据训练出的基线(52.72)。
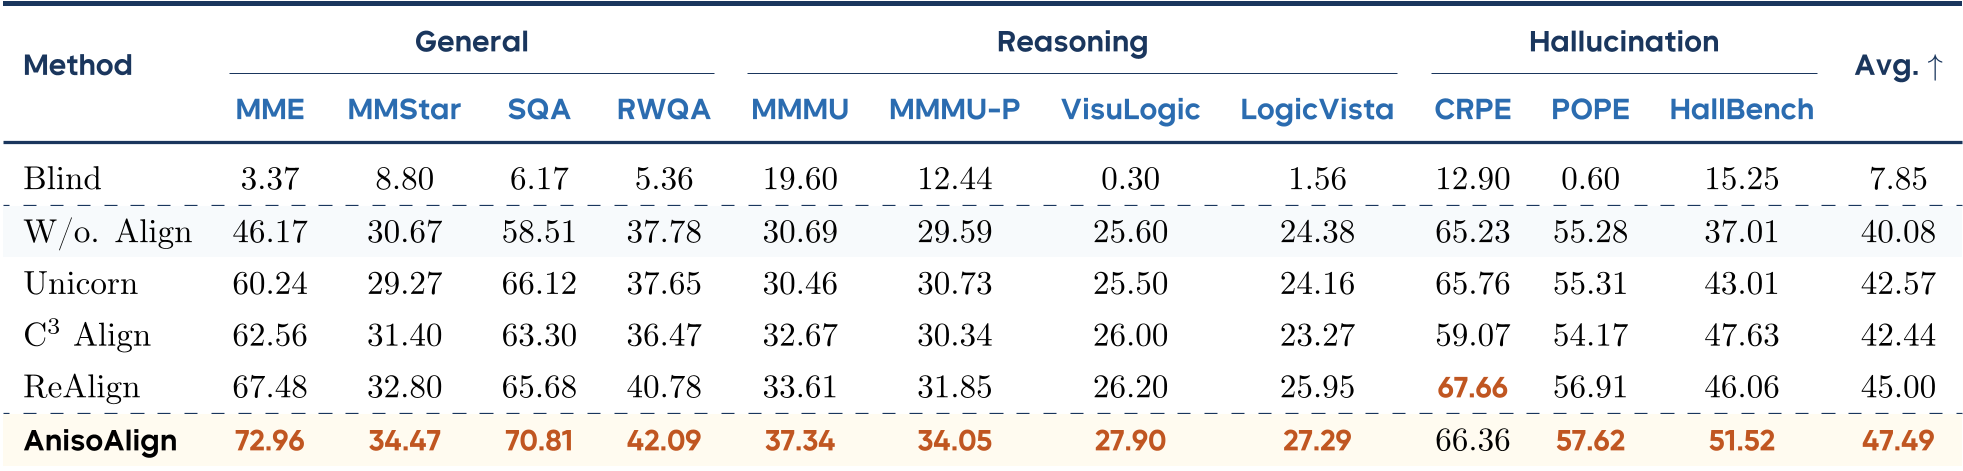 表 1:AnisoAlign 在通用感知、逻辑推理和幻觉评估上全面领先。
5. 深度洞察与总结
AnisoAlign 的成功告诫我们,多模态学习的未来可能不在于更多昂贵的配对数据,而在于对共享表征空间几何特性的深度压榨。
关键 Takeaways:
- 几何决定论:模态鸿沟是有结构的。理解这种结构的各向异性,比盲目增加数据量更重要。
- 相位语义:通过极坐标解耦半径和相位,为跨模态表征对齐提供了一个比欧几里得空间更高效的坐标系。
局限性: 该方法重度依赖于预训练对比模型(如 CLIP)已经建立起的“初步语义重叠”。如果底层编码器本身很差,无法捕捉到共享的骨干几何,AnisoAlign 也将无用武之地。
总而言之,这项工作为“如何用廉价的无监督数据训练强大的多模态模型”指明了一条清晰的几何路径。