
Anny-Fit:破解全年龄段 3D 人体恢复的“深度-缩放”迷局
Anny-Fit: All-Age Human Mesh Recovery
本文提出了 Anny-Fit,一个全年龄段多人体 3D 网格恢复(HMR)框架。该方法通过整合 VLM 语义属性、度量深度图和 2D/3D 关键点,在相机坐标系下进行多目标联合优化,成功解决了全年龄场景中的深度-比例二义性问题,实现了 SOTA 性能。
TL;DR
在 3D 人体网格恢复(HMR)领域,长期存在一个被忽视的假设:人都是成年人。Anny-Fit 突破了这一限制,通过融合视觉语言模型(VLM)的语义直觉和度量深度图,首次在统一的相机坐标系下实现了从婴儿到老人的高精度多目标 3D 恢复。
核心痛点:消失的“成年人假设”
在单目视觉中,深度估计是一个典型的病态问题。以往的模型之所以能跑通,是因为它们默认人体大小是恒定的——通过画面中人的大小,就能反推其距离。
然而,在全年龄场景下,这个逻辑崩塌了:一个矮小的轮廓,究竟是远处的姚明,还是眼前的孩子?
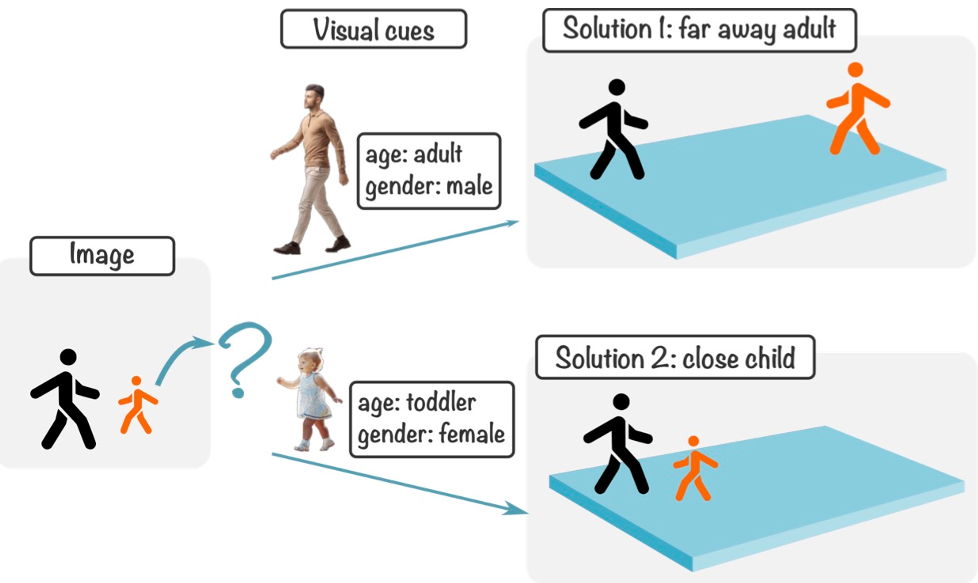 图 1:相同的 2D 投放投影可以对应完全不同的 3D 实体,如果不识别受试者的年龄,系统将无法正确定位空间位置。
方法论:专家知识与多目标联合优化
Anny-Fit 的核心直觉是:既然几何上存在二义性,就用语义来补全。
1. VLM 驱动的语义初始化
作者巧妙地将形状估计转化为一个“分类任务”。利用 Qwen2.5-VL 等模型,对图像中的人头进行热启动裁剪,询问其年龄范围(婴儿、幼儿、儿童、青少年、成年、老年)。这些语义标签被映射到 Anny 模型(一个覆盖全生命周期的参数化人体模型)的连续 shape 空间 β 中。
2. 相机空间的场景一致性
不同于前人对每个人单独裁剪优化的做法,Anny-Fit 在全局相机空间内操作。它引入了:
- 深度排序损失 (Depth Ordering Loss):利用单目深度估计专家模型确定人与人之间的相对前后关系。
- 多阶段优化策略:先定平移(初步位姿),再定形状(利用 VLM 先验),最后精调全身关节。
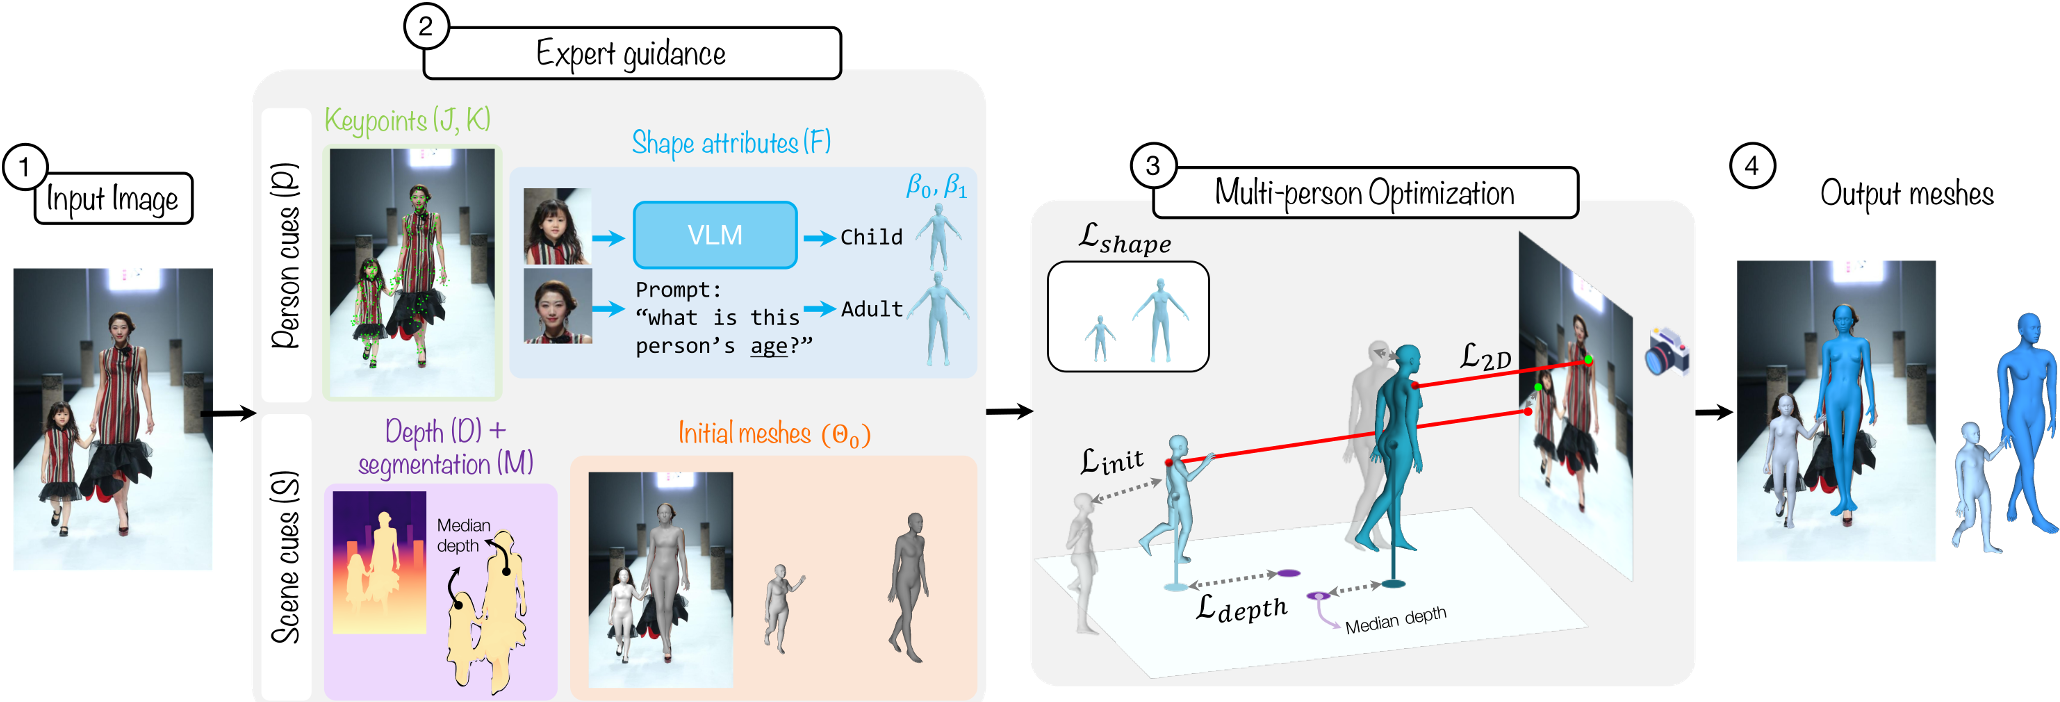 图 2:Anny-Fit 的工作流程。它整合了关键点、分割掩码、深度图和 VLM 提取的年龄/性别属性,通过多阶段优化输出一致的 3D 场景。
实验战绩:让成年人模型“一键”适配全年龄
Anny-Fit 最令人兴奋的能力在于其 Zero-shot 适配能力。研究者发现,即使是一个只见过成年人的预训练模型(如 CameraHMR),在经过 Anny-Fit 的优化后,其在儿童场景下的 3D 误差也下降了近 30cm,形状估计准确率(Gender F1)提升了 80% 以上。
 表 1:在 CMU Toddler(幼儿数据集)上的 3D 评估。Anny-Fit 在 MPJPE 指标上带来了显著的精度跃迁。
深度洞察:伪标签的降维打击
这篇论文的另一个重大贡献是规模化伪标签生成。由于隐私和伦理问题,标注真实的儿童 3D 数据极其困难。Anny-Fit 在 MS-COCO 这种大规模自然数据集上运行优化,生成了数万个高质量的 3D 标注。实验证明,用这些“人造数据”训练模型,效果远超传统的合成数据,这为 HMR 领域的“数据荒”提供了一条极具工业价值的路径。
总结与价值
Anny-Fit 不仅仅是一个优化算法,它代表了 HMR 领域从“感知几何”向“理解人类属性”的转变。通过显式地对年龄、性别等生理特征建模,它让 AI 第一次拥有了分辨“大手牵小手”这种温馨场景的 3D 空间感。
虽然它仍依赖高质量的专家模型初始化(如 keypoint 识别如果崩了,优化也会跑偏),但作为全年龄段重建的先驱工作,其对场景连贯性的处理值得所有视觉研究者借鉴。