
AnyRecon:突破稀疏限制,基于视频扩散模型的任意视角 3D 重建新范式
AnyRecon: Arbitrary-View 3D Reconstruction with Video Diffusion Model
AnyRecon 是一个基于视频扩散模型的稀疏视图 3D 重建框架,支持任意数量且无序的输入视图。该方法通过全局场景记忆和几何感知调节策略,在保持几何一致性的同时,实现了大规模场景的高保真度重建。
TL;DR
在 3D 重建领域,从少量、凌乱的随手拍照片中恢复出高保真的 3D 场景一直是个难题。AnyRecon 提出了一种创新的框架,利用视频扩散模型的强大生成能力,结合显式的 3D 几何内存,实现了支持任意数量、无序输入的 SOTA 级 3D 重建,且推理速度提升了 20 倍。
1. 痛点:为什么稀疏视图重建这么难?
传统的 NeRF 或 3DGS 依赖密集的视角输入。当前的生成式方法尝试通过扩散模型“脑补”缺失视角,但存在两个致命伤:
- 扩展性差:大多数模型只能以 1-2 张图为参考,面对长轨迹的大场景时,由于缺乏全局记忆,会出现严重的几何漂移和色彩闪烁。
- 表征模糊:现有的视频生成模型(如 Wan, SORA 类型)为了效率大量使用时间压缩(Temporal Compression),这在大视角跳跃下会导致特征纠缠,丧失了精密的像素级几何对应关系。
2. 核心架构:解耦时间,拥抱几何
AnyRecon 的核心直觉是:将 3D 重建视为一个“生成-反馈”的闭环系统。
2.1 全局场景记忆 (Global Scene Memory)
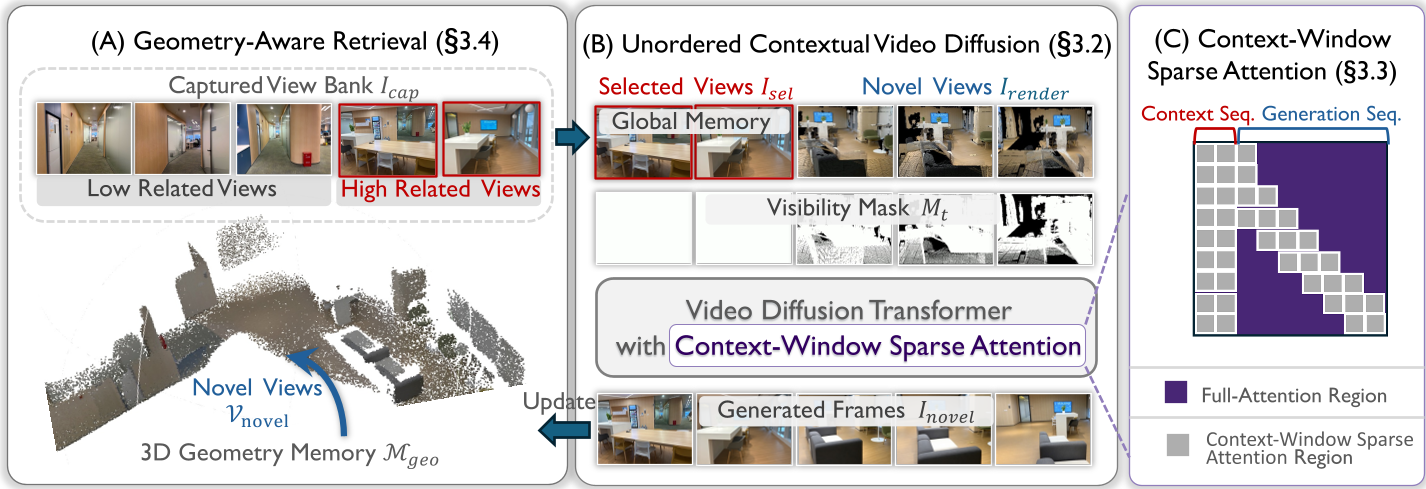
AnyRecon 摒弃了传统的顺序视频生成逻辑,将所有捕获的稀疏视图作为“全局缓存”放在序列开头。这意味着模型可以像查询数据库一样,在生成任意位置的新视角时,实时参考那些空间上最相关的原始照片。
2.2 几何驱动的“生成-重建”循环
这是本文最精彩的设计。如图 2 所示,系统执行以下迭代:
- 几何检索:根据当前要生成的视角,从捕获库中检索具有最大几何重叠(通过可见性映射计算)的视图。
- 受控生成:将渲染的点云深度图、可见性掩码与 RGB 图像拼接,输入扩散模型。
- 内存更新:将生成的新视图反投影回 3D 空间,动态更新全局点云内存。
3. 效率优化:4步即出的 3D 资产
为了解决扩散模型推理慢的问题,AnyRecon 引入了 DMD2 (Distribution Matching Distillation) 蒸馏技术。
- 去除时间压缩:虽然增加了 Token 数量,但保证了细节不丢失。
- 稀疏注意力:通过限制注意力窗口(Context-window Sparse Attention),将复杂度从 O(L²) 降至线性。
- 4-Step 采样:原本需要 50 步的扩散过程被压缩至 4 步,渲染一个 40 帧的场景仅需约 100 秒。
4. 实验见真章
在 DL3DV 和 Tanks and Temples 数据集上,AnyRecon 在插值(Interpolation)和外推(Extrapolation)任务中均大幅领先基线模型(如 ViewCrafter, Uni3C)。
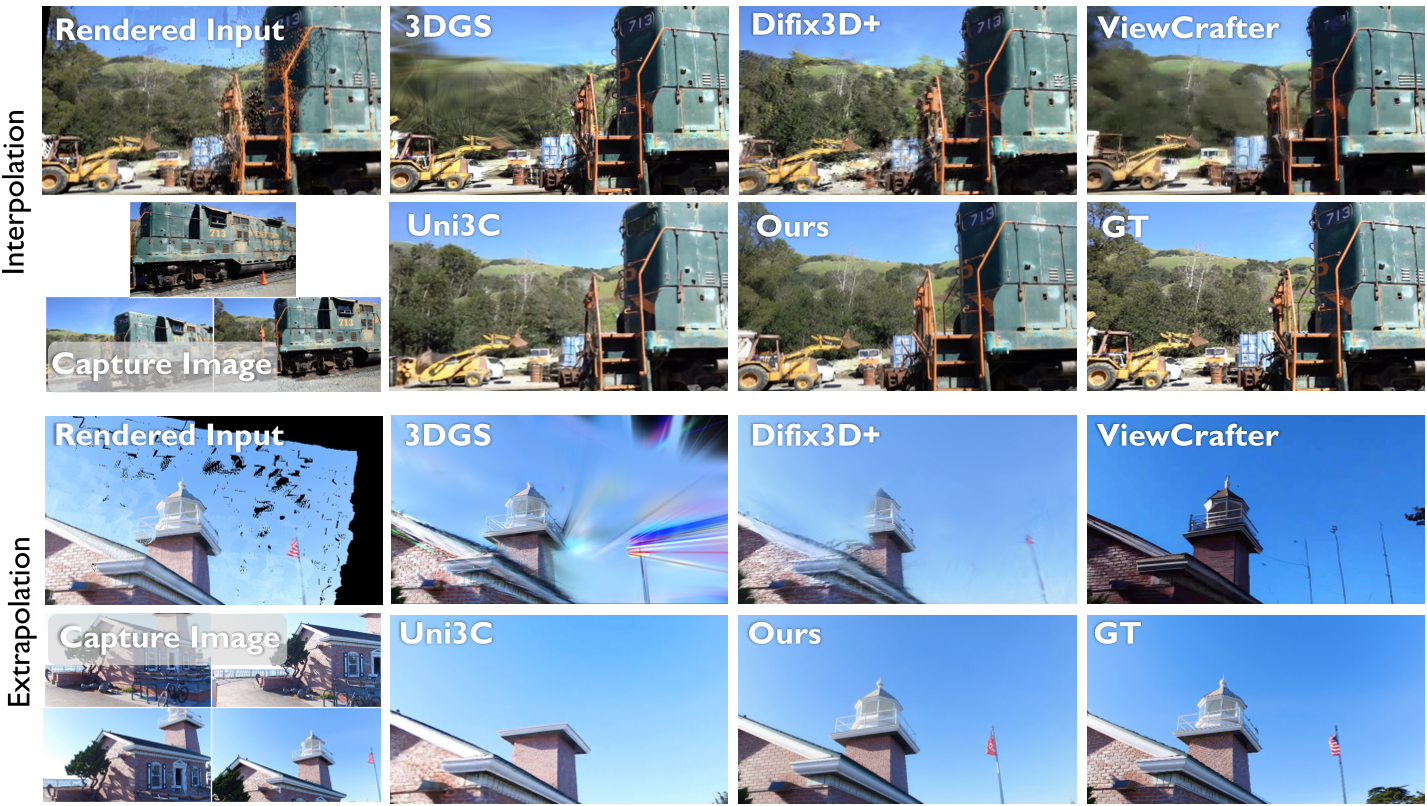
从定性结果看,AnyRecon 生成的区域不仅纹理清晰,更重要的是在长距离旋转后,物体的位置和结构依然能与起始点完美对齐。
5. 深度洞察与总结
AnyRecon 标志着 3D 重建从纯优化(Optimization-based)向生成式引导(Generative-guided)的进一步转型。
- 局限性:它依然依赖一个初步的几何底座。如果初始点云由于视角极度匮乏而彻底失败,生成的质量也会受限。
- 未来展望:这种“几何感知检索 + 扩散蒸馏”的策略极具工业潜力,特别是在 AR 导航和移动端飞速建模场景中,它为受限资源下的高质量重建指明了路径。
本文由资深学术技术主编解读,深入剖析 AI 顶会最新成果。