
AOPD:破解在线蒸馏的“探索黑洞”,在 Token 级弥合剥削与模仿
Asymmetric On-Policy Distillation: Bridging Exploitation and Imitation at the Token Level
本文提出了一种名为非对称在线蒸馏(AOPD)的 Token 级训练方案,旨在优化大语言模型的数学推理能力。该方法通过在非正优势区域引入局部散度最小化,显著提升了 Qwen3 等模型在 AIME 等竞赛级数学基准上的表现。
TL;DR
传统的在线蒸馏(On-Policy Distillation, OPD)虽然解决了训练与推理的不匹配,但其策略梯度更新在处理“错误路径”时极度低效。本文提出的 Asymmetric On-Policy Distillation (AOPD) 通过一个简单的直觉解决此问题:做对的时候给予强化,做错或迷茫的时候直接教它正确的分布。 在数学推理任务中,AOPD 显著提升了模型的收敛速度和性能上限,特别是在基础能力较弱的情况下表现尤为稳健。
背景定位:OPD 的结构性瓶颈
在线蒸馏(On-Policy Distillation)是当前提升 LLM 推理能力的 SOTA 范式之一。它允许学生模型在自己生成的链条上接受教师的 Token 级反馈。然而,作者通过深入分析发现,基于优势(Advantage)的更新存在三大病灶:
- 高方差的负向惩罚:当学生算错且概率极低时,Advantage 会变得极大,导致梯度爆炸。
- 零优势区的停滞:对于大量中性 Token,梯度几乎为零,模型学不到教师的细粒度偏好。
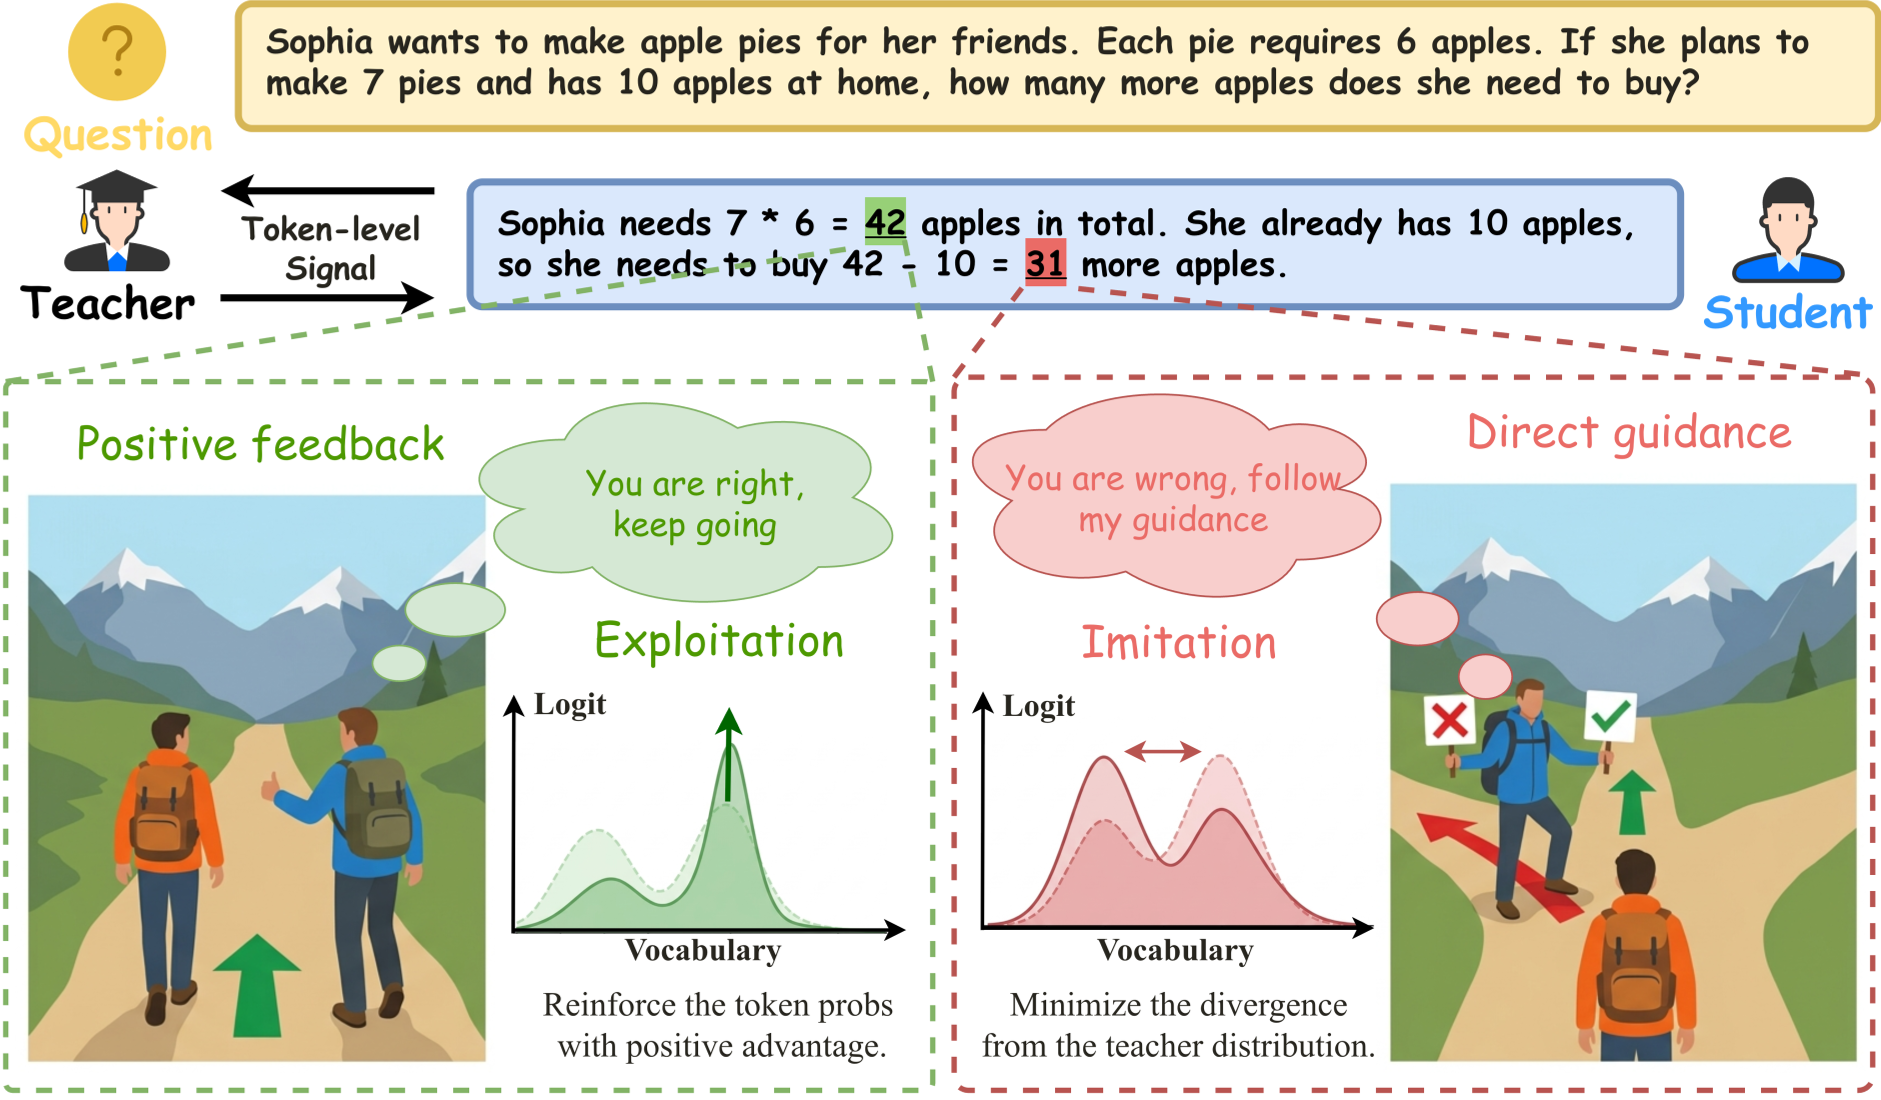
- 探索黑洞 (Exploration Black Hole):当模型完全不知道正确路径时,只通过减小错误路径的权重(负强化)并不能让正确的 Token 冒出来,模型陷入盲目摆动。
核心逻辑:何为“非对称”?
AOPD 的核心在于动态切换更新机制。在每个 Token 位置 ,模型会计算一个优势值 :
- 逻辑 A ():模型走在正确的道路上,使用标准的 策略梯度 (Policy Gradient) 进行强化,鼓励模型继续 Exploitation。
- 逻辑 B ():模型可能走偏或陷入迷茫,此时不再进行负向惩罚,而是直接引入教师的 Top-K 前向 KL 散度 (Forward-KL) 进行局部指导。
这种设计利用 Forward-KL 的“均值寻求”特性(Mean-seeking),强行拉高那些被学生模型低估但被教师看好的候选 Token 概率,直接填补了“探索黑洞”。
实验与结果
研究人员在 Qwen3 系列模型上进行了详尽测试。
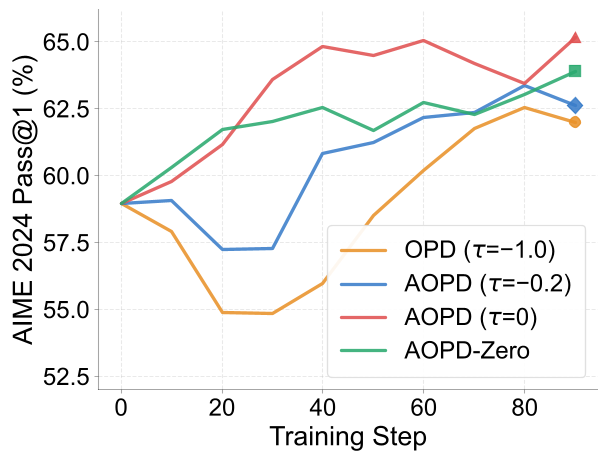
- 数学推理性能:在 AIME 2024 等高难度 benchmark 上,AOPD 展现了极强的统治力。尤其是在弱初始化(1K 步温热)下,标准 OPD 会因初期梯度不稳定而出现“性能雪崩”,而 AOPD 则能保持稳步上升。
- 持续学习与遗忘控制:一个令人惊喜的发现是,由于 AOPD 的更新是“局部的”且带有教师分布的平滑性,它在学习新任务(如 Tool-use)时,能更好地保留之前的数学推理能力,不仅没有灾难性遗忘,甚至在某些指标上有所提升。
深度洞察:为什么前向 KL 是最优选?
论文详细讨论了散度的选择。在被截断的 Top-K 教师支持集(Support Set)上,前向 KL (Forward KL) 比反向 KL (Reverse KL) 更稳定。因为前向 KL 的梯度是由教师概率直接加权的概率差 ,这自然地约束了梯度的大小,避免了策略梯度中常见的尺度不一致问题。消融实验也证实,(完全的前向 KL)能带来最平滑的梯度轨迹和最高的性能。
总结与未来启示
AOPD 的意义在于它打破了 RL 和 SL 的次元壁。它告诉我们:单纯依靠反馈信号(Reward/Advantage)是不够的,尤其是在搜索空间巨大的 Token 级别。有效的方法应该在“模型知道自己在干什么”时放手让它探索,在“模型不知所措”时给予明确的 Distributional Guidance。 这种非对称的优化思路,对于未来开发更高效、更鲁棒的推理模型具有重要的指导意义。