
ATMANRL:让 LLM 的推理不再是“皇帝的新衣”——基于可微注意力的忠实度学习
AtManRL: Towards Faithful Reasoning via Differentiable Attention Saliency
本文提出了 ATMANRL,一种通过强化学习(RL)提升大语言模型(LLM)推理忠实度的方法。该方法利用可微注意力操纵技术,在 GRPO 框架下识别并奖励对最终答案有实质因果贡献的推理 Token,显着减少了思维链(CoT)中的冗余内容,同时保持了 SOTA 级别的准确率。
TL;DR
在学术界,大语言模型(LLM)的思维链(CoT)推理能力一直饱受“忠实度(Faithfulness)”的质疑:模型给出的推理过程,真的指导了它得出答案吗?还是仅仅在信口开河地进行“后验补全”?
来自 Aleph Alpha 研究实验室和达姆施塔特工业大学的研究者们发表了 ATMANRL,提出了一种新颖的机制:通过**可微的注意力操纵(Differentiable Attention Manipulation)**来测量推理 Token 对答案的因果贡献,并将其作为强化学习(RL)的奖励。实验证明,该方法能将推理长度减少近 50%,同时保持准确率,让推理过程更干练、更具因果性。
1. 痛点:CoT 到底是在思考还是在演戏?
目前的 CoT 训练(如通过 GRPO 框架进行强化学习)主要依赖于 Outcome-based Reward(结果奖励)。这意味着只要最后答案对了,不管推理日志(Trace)里写了多少废话,甚至写错了逻辑,模型都会受到奖励。
这种机制导致了两个严重问题:
- 冗余性:模型倾向于生成长篇大论的废话来增加预测的“信心”。
- 非忠实性:推理 Token 与最终决策之间缺乏因果联系,形成了所谓的“幻觉推理”。
作者的核心直觉是:如果一个推理 Token 对答案真的有贡献,那么当我们抑制对它的注意力时,正确答案的概率应该显著下降;反之,如果我们能通过优化找到一种掩码来“恢复”由于干扰而丢失的概率,这个掩码的强度就代表了该 Token 的显著性(Saliency)。
2. 核心方法:可微注意力掩码
ATMANRL 的核心在于将传统的特征归因问题转化为一个优化问题。
2.1 从 ATMAN 到可微掩码
传统的 ATMAN 技术通过在 Softmax 之前向注意力分数 添加一个掩码 来干预模型:
在 ATMANRL 中,研究者不只是手动设置这个掩码,而是将其作为可学习的参数。
2.2 训练流程
- 初始化抑制:首先给所有的推理 Token 施加一个负向常数掩码 ,这会强制模型“忘记”推理内容,导致答案概率下降。
- 梯度优化:固定模型参数,仅更新掩码 ,目标是最小化正确答案的交叉熵损失。简单来说,就是寻找“哪些 Token 是必须被重新关注,才能把正确答案找回来”。
- 奖励生成:优化后的平均掩码值即为 Faithfulness Reward。
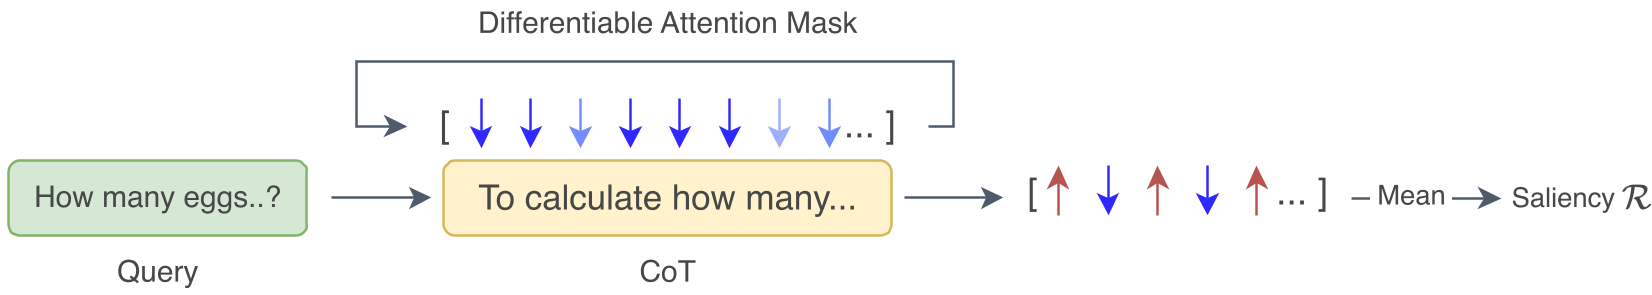 图 1:ATMANRL 训练机制:通过优化掩码来识别对答案贡献最大的推理 Token。
3. 实验结果:去粗取精,极致压缩
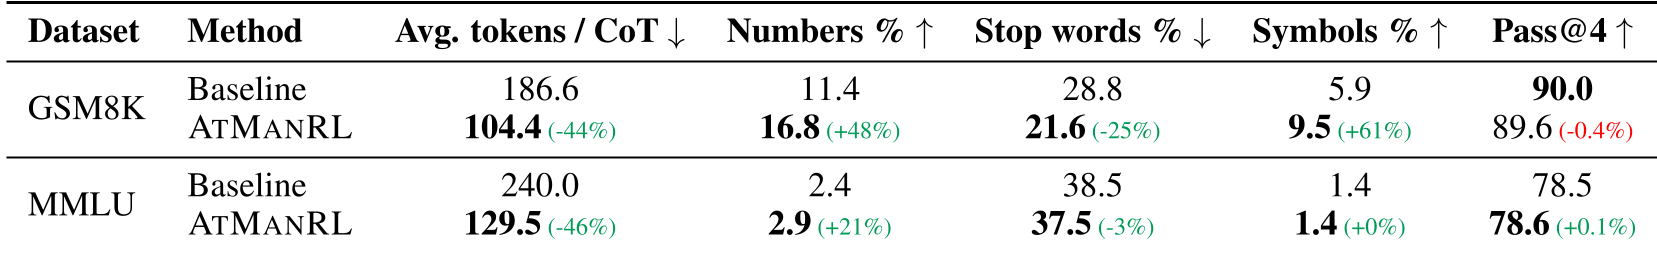
研究者使用 Llama-3.2-3B 在数学竞赛数据集 GSM8K 和综合学科数据集 MMLU 上进行了验证。
3.1 效率与准确率的平衡
结果显示,ATMANRL 达成了一个惊人的平衡:
- 推理长度大幅缩减:GSM8K 减少了 44% 的 Token,MMLU 减少了 46%。这意味着推理成本直接减半。
- 性能基本持平:在推理步数显著变短的情况下,Pass@4 的准确率几乎没有波动(GSM8K -0.4%,MMLU +0.1%)。
3.2 语言风格的本质转变
通过对 Token 类型的统计发现,ATMANRL 驱动模型进行了“职场进化”:
- 减少废话:停用词(Stop words)比例显著下降。
- 增加干货:在数学任务中,数字和符号的比例分别提升了 48% 和 61%。
- 因果聚焦:模型不再进行描述性的旁白,而是直接跳转到具体的逻辑计算。
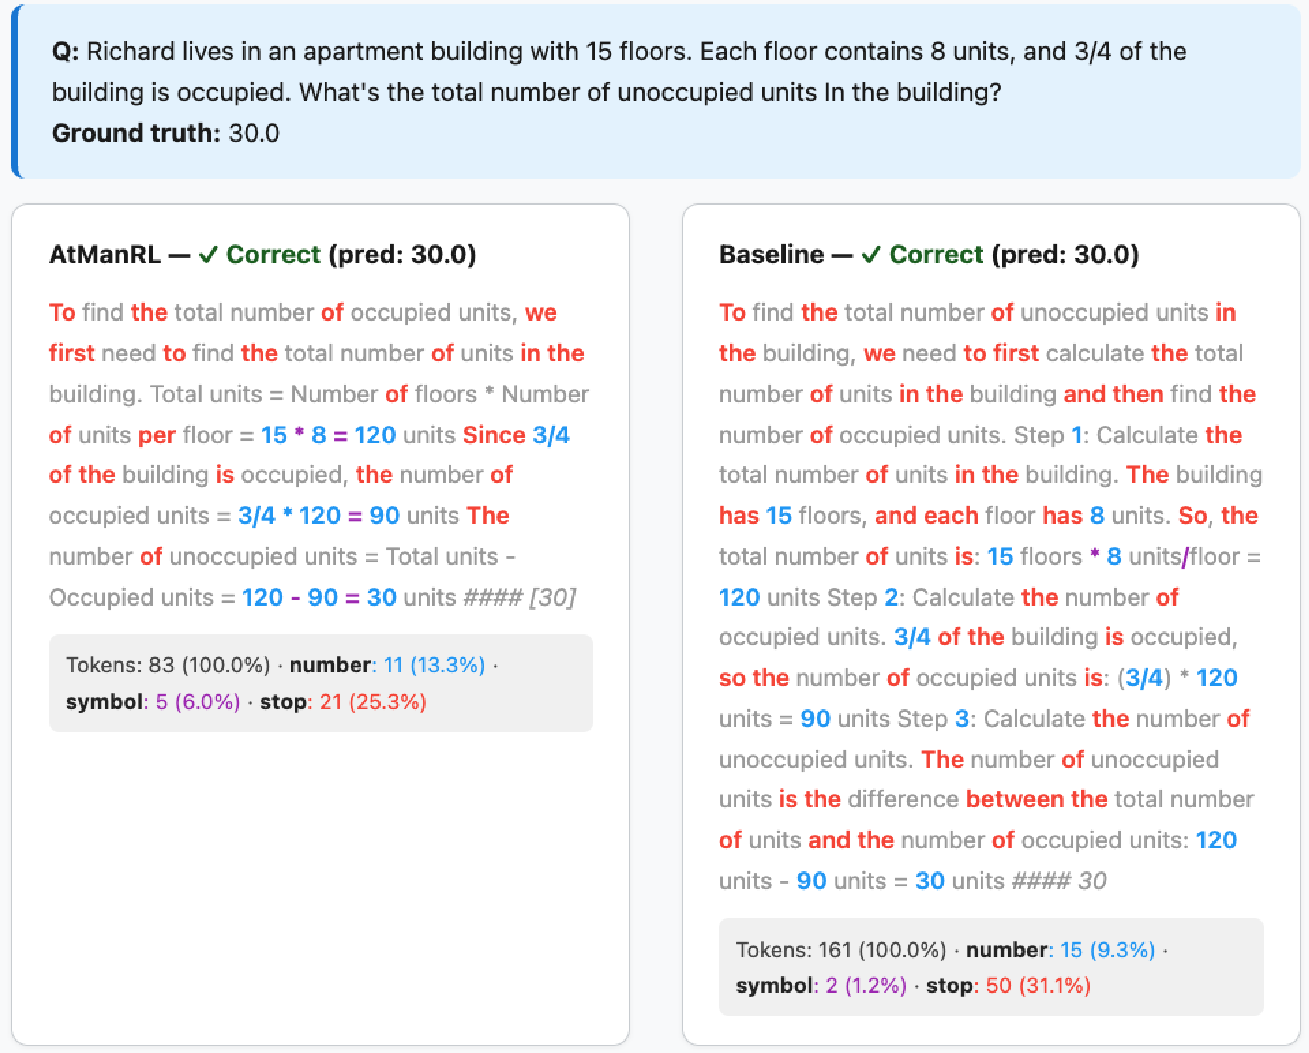 图 2:Baseline vs ATMANRL。可以看出 ATMANRL 生成的内容更加紧凑,避开了无意义的文本修饰。
4. 深度洞察与总结
总结 (Takeaway)
ATMANRL 证明了推理的显著性(Saliency)是忠实性(Faithfulness)的必要条件。通过在 RL 循环中引入基于因果干预的显著性奖励,我们可以显著提升 LLM 的推理效率,并迫使模型生成那些真正参与决策的 Token。
局限性与挑战
尽管 ATMANRL 在压缩推理方面表现出色,但也存在一个值得探讨的潜在风险:它是否会“扼杀”模型的反思能力? 最近 OpenAI o1 等模型的成功表明,自我纠错(Backtracking)和思维反复(Wait, let me rethink...)对于复杂问题至关重要。这类 Token 在显著性测量中可能被判定为“对最终正确答案贡献度低”(甚至是负贡献),从而被 ATMANRL 惩罚。
未来方向:如何设计更精细的奖励函数,将“有效的思维转折”与“无意义的废话”区分开来,将是提升推理忠实度的下一个战场。
参考文献: Henning Höth, M., et al. (2025). ATMANRL: Towards Faithful Reasoning via Differentiable Attention Saliency.