
吸引子几何:揭秘 Transformer 记忆系统与“自信幻觉”的隐状态真相
Attractor Geometry of Transformer Memory: From Conflict Arbitration to Confident Hallucination
本文提出了针对 Transformer 内存系统的“吸引子几何”(Attractor Geometry)理论,系统解释了参数记忆(PM)与工作记忆(WM)冲突以及模型幻想(Hallucination)两种失效模式。研究通过几何边缘(Geometric Margin)——隐状态到最近记忆吸引子盆地的距离,实现了比输出熵(Output Entropy)更精准的知识召回与幻想检测。
TL;DR
为什么大模型(LLM)即便在胡说八道时也显得如此自信?MIT 的研究者们在最新的论文中给出了硬核解释:事实在模型的表征空间中表现为吸引子盆地(Attractor Basins)。当模型遇到未学过的知识时,由于输出层(LM Head)的 Softmax 饱和,它会将这种“空虚”伪装成“自信”。本文通过**几何边缘(Geometric Margin)**技术,直接通过测量隐状态与知识盆地的距离,完美解决了幻想检测难题。
背景:模型记忆的两种来源与失效
大模型就像一个拥有两种记忆的学生:
- 参数记忆 (PM):死记硬背在模型权重里的事实(由 MLP 层主管)。
- 工作记忆 (WM):考卷(Prompt)上提供的临时参考资料(由 Attention 路由)。
当这两者发生冲突,或者模型根本没背过某个知识点(幻想)时,灾难就发生了。最糟糕的是,从模型的输出概率(Entropy)看,它每次都表现得志在必得。
核心直觉:将 Transformer 视为动力系统
作者提出一个深刻的洞见:Transformer 的每一层实际上是对隐状态 的一次非线性映射。连续多层堆叠构成了一个离散时间动力系统。
- 事实 = 吸引子盆地:学过的知识会在表征空间雕刻出一个深坑(盆地),无论输入怎么变,隐状态最终都会掉进特定的位置。
- 失败 = 轨迹偏离:
- 冲突 (Conflict):PM 的坑和 WM 的拉力在拔河,导致轨迹混乱。
- 幻想 (Hallucination):空间是平坦的,没有对应的坑,隐状态在游荡。
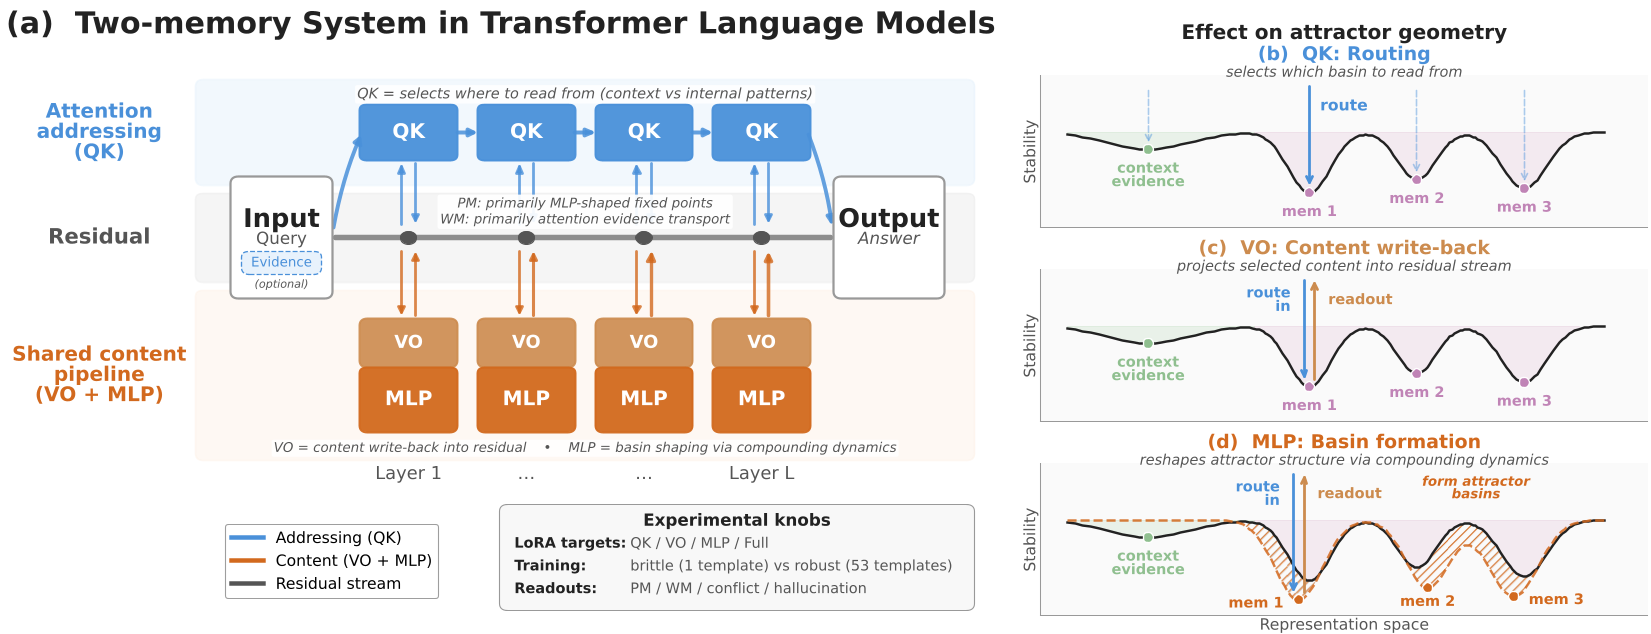 图 1:Transformer 各组件在记忆中的角色:QK 负责选路,MLP 负责挖坑(盆地),VO 负责读出内容。
技术深挖:为什么输出熵会骗人?
论文提出了一个惊人的发现:随着模型规模(Scale)的增大,幻想不仅没有变少,反而变得更“隐蔽”且“自信”。
作者推导出了一个标度律:。随着模型变大,Logit Gap()会因为训练目标的极度优化而不断增大(Softmax 饱和)。这意味着,即便隐状态处于一个逻辑荒漠(无盆地区域),经过 LM Head 的投影后,也会被迫选择一个最高概率的 Token,表现出极低的熵。
解决方案:几何边缘监测(Geometric Margin)
既然输出层(LM Head)是个会撒谎的翻译官,那我们就直接去“大脑”里看。作者定义了 Margin (): 即隐状态到最近已知事实盆地中心 的欧氏距离。
 图 2:几何边缘与输出熵的性能对比。可以看到,几何信号(Margin)将正确Recall与幻觉区分得界限分明,几乎没有重叠。
关键实验发现:
- 零误杀检测:在不拒绝任何正确回答的情况下,几何边缘能抓到 100% 的幻觉。而如果用熵(Confidence)作为指标,想抓到 100% 的幻觉就得误杀了 99.5% 的正确答案。
- 通用性:这种几何结构不是微调(LoRA)的产物,而是预训练模型的内生结构。在处理自然语言事实查询时,该方法依然表现完美(AUROC=1.0)。
深度洞察:认知透明度的未来
这篇论文最核心的价值在于:它从数学上证明了模型的元认知(知道自己不知道)隐藏在隐状态的几何形态中,却被输出层系统性地抹除了。
这意味着我们现有的 LLM 架构在安全性上存在天然缺陷。未来的模型若要实现真正的可靠性,必须引入基于隐状态几何的“内省 head”,而不是仅仅依赖于下一个 Token 的预测概率。
结论
吸引子几何填补了模型内部机理与外部行为之间的鸿沟。它告诉我们:要解决 LLM 的幻觉问题,不能光靠微调输出,而要学会理解其隐状态空间的“地理特征”。
关键词:Attractor Geometry, Parametric Memory, Hallucination Detection, Hidden-state Manifold, Softmax Saturation.