
归因引导:赋予大语言模型持续学习的“语义觉醒”
Attribution-Guided Continual Learning for Large Language Models
本文提出了针对大语言模型(LLMs)的归因引导持续微调框架(Attribution-Guided Continual Learning)。该方法通过改进的 LRP(层级相关性传播)算法,精确估算 Transformer 各层参数在特定任务中的重要性得分,并利用这些得分动态调制权重梯度,从而在学习新任务时有效保留旧知识。
TL;DR
通过“解剖”Transformer 每一层参数对任务预测的贡献度,本文提出了一种全新的持续学习框架。它不仅能让 LLM 学习新技能,还能像人类大脑一样,精准识别并封存那些对旧知识至关重要的参数,从而彻底解决“学了新课忘旧课”的灾难性遗忘难题。
背景定位:从“粗放约束”到“精准归因”
在持续学习(Continual Learning)领域,我们一直面临一个悖论:为了让模型学得快,我们需要参数具有高可塑性;为了让模型记得牢,我们需要参数具有稳定性。
过去的方法(如微调部分层、EWC 正则化等)往往假设参数的重要性是均匀分布的,或者仅仅基于梯度二阶矩(Fisher 信息)来估算。而本文认为,参数的重要性是具有任务语义的。作者通过实验发现,在独立训练时,不同任务关注的参数极少重叠;但在传统的持续学习中,这些参数会发生严重冲突,导致新任务的梯度“强拆”了旧任务的知识基座。
核心直觉:如何精准锁定“功勋参数”?
作者的灵感来源于可解释性 AI 中的 LRP (Layer-wise Relevance Propagation)。
1. 从输入归因到参数归因
传统的 LRP 是为了分析“输入图片中哪个像素决定了分类”。本文通过数学推导(Lemma 4.1),将其扩展到了参数维度。它回答了一个关键问题:在 FFN 或 MHA 模块中,某个具体的权重矩阵元素对最终生成的概率贡献了多少?
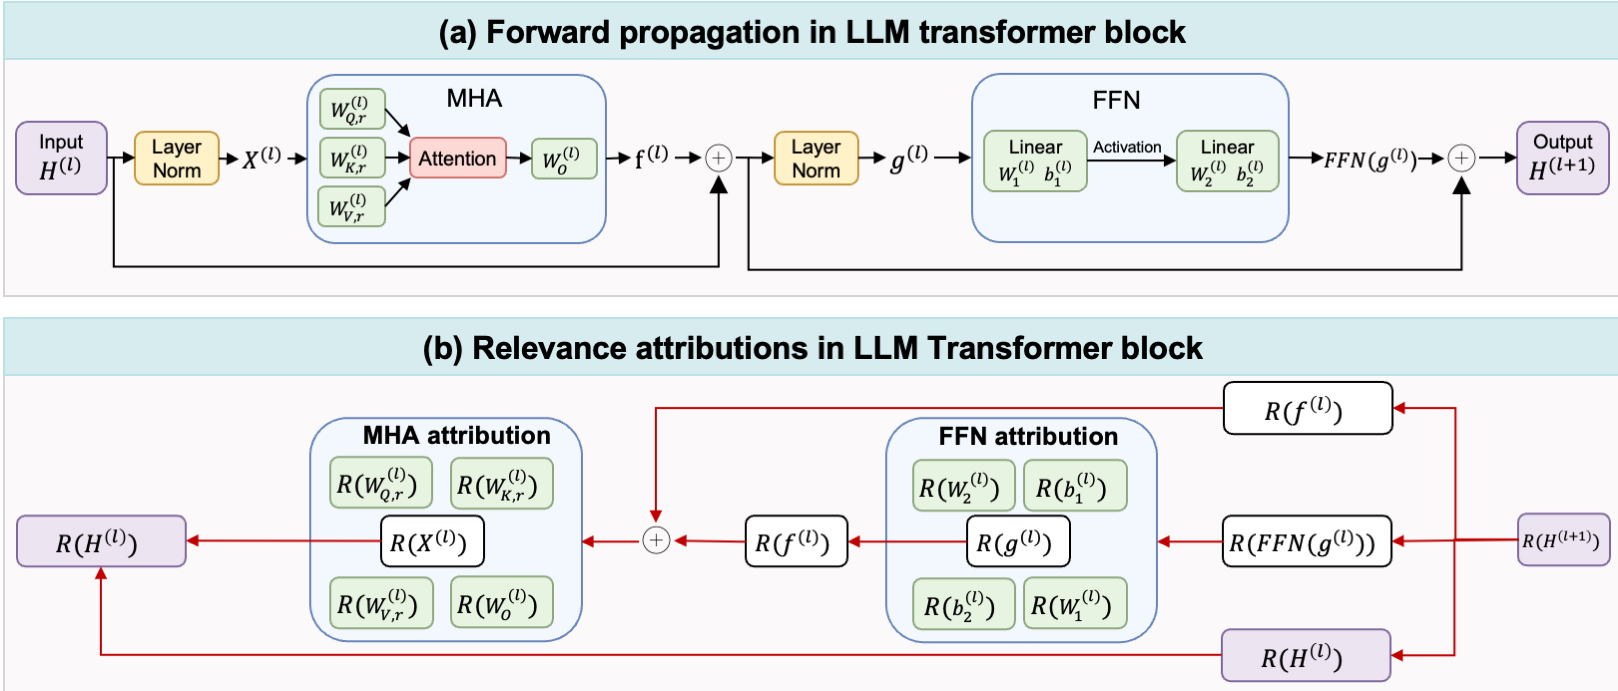
2. 梯度门控机制 (Gradient Gating)
一旦获得了参数重要性图谱 ,持续学习就变成了一个简单的“保护机制”:
- 高相关性参数:门控关闭,梯度 ,保护旧知识。
- 低相关性参数:门控开启,自由更新,吸收新任务。
这种基于 的动态调整,确保了模型在微调过程中,梯度的流向始终避开了知识的“红线区”。
实验战绩:知识保留的质变
作者在 Llama-3 系列模型上进行了验证。通过对比单任务与持续学习任务的参数重叠度(Spearman 相关性),可以清晰看到新方法维持了任务间参数分布的独立性性。
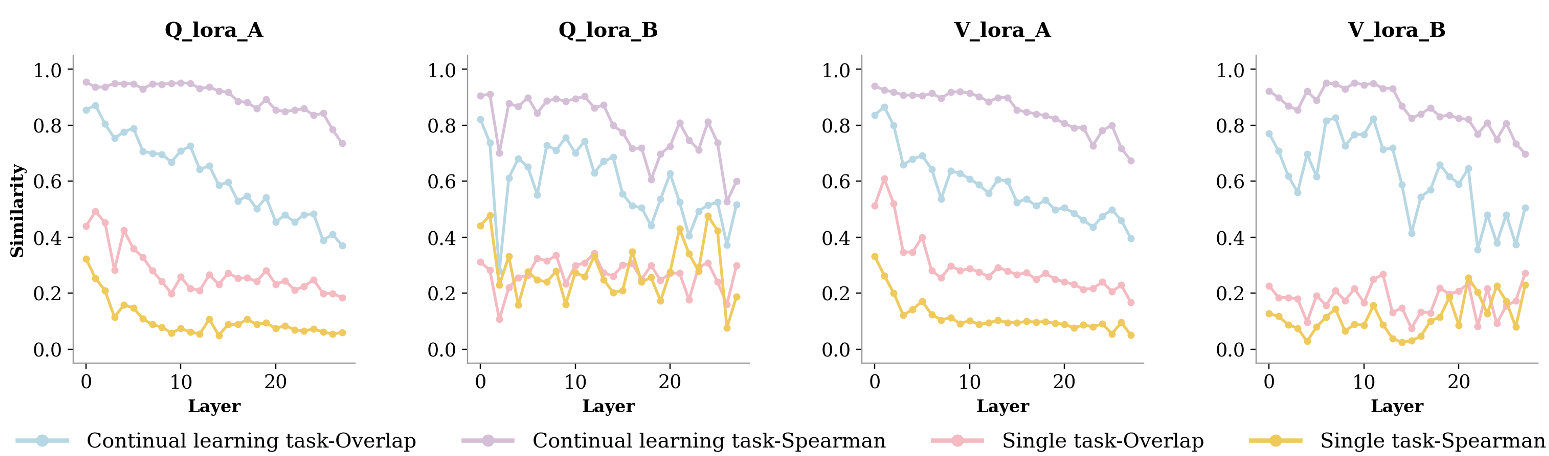
在主流的持续学习榜单上,该方法不仅在摘要生成(Summary)和代码补全(Code Completion)等任务序列中打破了 SOTA,更重要的是,它在 LoRA 参数高效微调 场景下依然极其稳健。
深度洞察
该工作的本质提升在于将可解释性工具转化为训练约束。以往的 CL 研究试图寻找一个通用的“抗遗忘曲线”,而本文通过逐层、逐参数的归因计算,为每个任务定制了“保护罩”。
局限性与展望
- 计算开销:由于需要计算 LRP 的反向归因传播,在超大规模模型上初次生成重要性 Prior 的过程会增加一定的显存负担。
- 未来方向:能否将这种归因引导扩展到 LoRA-MoE 架构中?通过归因为不同的专家模块分发任务,或许能实现更完美的知识解耦。
总结
本文的工作标志着 LLM 持续学习正在从“盲目的统计正则化”转向“精细的语义干预”。对于需要频繁更新行业知识的垂直领域 LLM 而言,这种归因引导的方法提供了一条兼顾效率与记忆的可靠路径。