
音视频智能的十年演进:从特征对齐到因果世界模型
Audio-Visual Intelligence in Large Foundation Models
本文是 2026 年关于音视频智能(AVI)的系统性综述,通过大模型视角统一了感知、生成与交互三大支柱。文章提出了统一的分类法,涵盖了从音频同步、音视频問答(AVQA)到联合音视频生成(如 Meta MovieGen)等前沿 SOTA 技术。
TL;DR
在人工智能进入 2026 年的当口,由新加坡国立大学(NUS)等多家顶尖机构发布的这篇综述,宣告了音视频智能(Audio-Visual Intelligence, AVI)已从单纯的“特征拼接”正式迈入“全能模态交互(Omnit-modal Interaction)”时代。本文不仅梳理了从理解到生成的完整技术栈,更提出了一组深刻的未来议题:我们是否真的理解了“听见”与“看见”之间的因果联系?
1. 痛点深挖:为何音视频智能比想象中难?
过去的 AVI 研究往往被视为 CV 处理视频、语音识处理音频,最后做简单的特征融合。然而,现实世界中的音视频关系是非对称且动态且具有因果性的:
- 物理遮挡:你看不到墙后的电话,但能听到铃声(离屏声音感知)。
- 细粒度对齐:玻璃杯破碎的视觉瞬间必须与高频冲击波精确耦合,哪怕 100ms 的偏差都会造成严重的“恐怖谷效应”。
- 语义缺失:现有模型常通过文本捷径(Shortcuts)答题,而非真正观察音视频证据。
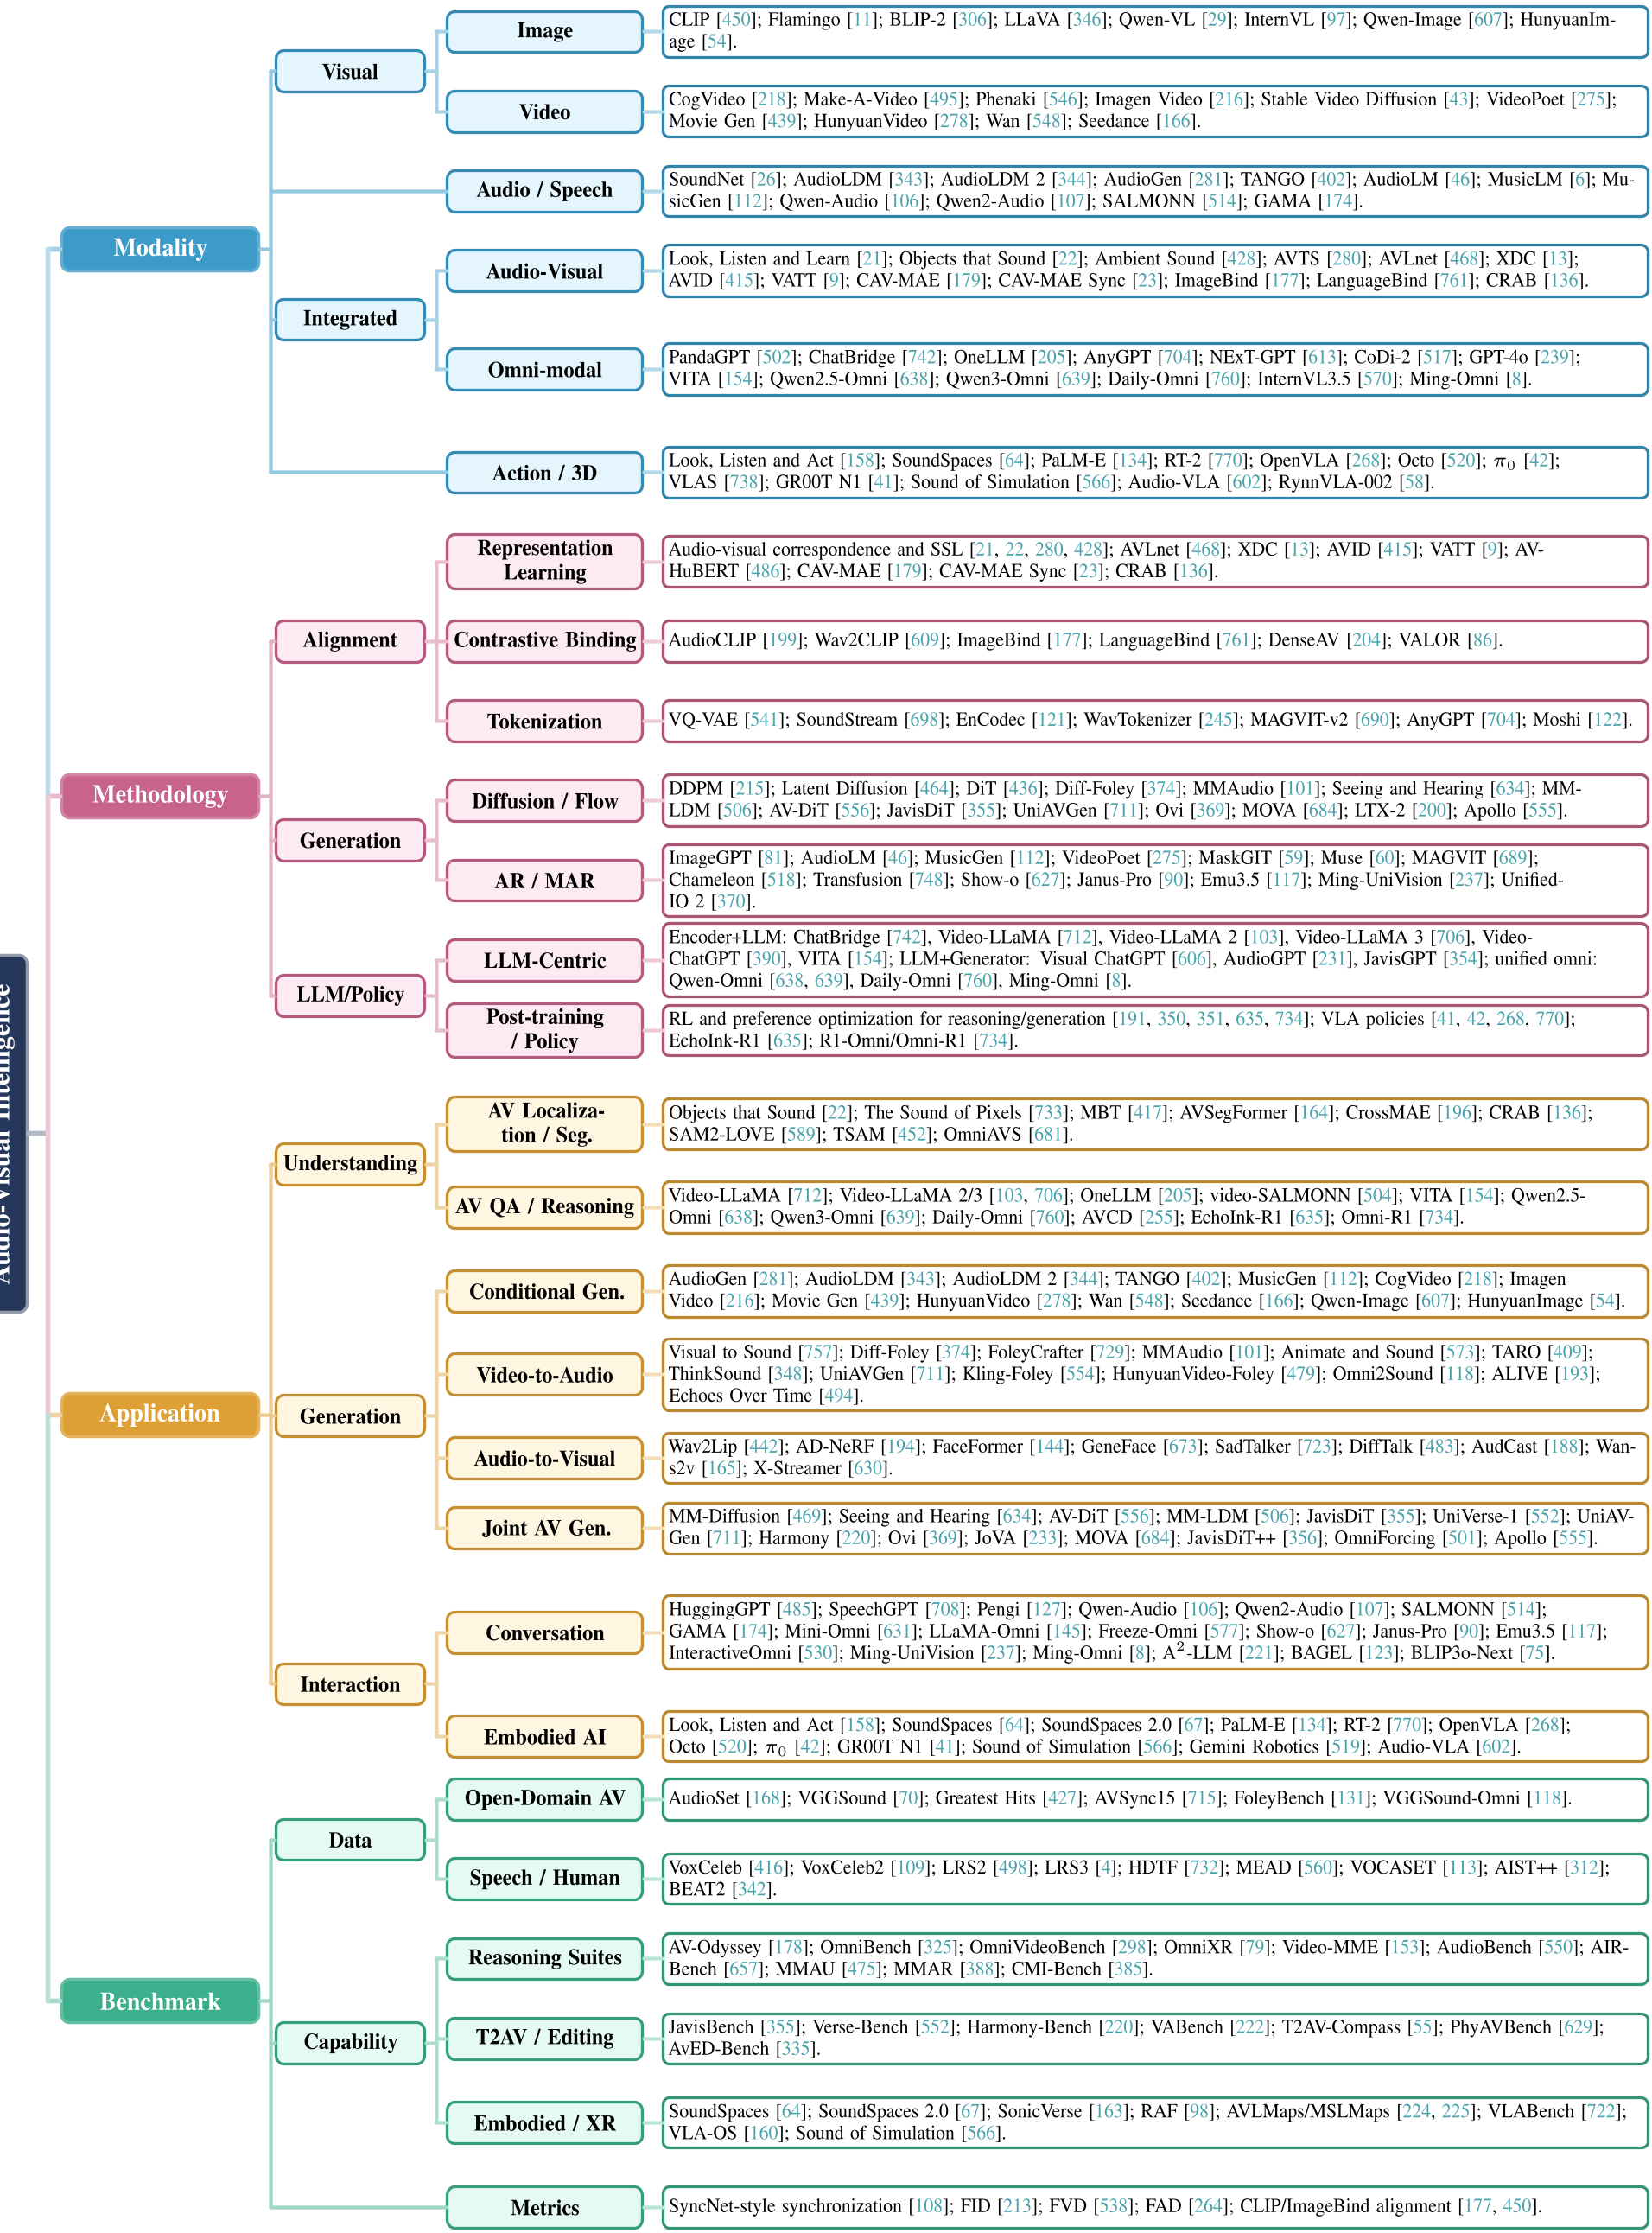
2. 核心架构:AVI 的三大技术支柱
论文将现有的基础模型(Foundation Models)技术路线归纳为三种范式:
2.1 以表示为中心的编码(Representation-centric)
通过 VQ-VAE 或类似的分词器(Tokenizer),将连续的波形和像素流离散化。这一步决定了模型能捕获多细微的物理交互。
- 音频端:从传统的梅尔频谱(Log-Mel)进化到了支持神经编解码器的离散 Token(如 EnCodec, WavTokenizer)。
- 视频端:利用超大规模预训练(如 CLIP, SigLIP)提取语义索引。
2.2 生成式核心(Generation-centric)
从 GAN 演进到目前统治级的 扩散模型(Diffusion) 和 流匹配(Flow Matching)。
- V2A(视频生音):不再只是背景音堆砌,而是通过对齐(Alignment-first)实现 Foley 音效的自动合成。
- 联合生成:Meta MovieGen 等工作标志着模型已经可以同时通过一个 Prompt 生成步调一致的情节与背景曲。
2.3 LLM 驱动的决策中心(LLM-centric)
这是目前最火的 "Encoder + Adapter + LLM" 架构。LLM 不再只是处理文字,而是作为“大管家”对音视频编码进行推理。
3. 进化树:从像素感知到逻辑推理
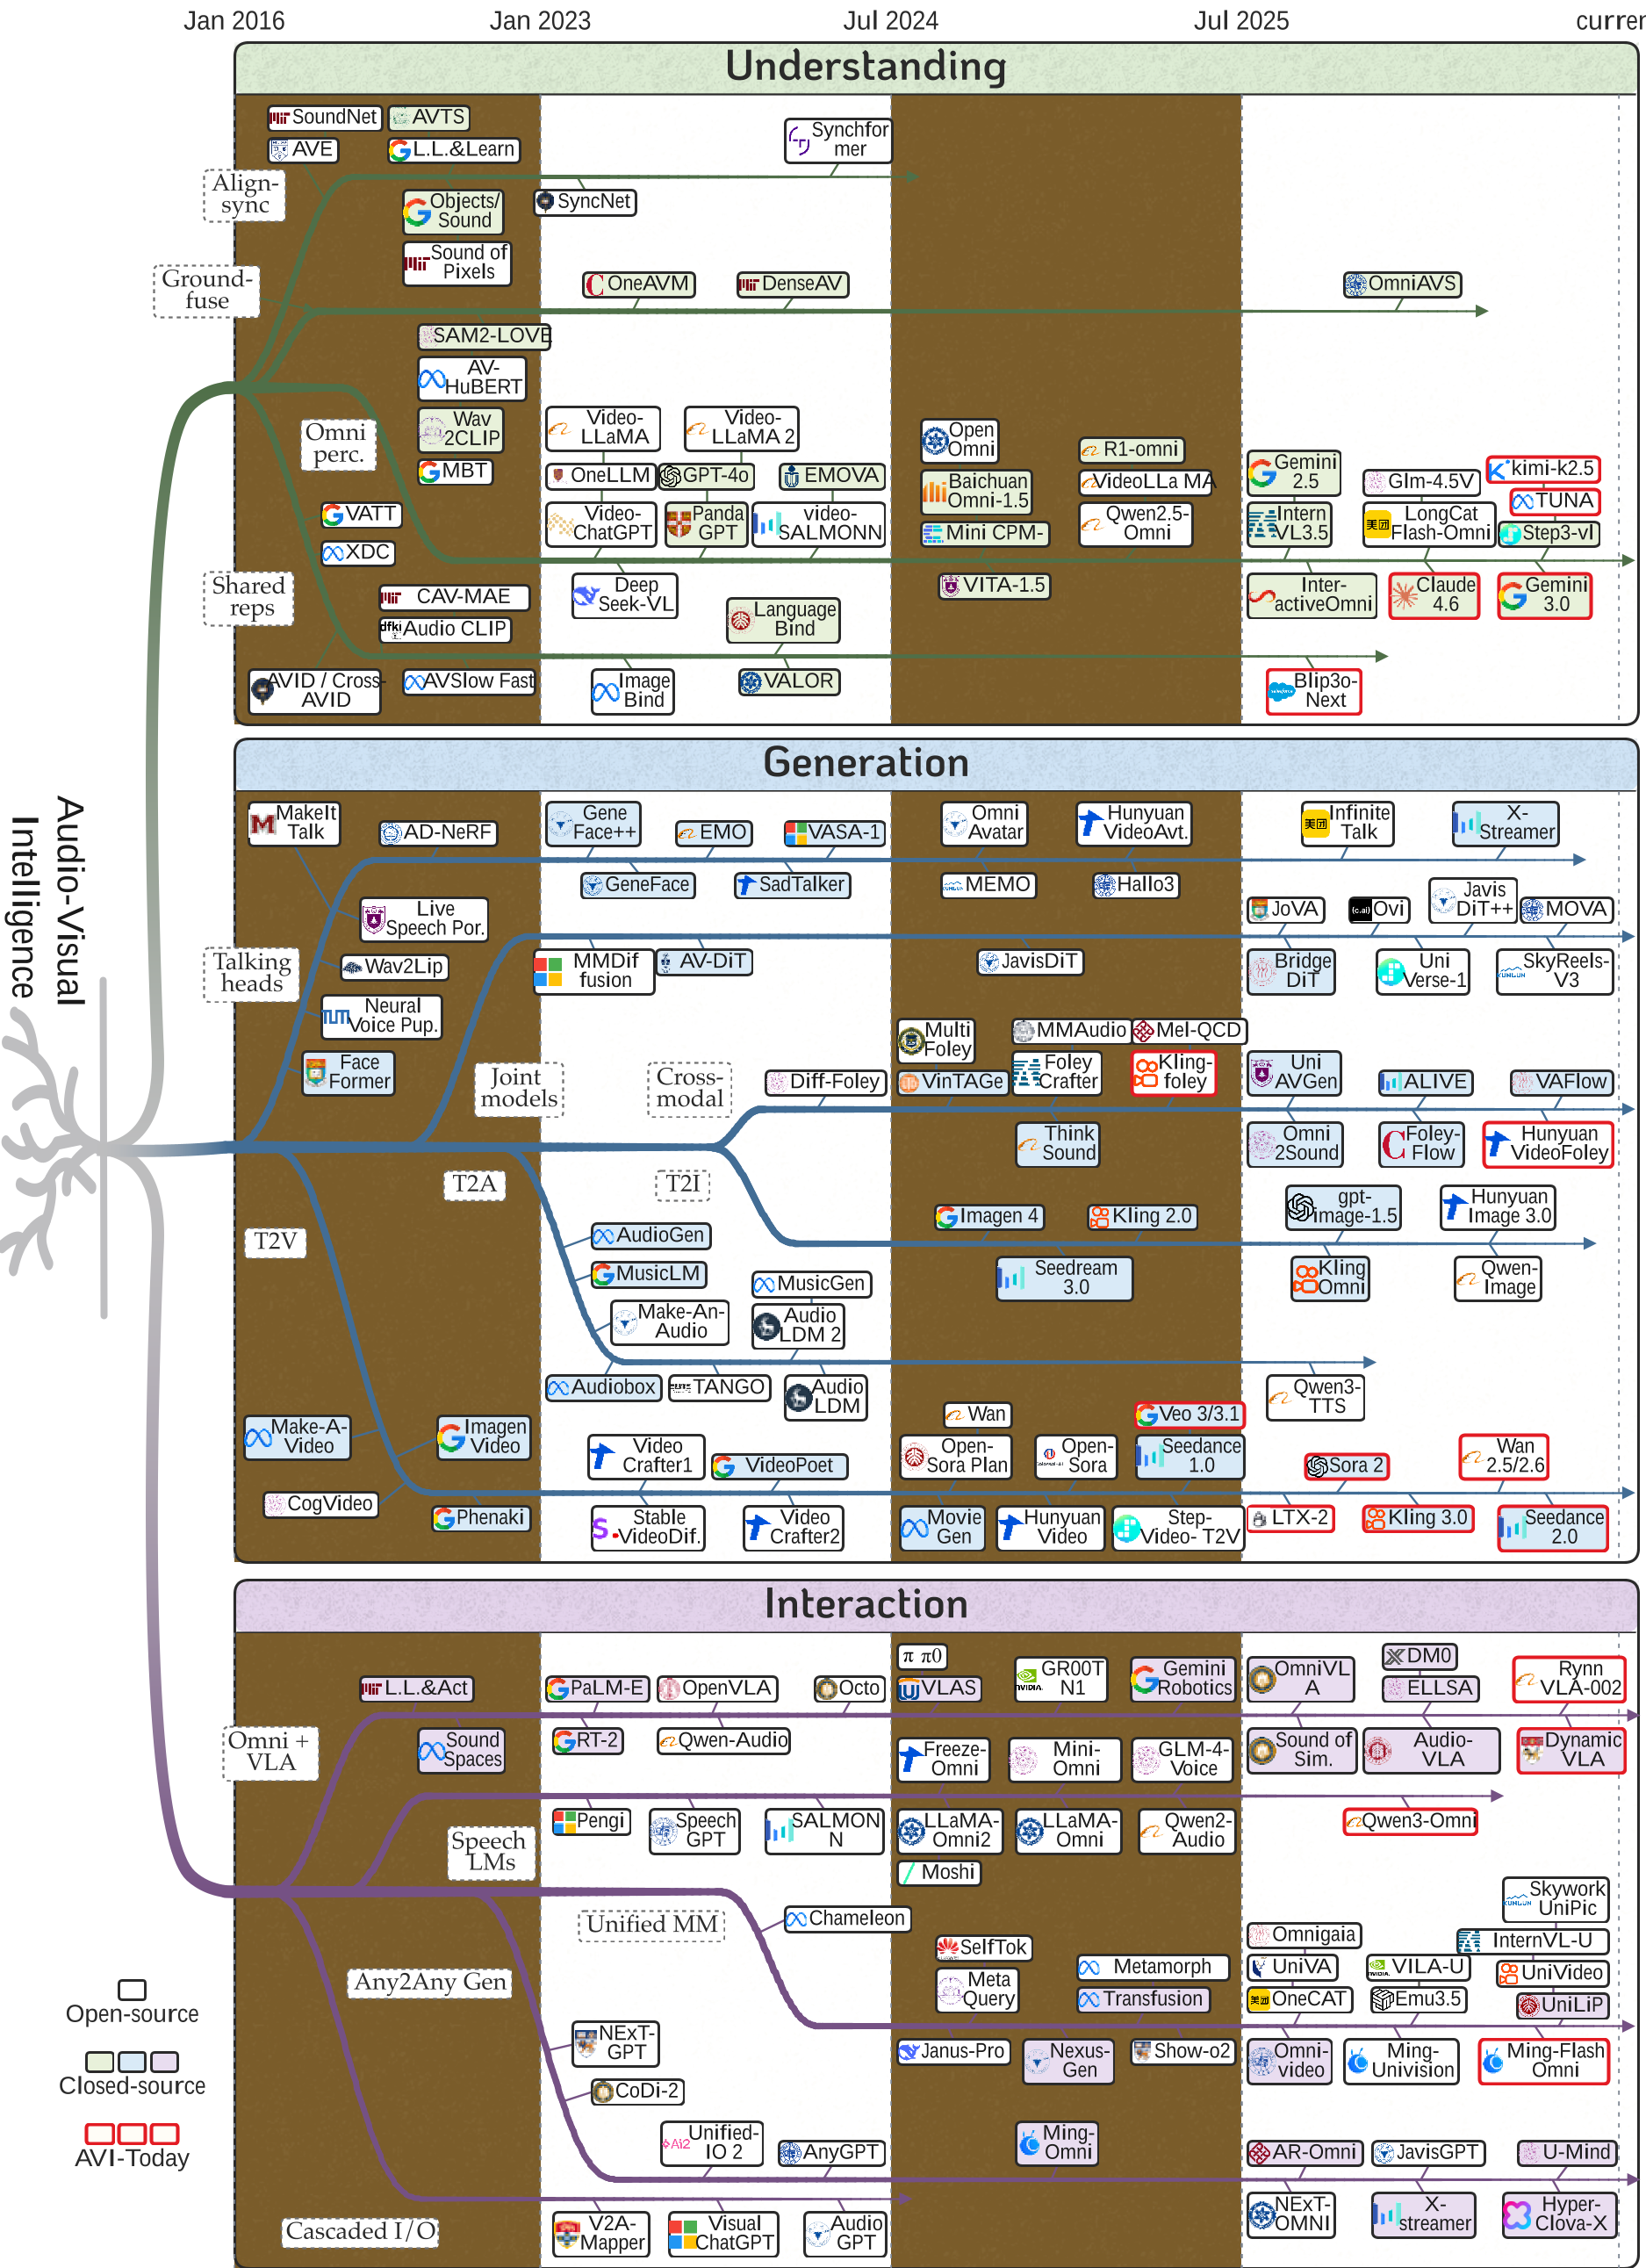
论文回顾了从 2016 年到 2026 年的进化史(见 Figure 1)。最初我们只关注“人脸是否对上了声音”(Lip-sync),而现在,我们追求的是:
- 音视频分割(AVS):在嘈杂环境中精确勾勒出发声物体的边界。
- 音视频问答(AVQA):模型必须听出“钢琴声是否断断续续”并结合画面给出结论。
- 具身智能(Embodied AI):机器人能够通过声音定位未见过的目标(Sound-guided Navigation)。
4. 实验结果:能力的增长与局限
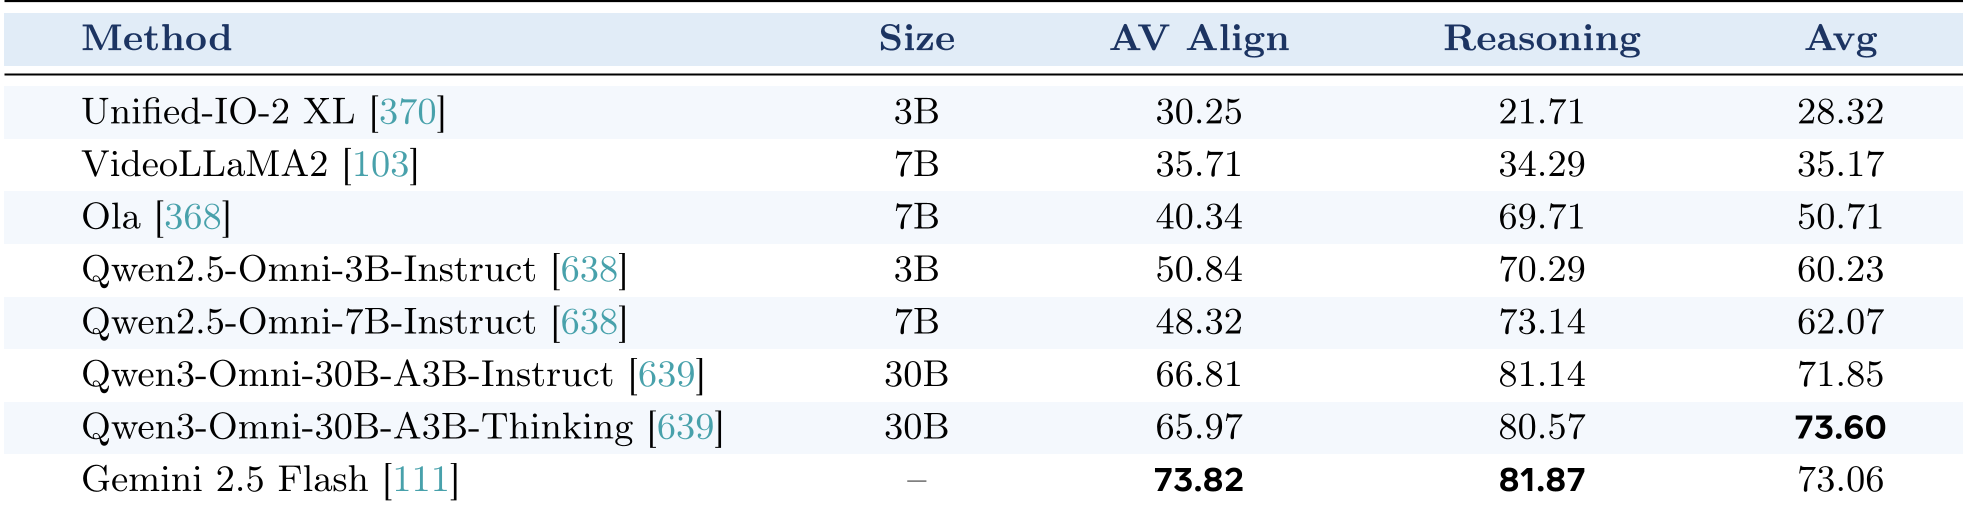
在多个 SOTA 模型(如 Qwen3-Omni, GPT-4o, VideoLLaMA 2)的对比中(见下表):
- 感知能力:在闭集分类任务上几乎满分。
- 推理能力:在 AURA 或 OmniVideoBench 等需要逻辑链的任务中,长文本退化现象严重。当视频长度超过 10 分钟,大部分模型的准确率呈断崖式下跌。
5. 深度洞察:AVI 的下一站是“世界模型”
综述指出了六个核心研究轴心,其中最启发人的是:从关联走向因果干预。
因果音视频干预(Causal AV Intervention) 意味着: 如果我在视频编辑中删除了一把吉他,模型不仅要去掉那个物体,还要在音频流中精准消除对应的声部,同时保留环境背景音。这种基于“因果图”的编辑,是目前单纯依靠 Attention 机制的模型难以实现的。
未来展望
- 分层存储记忆(Layered Memory):取代扁平的 Token 存储,建立类似人类的“语义-场景-证据”多层记忆结构。
- 物理验证器(Physics Verifier):目前的生成结果虽然好看好听,但常违背物理常识(例如声音比视觉动作先行)。引入具备物理直觉的 Reward 模型进行 DPO 优化将是关键。
总结
音视频智能正在走出实验室,进入我们的电影后期处理、养老机器人和虚拟现实硬件中。正如论文所言,AVI 的终极形态是一个能听、能看、能动的全能 Agent。这不仅是模态的融合,更是对真实物理规律的深度模拟。