
JoyAI-Image:通过空间智能觉醒,定义视觉理解与生成的统一新范式
Awaking Spatial Intelligence in Unified Multimodal Understanding and Generation
本文推出了 JoyAI-Image,这是一个统一的多模态基础模型,集成了视觉理解、文本生成图像、长文本渲染和指令引导的图像编辑。该模型通过耦合空间增强的多模态大语言模型 (MLLM) 与多模态扩散 Transformer (MMDiT),在多项基准测试中达到了 SOTA 性能,特别是在空间智能和几何一致性编辑方面表现卓越。
TL;DR
视觉模型的终极目标不仅是“看懂”或“画出”,而是理解物理世界的本质逻辑。京东 JoyAI 团队发布的 JoyAI-Image 构建了一个空间增强的统一架构,将 MLLM 的推理深度与 MMDiT 的生成精度完美融合。该模型不仅能渲染复杂的双语长文本,更能执行具备 3D 几何一致性的视角平移与物体旋转,甚至能通过“脑补”新视角来辅助回答复杂的空间逻辑问题。
背景定位:从“平面感知”到“空间智能”的跨越
目前的视觉模型大多停留在 2D 像素的统计关联上。当你要求模型“把镜头向左旋转 45 度”或“把桌间的橙子向后挪动 20 厘米”时,传统模型往往会发生形变甚至崩坏。JoyAI-Image 的核心贡献在于提出:**空间智能(Spatial Intelligence)**应当作为理解与生成任务之间的桥梁。
核心方法:两栖架构与 OpenSpatial 引擎
JoyAI-Image 的架构基于一个三阶段流水线:
- MLLM 认知层:基于 Qwen3-VL-8B,负责解析用户指令并提取深层语义和空间先验信息。
- VAE 隐空间层:负责像素到流形的压缩,保留高频纹理(如文字细节)。
- MMDiT 生成层:16B 参数的扩散 Transformer,接收来自 MLLM 的隐状态作为交叉注意力的引导。
为了喂饱这个架构,团队开发了 OpenSpatial 引擎,通过 3D Box 驱动的自动化管线合成空间理解数据。
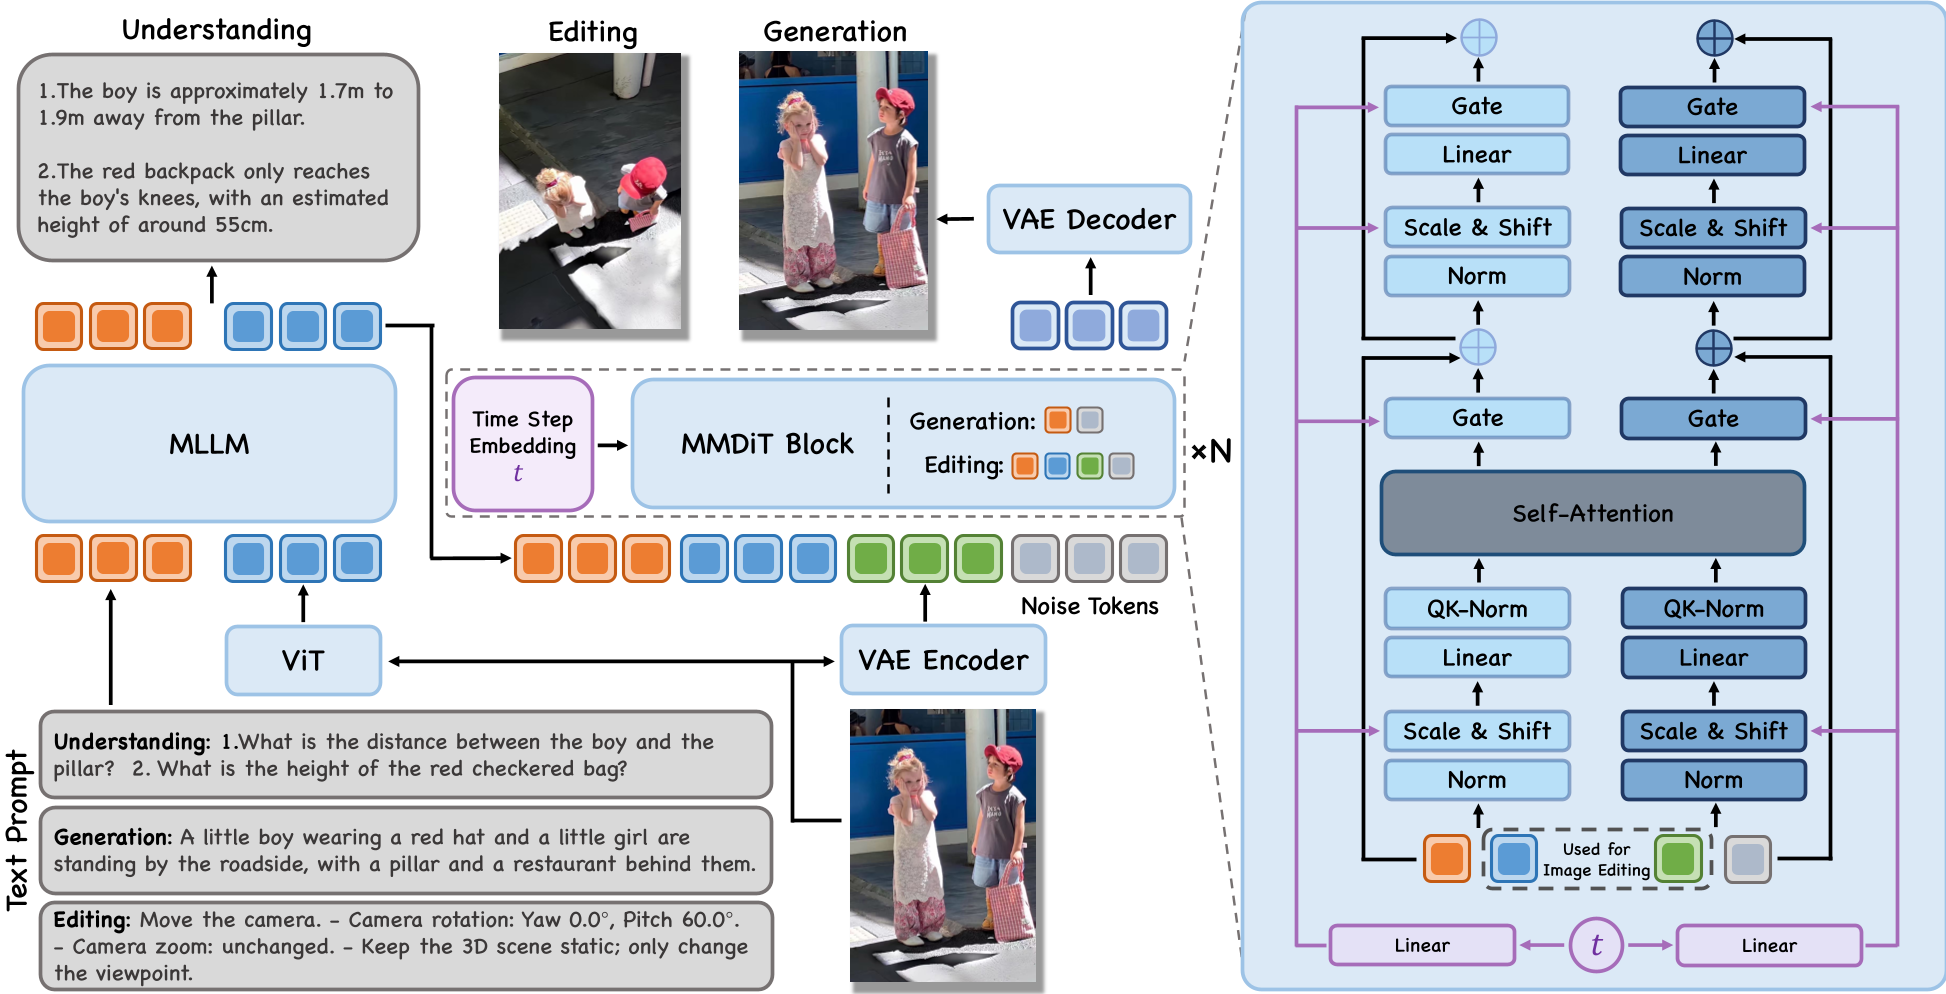 图 4:JoyAI-Image 整体架构,集成了 MLLM、VAE 和双流 MMDiT。
实验战绩:让 AI 拥有“立体感”
在 SpatialEdit-Bench 测试中,JoyAI-Image 表现惊人。它不仅超越了所有开源图像编辑模型(如 Flux, Qwen-Image-Edit),甚至在相机控制精度上优于专门的视频生成模型。
- 长文本渲染:在极具挑战性的中英双语海报排版任务中,模型精准保留了字体样式与位置,LongText-Bench 准确率接近满分。
- 多视角一致性:模型能生成物体的一系列旋转视图,并保持 ID(身份特征)完全一致,这对于 3D 重建具有极高价值。
 表 13:JoyAI-Image 在物体位移、旋转及相机视角控制上的定量领先优势。
深度洞察:Thinking with Novel Views (TwNV)
这是本文最令人兴奋的应用方向。既然模型具备了精准的生成能力,当某些空间问题无法在原始图片中看清时(例如:雨伞后面有灯吗?),模型会先调用生成模块“画出”从侧面看过去的视图,再由推理模块综合两张图给出答案。这种**“边想边画”**的能力,让模型在推理能力上实现了跨代级的提升。
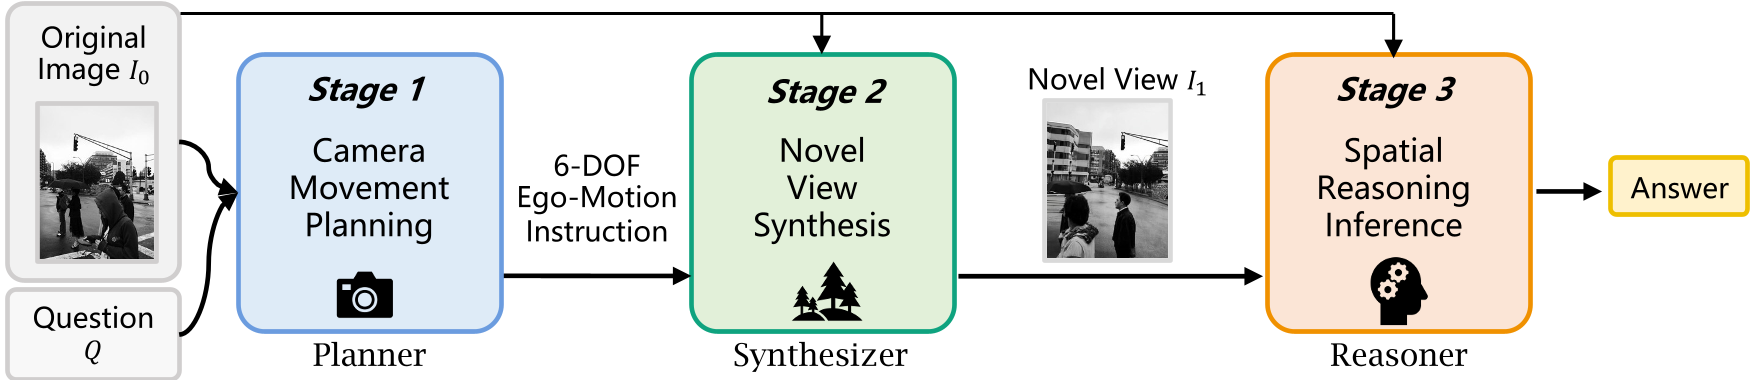 图 13:TwNV 管线展示了生成能力如何反哺空间推理。
总结与展望
JoyAI-Image 不仅仅是又一个“生成效果不错”的模型,它通过 OpenSpatial 引擎和 TwNV 推理范式,展示了如何通过强化空间几何约束来提升多模态模型的泛化性。
局限性:尽管模型在几何上非常强悍,但在极端的光影渲染自然度(Naturalness)上,相比某些顶级生成 baseline(如 Nano-Banana-2)仍有一丝差距,这或许是未来通过 RL(强化学习)进一步打磨的方向。
未来,这种具备空间智能的模型极有可能成为具身智能 (Embodied AI) 的大脑,让机器人真正看懂并能模拟物理世界的互动规则轨迹。