
回到柏拉图的洞穴:大规模跨模态表征收敛假设的崩塌
Back into Plato's Cave: Examining Cross-modal Representational Convergence at Scale
本文批判性地审视了“柏拉图表征假设”(Platonic Representation Hypothesis),即不同模态训练的模型在大规模数据下会趋于一致表征的观点。通过在百万级数据集(WIT-1M、LAION-15M)上进行互最近邻(mutual kNN)实验,作者发现模态间的对齐在大规模、多对多且非双射的现实数据中会大幅下降。
TL;DR
不久前,AI 界盛行一种浪漫的观点:正如柏拉图的“理型论”所述,无论让 AI 读书还是看图,随着模型变大和数据变多,它们最终都会学会以同一种方式理解现实。这一观点被称为 Platonic Representation Hypothesis。然而,来自 UC Berkeley 等机构的最新研究《Back into Plato’s Cave》给这一美梦泼了冷水。研究发现,当我们将评估规模从 1000 个样本扩展到 1500 万个样本时,所谓的“表征一致性”几乎消失殆尽。
背景:我们真的能殊途同归吗?
如果“表征收敛”是真的,那意味着计算机视觉(CV)可能不再重要,因为语言模型(LLM)通过文本也能学习到相同的世界结构。这种观点不仅具有哲学魅力,更有极高的工程价值。
然而,作者指出,之前的研究证据非常脆弱,主要受限于:
- 数据的稀疏性:在极小的样本库里,模型被迫成为了“由于没有更好的,所以选了同一个”的邻居。
- 双射假设(Bijective Assumption):现实世界并非一张图对应一个描述,而是“一图千言”或“一言映千图”的多对多关系。
痛点深挖:稀疏性带来的虚假繁荣
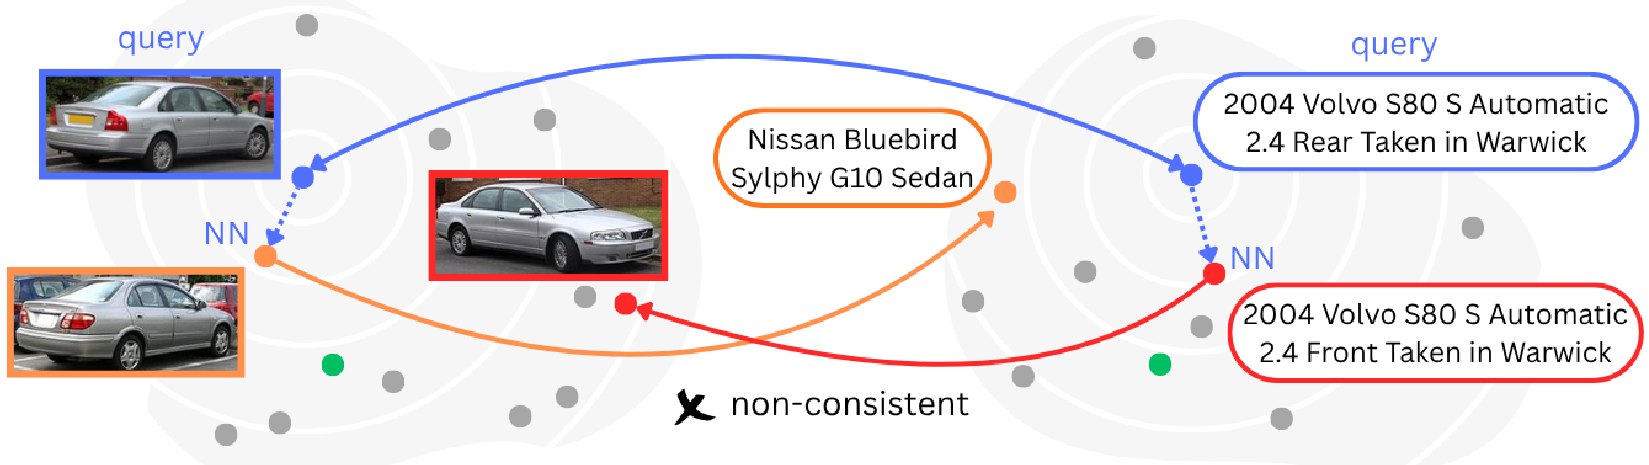
作者通过图示展示了 mutual kNN 度量标准的局限性。在小规模(稀疏)情况下,两个模型即使内部逻辑不同,也容易达成共识。但随着数据密度(Density)增加,视觉模型会倾向于搜寻姿态(Pose)相近的物体,而语言模型则搜寻含义(Semantics)相近的描述。
核心发现:数据规模是“表征”的照妖镜
1. 规模效应:对齐度的剧烈下降
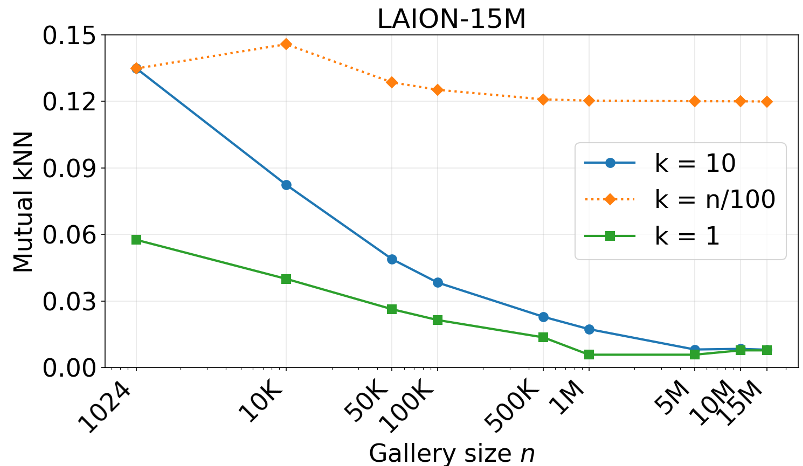
研究人员将检索库从维基百科的 1024 个样本扩展到了 LAION-15M。实验结果令人震惊:
- 在 1K 的小规模下,对齐度看似有 0.135。
- 在 15M 的大规模下,k=1 的对齐度直接跌到了 0.001。 这意味着在精细层面上,Imagenet 级别的模型根本没有达成共识。
2. 类内差异:即使都是找“狗”,每个人心中的狗也不同
通过在 ImageNet 上进行分解实验,作者发现:
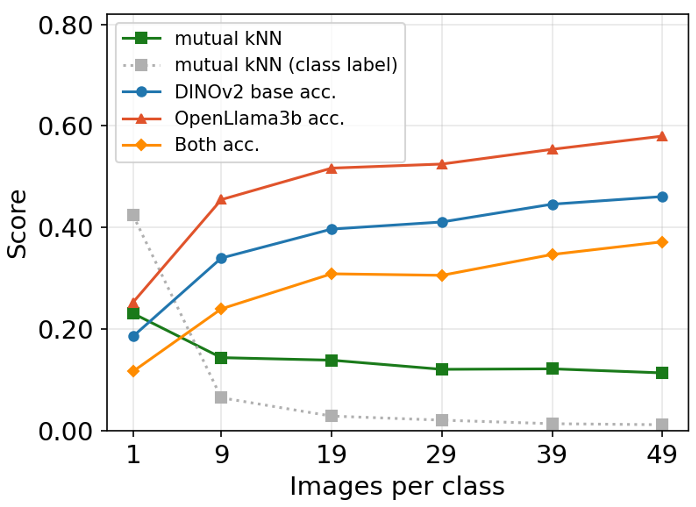
- 视觉模型(DINOv2)和语言模型(OpenLlama)在检索时,各自都能很好地命中“正确类别”。
- 但是,它们几乎从来不选这个类别里的同一样本! 这说明模型各自学到了丰富的结构,但这种结构是“模态特异”的,而非“现实统一”的。
3. 未被证实的趋势:强 LLM 不代表更向视觉靠拢
原假设认为,随着 LLM 的 Benchmark 分数提高,它会更接近视觉表征。作者通过评估 55 个 LLM(包括 Llama 3, Qwen 等)证明,这个趋势在最新的 SOTA 模型中已经饱和甚至失效。
深度洞察:从柏拉图回归到冯·尤克斯库尔
相比柏拉图的“理型”,作者更倾向于生物学家冯·尤克斯库尔提出的 Umwelt (感知环境) 理论:
- 每一个生命(模型)都根据其感官(模态)构建属于自己的感知世界。
- 蝙蝠的世界是回声构成的,壁虱的世界是热梯度构成的。
- 同理,视觉模型生活在空间、纹理和几何中,而语言模型生活在抽象、否定和组合语义中。
总结与局限
这项工作有力地反驳了“跨模态表征在大规模下必然收敛”的简单结论。它告诉我们,模态的选择至关重要——像素包含的信息,文字无法完全替代。
局限性:
- 虽然互近邻对齐下降,但并不排除存在某种复杂的、非线性的映射能够连接这些表征。
- 未来研究应关注如何界定“多模态交集”的大小,以及语言是否能作为图像重建的“无损瓶颈”。
这项研究提醒 AI 研究者:我们也许永远无法逃离表征的“洞穴”,但每个模型都在各自的洞穴里,看到了属于自己的、同样真实且丰富的阴影。