
BAMI:无需训练,解码 GUI 定位中的“视觉偏置”与推理重构
BAMI: Training-Free Bias Mitigation in GUI Grounding
本文提出了 BAMI,一种针对 GUI Grounding(界面元素定位)任务的无需训练(Training-free)的偏置缓解推理框架。该方法通过“由粗到细的聚焦”和“候选框修正”机制,显著提升了现有 MLLMs 在高分辨率和复杂界面(如 ScreenSpot-Pro)上的定位精度,将 TianXi-Action-7B 的准确率从 51.9% 提升至 57.8%。
TL;DR
在自动驾驶 GUI 代理(GUI Agents)领域,定位(Grounding)是所有后续动作的基石。然而,即使是最先进的多模态大模型(MLLMs),在面对高分辨率、元素密集的专业软件界面时,胜率往往不足 50%。清华大学与联想研究院的研究者推出的 BAMI (Bias-Aware Manipulation Inference) 框架,无需对模型进行任何重新训练,仅通过改变推理时的“观察策略”,就让现有模型的定位精度实现了跨越式提升。
痛点深挖:模型为什么“点不准”?
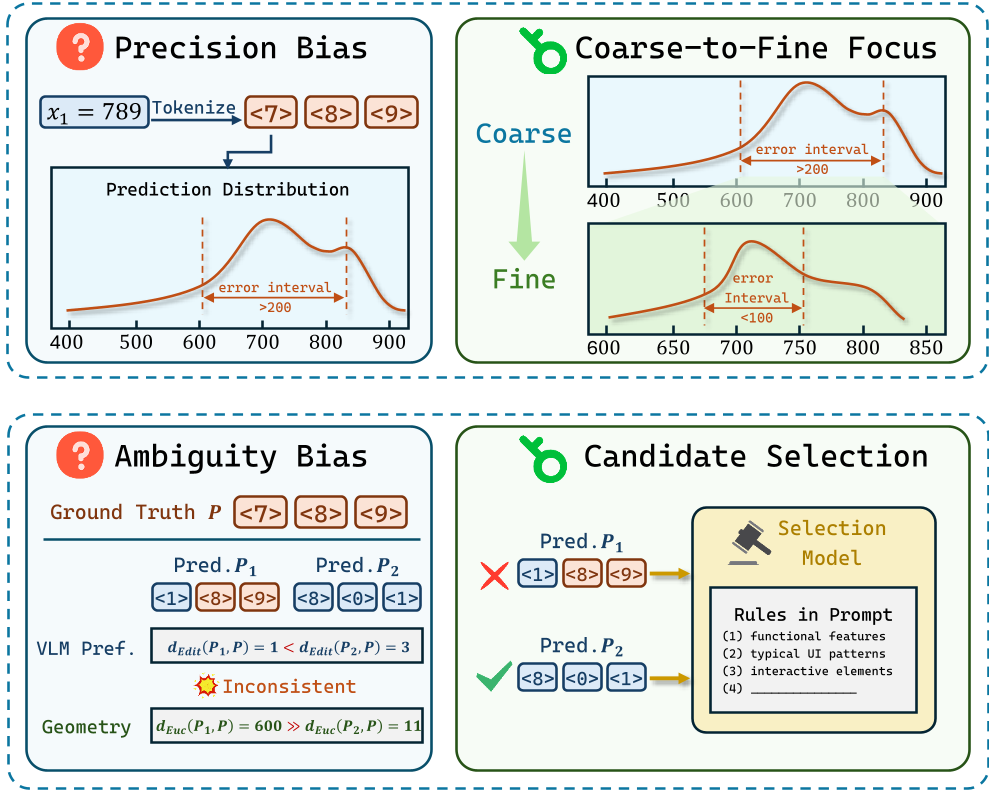
传统的 GUI 定位研究倾向于通过增加训练数据来“堆”精度,但本文作者通过一种创新的 MPD (Masked Prediction Distribution) 归因分析方法(见图 4),揭示了模型失败的深层原因并非完全是“知识匮乏”,而是来自两种内在偏置:
- 精度偏置 (Precision Bias):MLLM 将像素坐标视为 Token 序列(如将 789 拆为 <7><8><9>)。这种离散化导致模型在处理高分辨率大图时,像素级的微小误差会被放大。
- 歧义偏置 (Ambiguity Bias):模型训练的目标是最小化预测 Token 的编辑距离。例如,预测“789”为“189”在词法上仅差 1 位,但在物理距离上却差了 600 像素,导致模型在面对密集元素时极易被误导。
方法论详解:模拟人类的“由远及近”与“审慎选择”
为了克服上述偏置,BAMI 引入了两项关键的推理操纵(Manipulations):
1. 由粗到细的聚焦 (Coarse-to-Fine Focus)
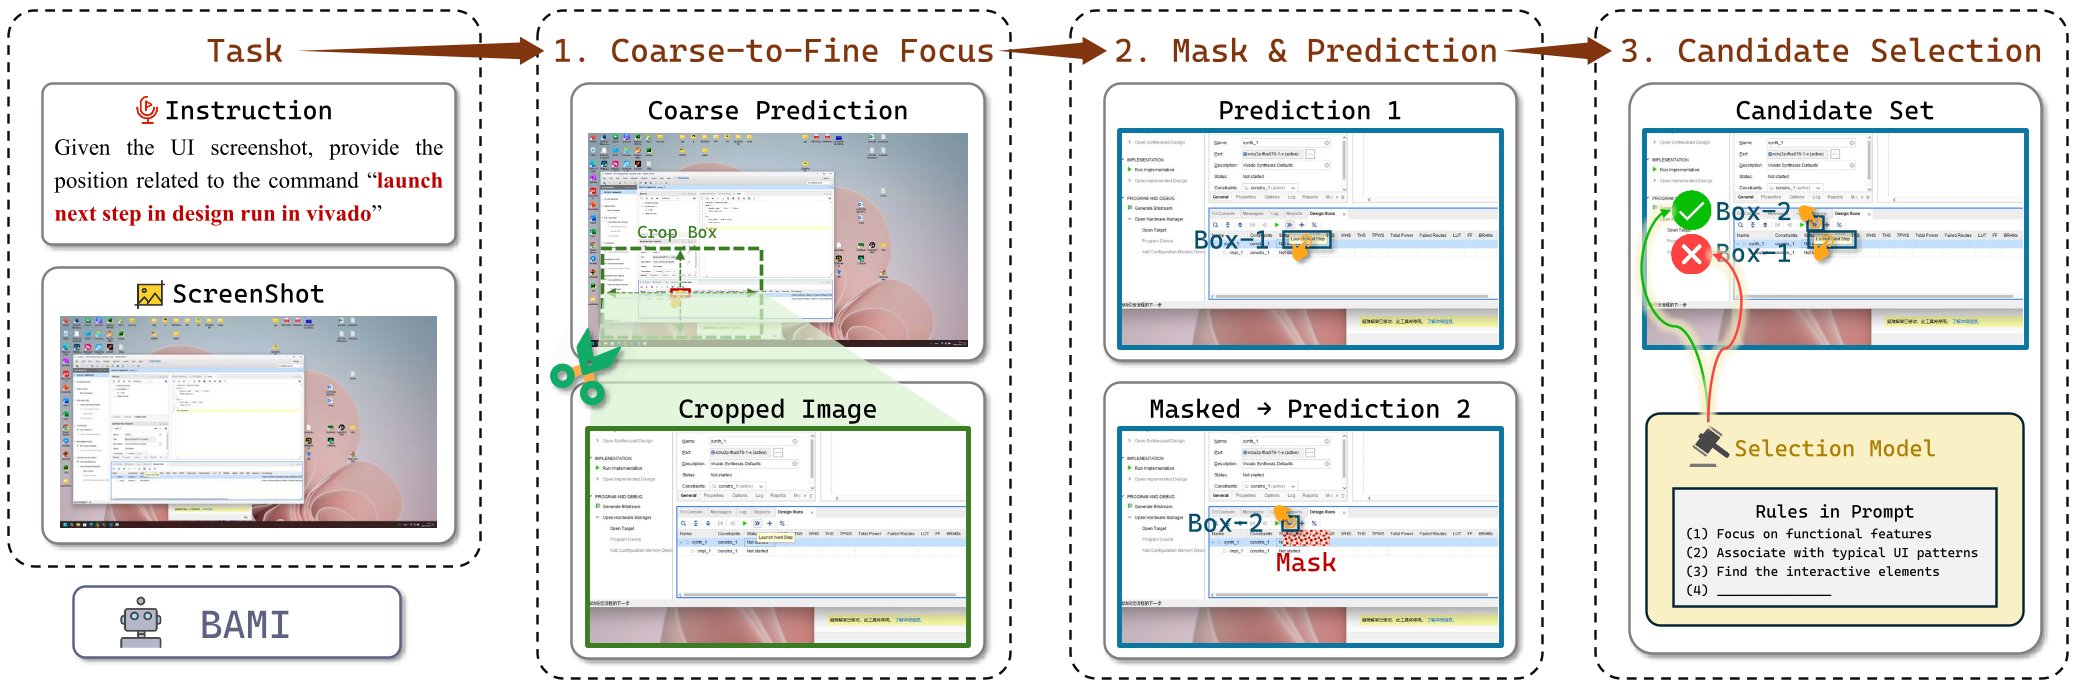
仿照人类操作精密仪器的逻辑:先在大图上确定大概范围,再通过“局部放大”(Cropping)进行精细定位。BAMI 设计了一个递归循环,每次将前一步预测的区域进行缩放裁剪。实验证明,这种方法能有效打破坐标离散化带来的精度天花板。
2. 候选框修正机制 (Candidate Selection)
由于 Token 空间与几何空间的错位,单次预测往往结果存疑。BAMI 采用 Masked Prediction(遮蔽预测):对模型已生成的预测区域进行像素遮蔽,强迫模型寻找“第二备选、第三备选”。随后,引入一个注入了 GUI 交互原则(如:图标优于文本、交互组件优于静态标签)的修正模型,从多个备选项中挑选出最符合逻辑的目标。
实验与结果:训练不足,推理来补
BAMI 在 ScreenSpot-Pro——目前公认最难的专业软件 GUI 测试集上展现了极强的统治力。
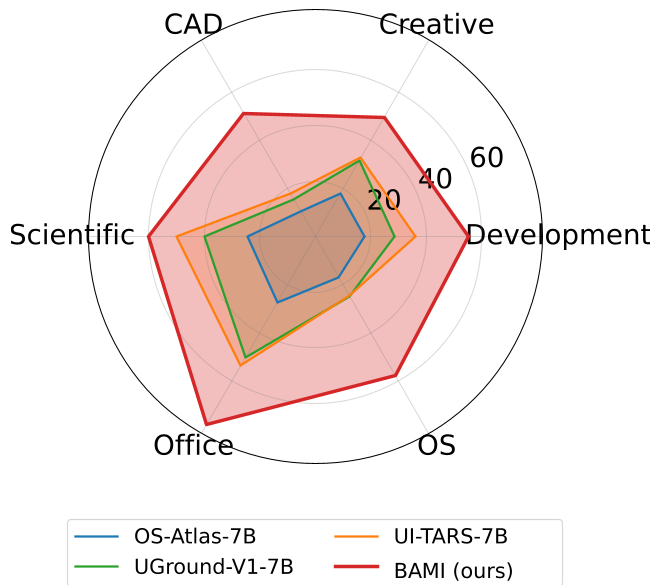
- 通用提升:在 OS-Atlas, UI-TARS, TianXi-Action 等主流基座上表现出 4%~6% 的一致性提升(见图 3)。
- 效率平衡:消融实验显示(图 6),2 次迭代、裁剪比例在 0.5 到 0.7 之间是性能与速度的平衡点。
- 本地化潜力:即便不调用 GPT-5,使用专门微调过的 Qwen3-VL-8B 本地模型作为修正器,其精度也能达到 56.2%,确保了数据隐私和推理成本的可控。
深度洞察与总结
BAMI 的成功向我们展示了一个重要的趋势:模型能力的增长不一定非要通过“暴力训练”实现。 通过对推理过程(Test-time)的精细化设计,我们可以弥补底层架构在 Inductive Bias 上的天然缺失。
局限性与未来:尽管 BAMI 显著提升了精度,但递归推理也带来了额外的计算开销。如何在保持高精度的同时,通过动态跳过某些递归步骤来优化推理时延,将是 GUI Agent 走向工业化部署的关键挑战。
对于开发者而言,BAMI 提供了一个非常有价值的启示:当你的视觉模型在特定任务上“点不准”时,也许不是它没学会,而是它需要一个“放大镜”和一套“修正逻辑”。