
GraphDPO:超越 Pairwise 对齐,LLM 的偏好潜能隐藏在图中
Beyond Pairs: Your Language Model is Secretly Optimizing a Preference Graph
本文提出了 Graph Direct Preference Optimization (GraphDPO),这是一种将 Direct Preference Optimization (DPO) 推广到图结构偏好上的对齐方法。该方法通过构建有向无环图 (DAG) 来建模多条采样回复(Rollouts)间的偏好关系,在推理和代码生成任务中显著优于传统的成对或序列对齐方法。
TL;DR
在 LLM 对齐领域,传统的 DPO 总是将偏好数据拆解为“你优我劣”的成对比较。然而,来自亚马逊(Amazon)的研究团队近日提出:你的语言模型秘密地在优化一个偏好图(Preference Graph)。 新提出的 GraphDPO 突破了 Pairwise 和 Listwise 的局限,通过建模 DAG 图结构,捕捉多条回复间的传递性和等价关系,在数学推理与代码生成任务上刷新了性能上限。
背景定位:偏好对齐的第三种范式
目前主流的对齐方法可以分为三类:
- Pairwise (如 DPO):简单但孤立,忽略了多样本间的全局联系。
- Listwise (如 PRO, LiPO):假设了严苛的全序关系,无法处理“平局”或部分可比的情况。
- Graphwise (本文 GraphDPO):通过有向无环图(DAG)建模偏好,既能处理传递性,又能兼容等价类。
核心动机:为什么要用“图”?
在实际生产中,为了对齐模型,我们常针对一个提示词(Prompt)生成 个回复。如果用 DPO 拆解,会产生 个独立对,这会带来两个严重问题:
- 传递性丢失:如果 且 ,独立处理时模型可能感知不到 到 的全局序。
- 逻辑冗余或冲突:离散的判读信号(如:答案是否正确)会产生大量完全等价的回复,强行排序会引入虚假梯度(Spurious Gradients)。
机制详解:GraphDPO 是如何运作的?
1. 偏好图表示与等价类掩码
GraphDPO 为每个 Prompt 构建一个 。为了处理“平局”,作者引入了等价类掩码(Equivalence-class masking)。只有当回复 确实优于 时才建立边。同一层级(如同样都是错的或都是对的)的回复之间不产生损耗。
2. 图结构化目标函数
受 Plackett–Luce 模型的启发,GraphDPO 定义了局部选择概率: 这里的 是被 支配的邻域。这种设计让每个节点仅与其“手下败将”竞争,从而在全局上强化了偏好的一致性。
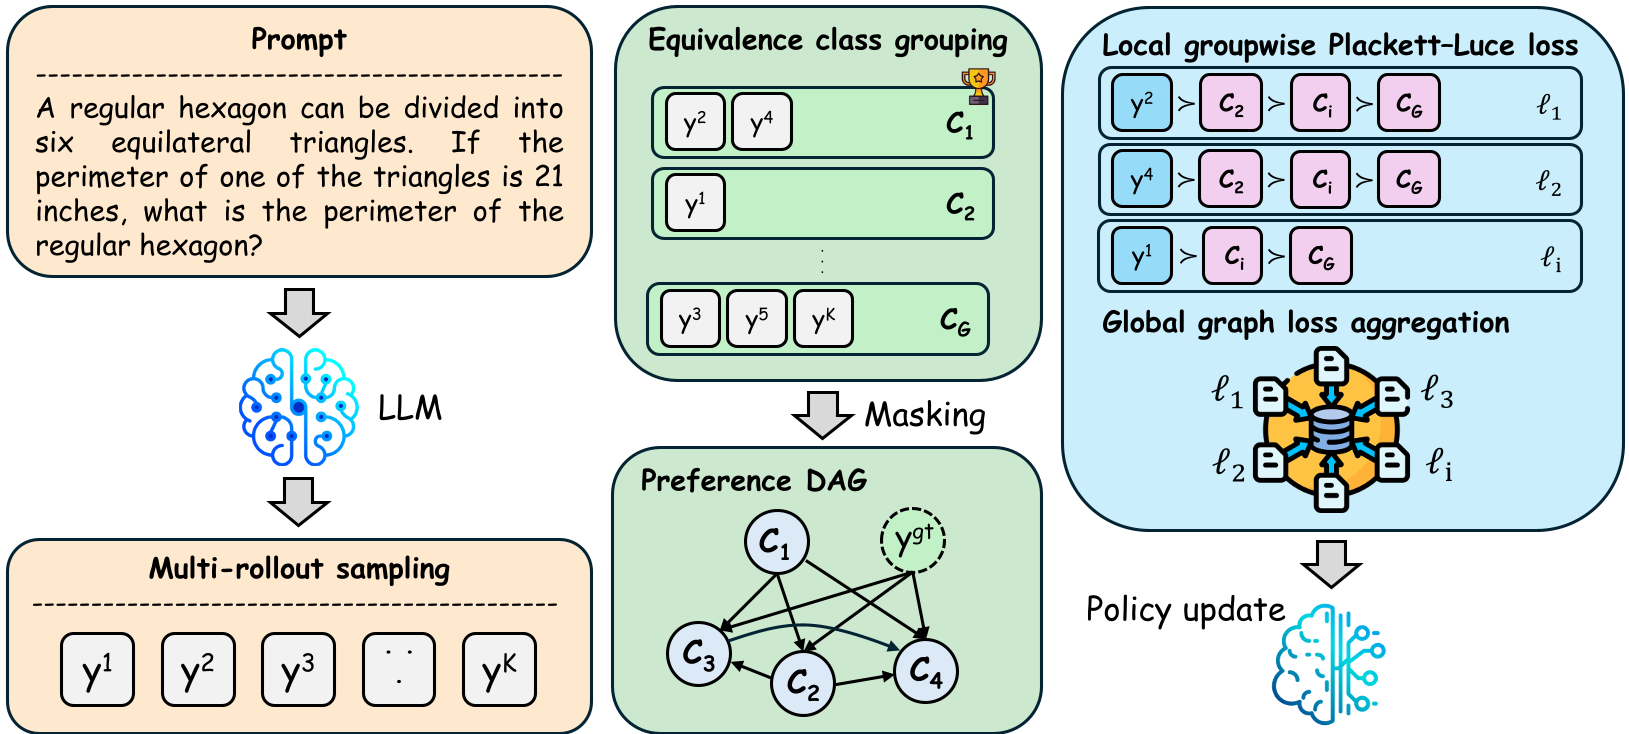 GraphDPO 的核心流程:采样、分层构建 DAG、节点邻域聚合更新。
3. 基准锚定 (Ground-Truth Anchoring)
在数学推理任务中,作者巧妙地加入了验证过的正确答案作为“超级节点”,并配以退火权重策略:早期重度依赖 GT 稳定方向,后期逐渐放权给模型自生成的回复,以保证多样性。
实验战绩:全线 SOTA
研究者在 GSM8K (数学)、MATH-500 (竞赛数学) 和 APPS (编程) 上进行了严谨消融:
| 任务 | LiPO (Listwise) | GraphDPO (Ours) | 提升幅度 |
|---|---|---|---|
| GSM8K | 89.23% | 92.75% | +3.52% |
| MATH-500 | 85.60% | 88.87% | +3.27% |
| APPS | 69.32% | 73.76% | +4.44% |
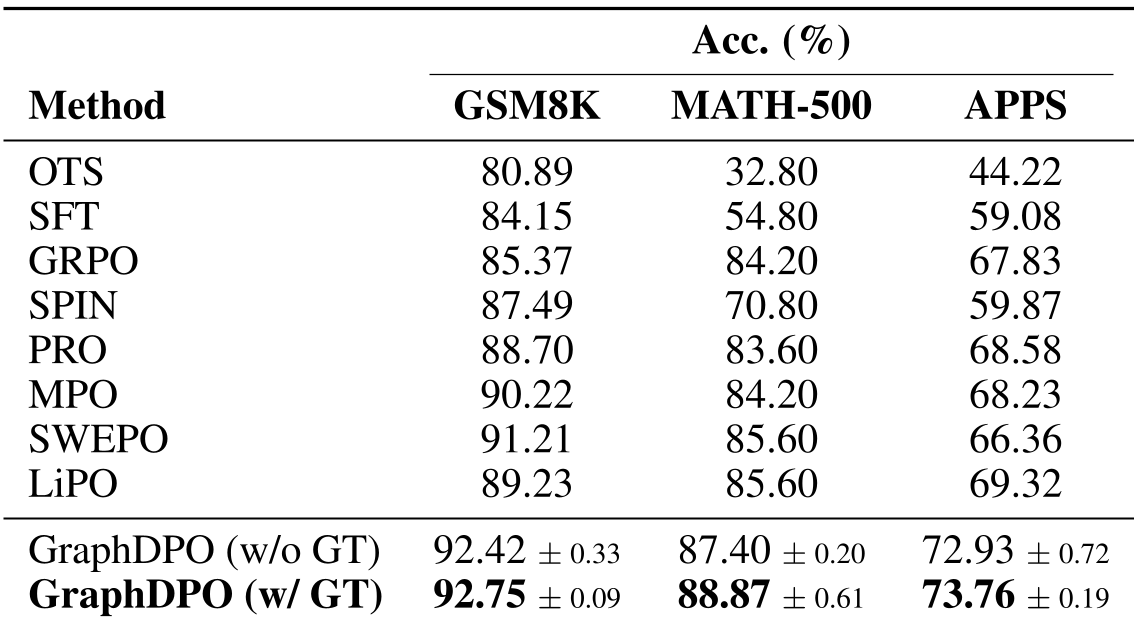 数据表明,任务越复杂(如 MATH 和 APPS),GraphDPO 的图结构优势越明显。
深度洞察
- 隐式权重平衡:通过数学推导,作者发现 GraphDPO 实际上为那些具有更多“继任者”的节点分配了更高的梯度权重。这意味着模型会更激进地修正那些明显的低级错误。
- 复杂度优势:尽管利用了全图结构,但在分层 DAG 下,其复杂度仅为 ,避开了 Pairwise 常见的 陷阱,极其适用于工业级的大规模 Rollouts。
总结与局限
GraphDPO 证明了偏好的本质是一种拓扑关系。尽管目前在推理任务中表现极其稳健,但对于主观性极强、难以形成明确层级偏好的对话任务,如何自动构建鲁棒的图结构仍是一个挑战。对于追求极限性能的 LLM 团队来说,放弃 Pairwise DPO,转向 GraphDPO 这种更符合逻辑直觉的方法,或许是性价比最高的下一步。