
DCI:通过直接语料库交互重构智能体搜索
Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction
本文提出了直接语料库交互(Direct Corpus Interaction, DCI)范式,一种专为智能体(Agentic Search)设计的新型检索接口。该方法弃用了传统的离散嵌入、向量索引或检索 API,转而让智能体直接调用命令行工具(如 grep, find, bash)在原始语料库上进行高阶逻辑搜索,在多个 IR 和 QA 基准测试中显著超越了 SOTA 向量检索方法。
TL;DR
在大型语言模型(LLM)进入“推理智能体(Agentic RAG)”时代的今天,我们对检索系统的理解依然停留在传统的相似度匹配(Top-k)阶段。本文提出了一种极具颠覆性的范式——直接语料库交互 (Direct Corpus Interaction, DCI)。它不再依赖向量数据库或嵌入模型,而是直接将 Bash 终端交给 Agent。实验证明,这种“返璞归真”的方法在处理复杂的多跳推理和精确搜索时,性能远超目前的 SOTA 向量检索系统。
检索接口的“分辨率”危机
目前的 RAG 系统普遍存在一个隐形的“天花板”:检索接口分辨率不足。
当我们把语料库压缩进向量索引时,本质上是将复杂的文本降维成了固定的概率分布。对于简单的单跳问题有效,但面对需要“顺藤摸瓜”的科研或工程任务,传统 Top-k 接口就像是一个分辨率极低的摄像头:
- 逻辑遗失:它无法处理“查找 A 出现且 B 没出现”的布尔组合。
- 早熟截断:如果关键证据由于语义分数不够没进 Top-100,下游再强的 LLM 也巧妇难为无米之炊。
- 缺乏上下文灵活性:智能体无法根据第一个匹配点,动态决定向上阅读 50 行还是向下阅读 100 行。
DCI:把 Bash 交给 Agent
DCI 范式的核心 Insight 是:与其花精力设计更好的检索模型,不如设计更高分辨率的检索接口。
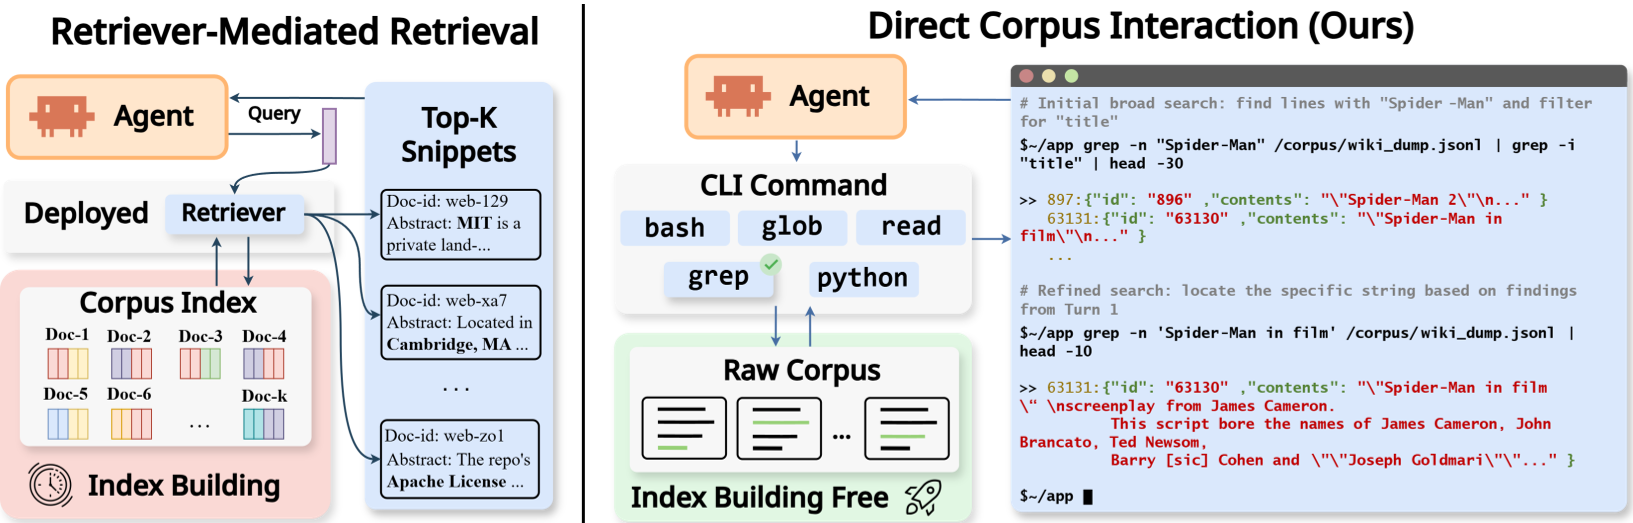 左图:传统的检索介导访问;右图:DCI 直接语料库交互。
在 DCI 架构下,智能体不再输入 Query,而是输入代码或 Shell 命令。它可以并行执行多个 rg(ripgrep)搜索,利用管道符 | 链式过滤结果,甚至编写一段 Python 脚本来遍历特定目录结构。
为了应对长程对话中命令输出堆积导致的上下文爆炸,作者设计了三种分级策略:
- 截断 (Truncation):对单次命令结果限流。
- 压缩 (Compaction):自动清理旧的转录,仅保留命令结构。
- 摘要 (Summarization):当上述手段失效,调用一个廉价的小模型来总结之前的搜索轨迹。
实验发现:为什么 DCI 这么强?
在针对“深度研究”设计的 BrowseComp-Plus 基准测试中,DCI 展现了惊人的能力增长。
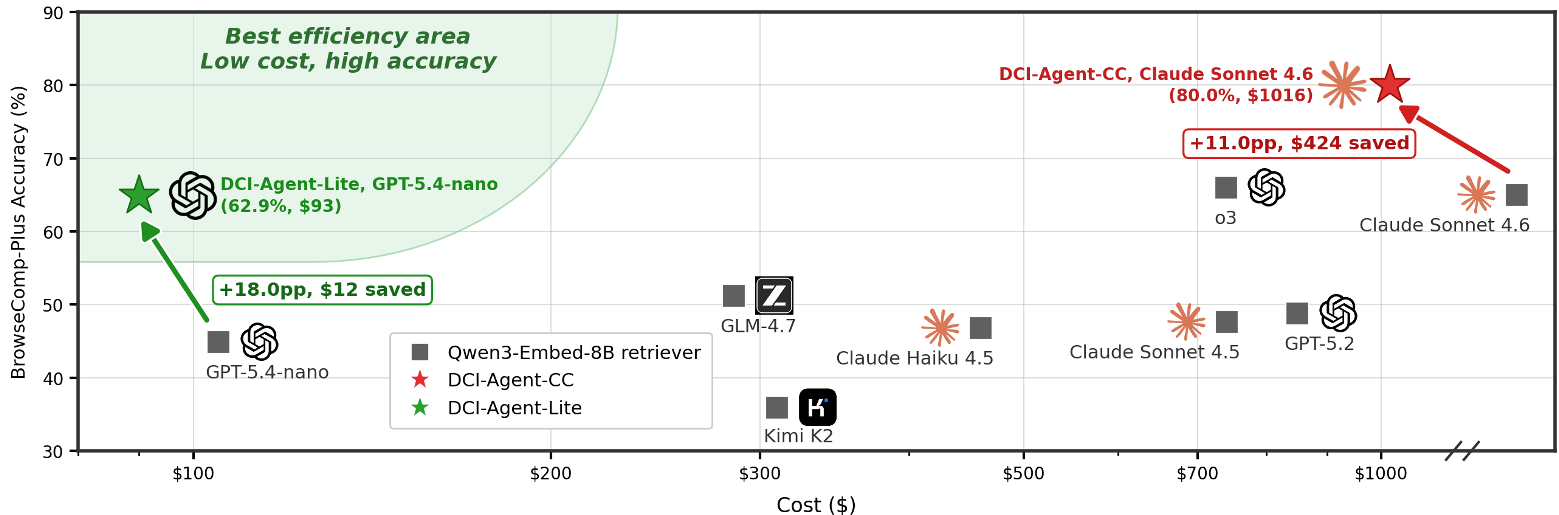 性能与成本的帕累托前沿:基于 Qwen3-Embedding 的检索系统(蓝线)VS 基于 DCI 的智能体(星号)。
关键结论分析:
- 高质量定位(Localization):DCI 并不总是能找回更多的“金牌文档”(Recall),但它能极度精准地定位到文档内部那几行真正起作用的代码或句子。相比传统方法,定位精度(Localization Score)翻了一倍(48.4 vs 21.7)。
- 逻辑链条的连续性:在涉及足球比赛细节、球员合同等需要多重约束验证的任务中,DCI 能够通过
grep | grep的方式排除干扰项,这种确定性是模糊相似度匹配无法提供的。
局限性与挑战
尽管 DCI 在中规模语料库(10k-100k 文档)上表现优异,但在超大规模语料库(百万级以上)面前,检索广度成为硬伤。
- 搜索深度 vs 广度:DCI 擅长深入挖掘(Search Depth),但在缺乏全局索引的情况下,寻找第一个“锚点”的开销会随着语料库规模呈指数级增长。
- 工具幻觉:智能体偶尔会陷入无效的 Shell 命令死循环。
总结:检索设计的未来
DCI 实验证明了:随着 LLM 推理能力的增强,检索系统的研究重点应从“算法设计”转向“接口设计”。传统的 Embedding 索引只是该设计空间中的一个特殊点,而在那些语料库持续演进、需要极高精确度的本地办公或科研场景中,赋予智能体直接操控环境的终端能力,才是更符合人机协作直觉的 SOTA 路径。