
PRISM:修正 SFT 偏移,多模态 RL 之前的关键“预对齐”
Beyond SFT-to-RL: Pre-alignment via Black-Box On-Policy Distillation for Multimodal RL
本文提出了 PRISM,一种针对多模态大模型(LMMs)的三阶段后训练框架。该方法在传统的 SFT 到 RLVR 流程中插入了一个基于黑盒在线策略蒸馏(On-Policy Distillation)的预训练对齐阶段,利用 Mixture-of-Experts (MoE) 判别器修正 SFT 引入的分布偏移,在 Qwen3-VL 基础上显著提升了推理性能。
TL;DR
在大型多模态模型(LMM)的训练中,传统的“指令微调(SFT)→ 强化学习(RL)”路径并非最优。本文提出的 PRISM 框架通过在 SFT 之后加入一个基于 MoE 判别器 的**黑盒在线策略蒸馏(On-Policy Distillation)**阶段,成功修复了 SFT 带来的分布偏移(Distributional Drift)。在 Qwen3-VL 上的实验显示,这一步骤能让下游 RL 的收益放大,平均得分提升高达 6.0 分。
1. 痛点:SFT 其实也是一把双刃剑
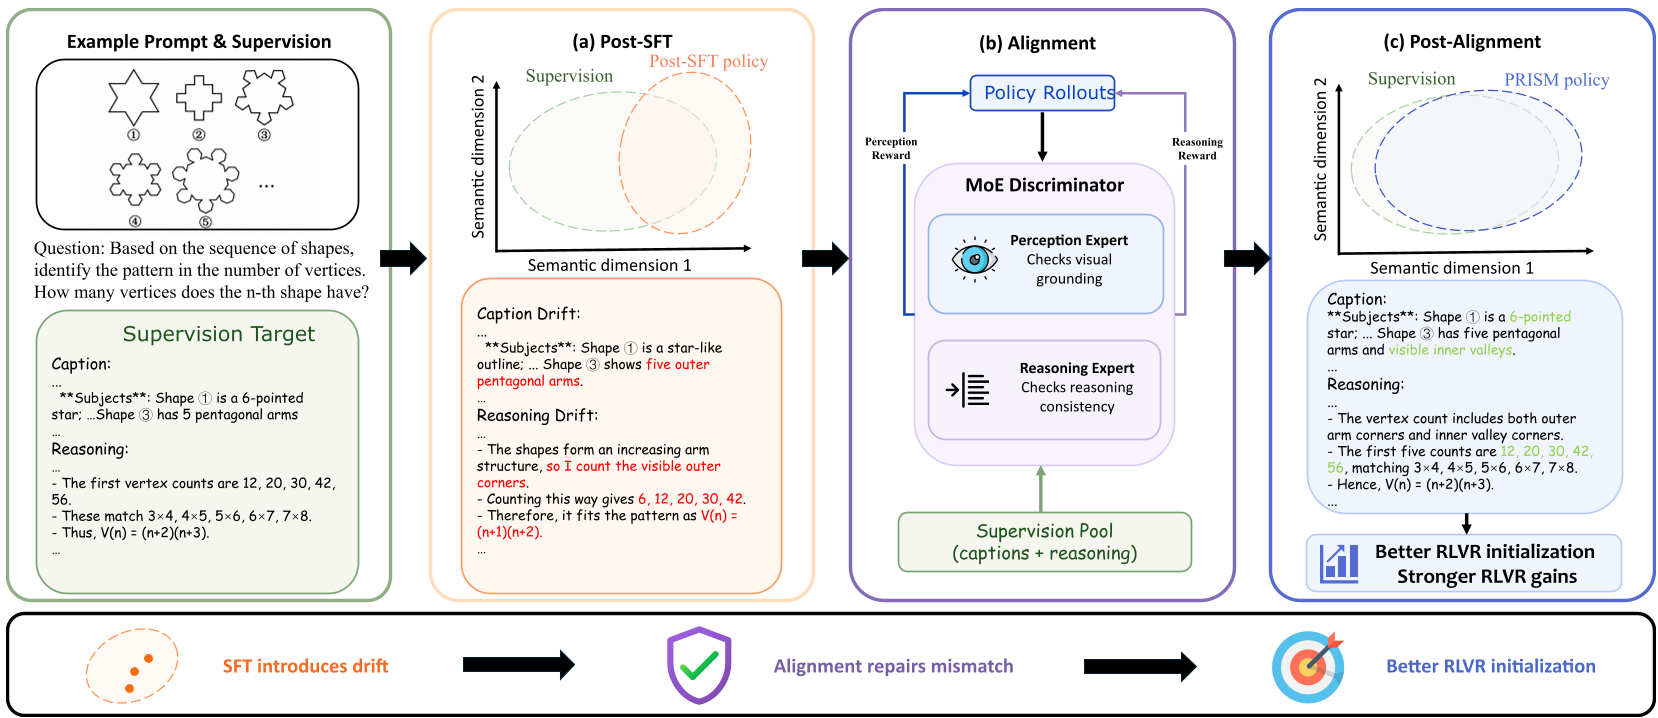
在模型后训练(Post-training)领域,学术界一直有一个直觉:SFT 建立基础能力,RL 进一步打磨性能。然而,最新的研究(如 Kang et al., 2025)指出,SFT 可能会让模型陷入一种“妥协状态”:
- 分布偏移:模型通过 token 级别的模仿学习外部数据,往往只学会了表面模式,却偏离了预训练阶段积累的高质量原生分布。
- 错误放大:在多模态推理中,视觉感知的微小偏差会扭曲整个推理链条的逻辑前提。
- 异质性退化:感知能力的下降与逻辑推理的崩溃是不同质的,单一的奖励信号(Verifiable Reward)很难同时修复这两者。
2. Methodology: PRISM 的三阶段炼金术
PRISM 的核心是在 SFT 和 RL 之间插入了一个显式的**预对齐(Pre-alignment)**阶段。
2.1 架构解析:MoE 判别器
为了应对感知和推理的异质性偏移,作者设计了一个 Mixture-of-Experts (MoE) 判别器。它不只是输出一个简单的分值,而是由两个专家组成:
- 感知专家 (Perception Expert ):专门评估视觉描述部分,确保模型“眼见为实”。
- 推理专家 (Reasoning Expert ):专门评估 CoT(思维链)的逻辑严密性。
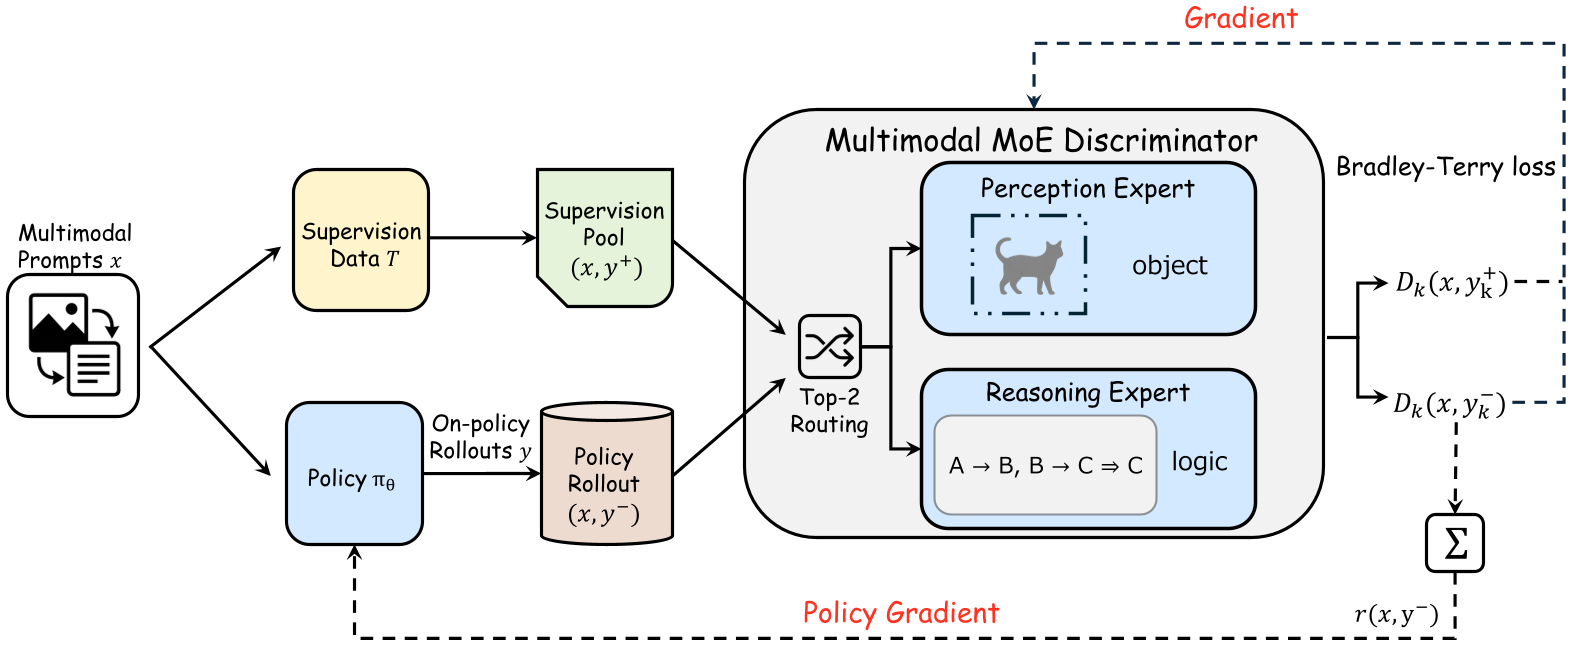
其最终奖励信号定义为两者的加权组合: 这种设计允许模型接收到解耦的反馈信号,避免了单一奖励导致的梯度噪声。
2.2 黑盒在线策略蒸馏 (OPD)
传统的蒸馏需要访问 Teacher 模型的 Logits,这在当下 API 闭源时代非常困难。PRISM 采用对抗游戏(Adversarial Game)的形式:
- 策略网络 (Policy) 负责生成回应。
- 判别器 (Discriminator) 负责区分模型生成与高质量监督数据。 这种 On-Policy(在线)的特性让模型在自己的采样空间内进行对齐,能有效缓解推理时的 Exposure Bias。
3. 实验战绩与深度洞察
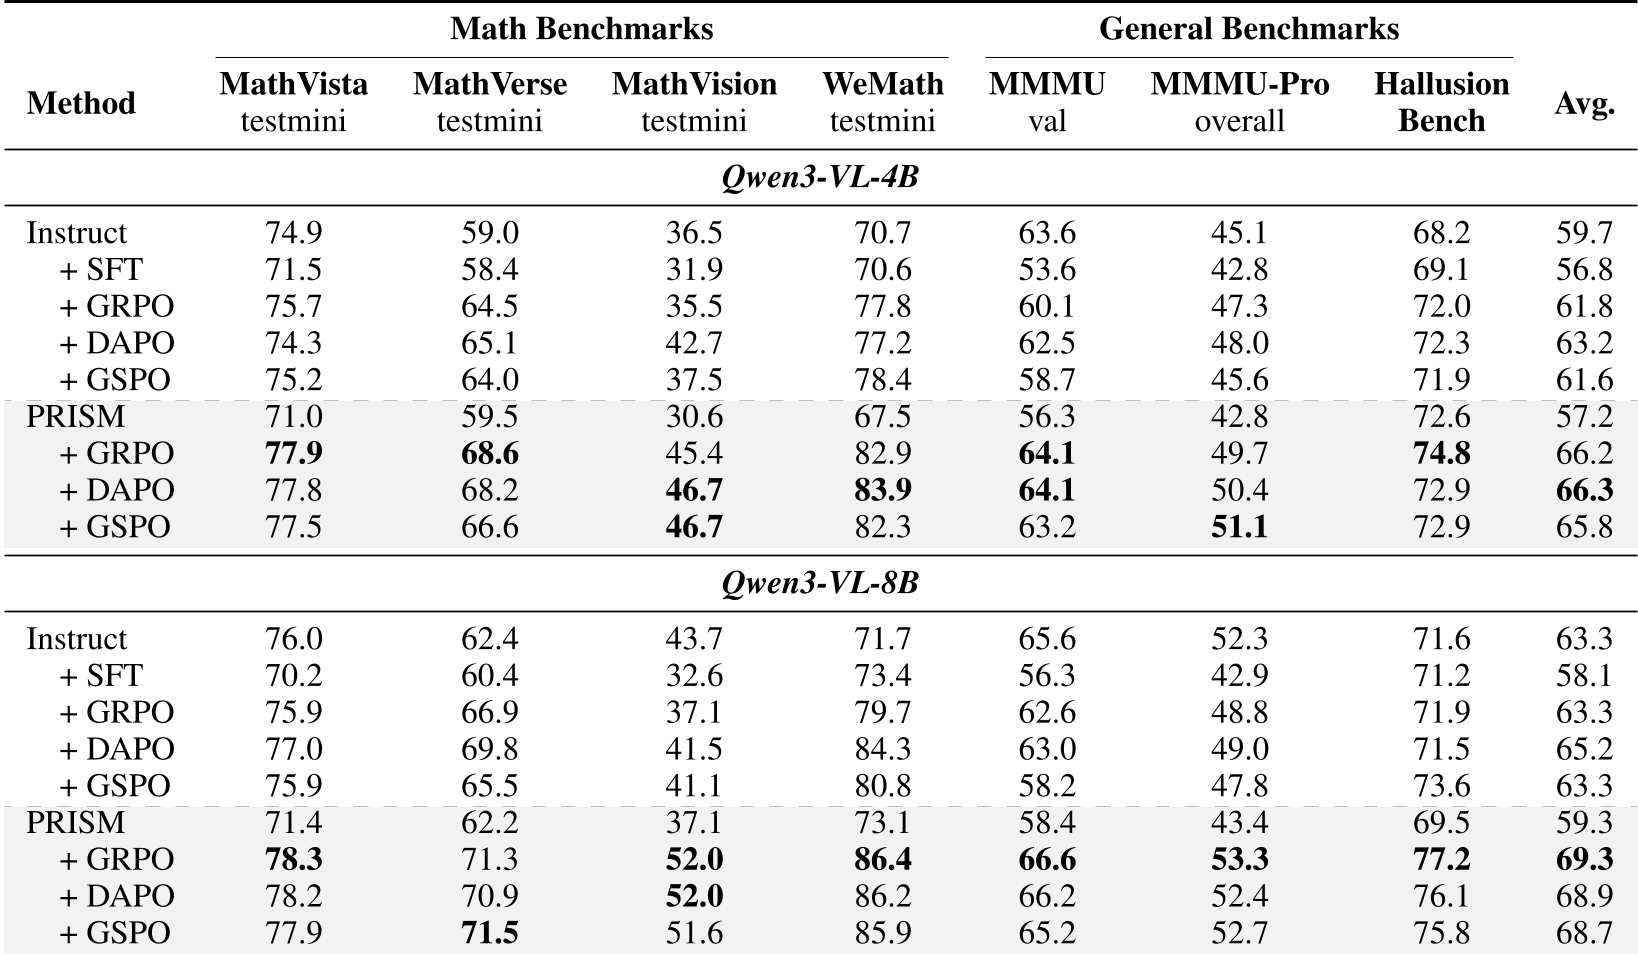
作者在 Qwen3-VL 的不同规模(4B, 8B)上进行了广泛测试,使用了 GRPO, DAPO 和 GSPO 等多种 RL 算法。
3.1 关键结果:RL 效果的翻倍
实验证明,PRISM+GRPO 在所有指标上均显著优于传统的 SFT→GRPO。特别是在 MathVision (+9.9%) 这种强依赖感知与逻辑结合的任务中,PRISM 展现了极强的统治力。
3.2 为什么 MoE 判别器有效?
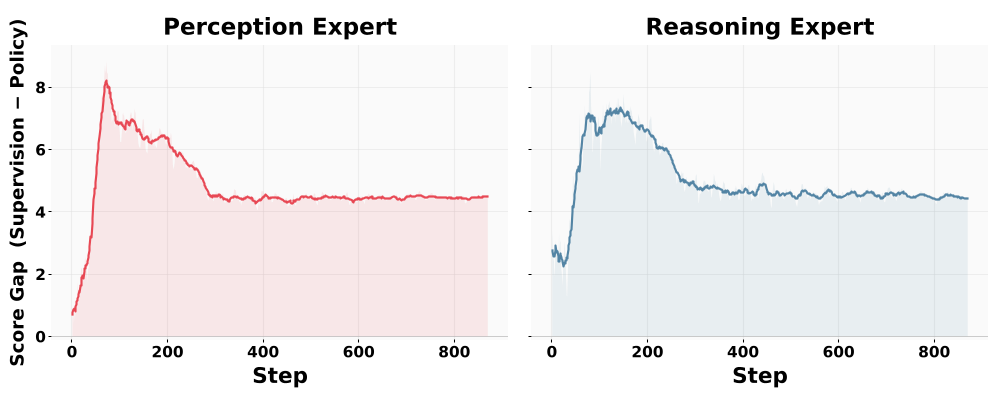
通过训练动态观察发现,感知专家和推理专家的收敛曲线是异步的(见下图)。
- 感知专家收敛极快,能迅速确立视觉接地的边界;
- 推理专家则波动较大,需要更细腻的对齐。 如果使用传统的 Dense 判别器,这两类信号会互相抵消(Collapse),导致训练不稳定。
4. 结论与局限性
PRISM 证明了分布对齐是 LMM 进行强化学习之前不可或缺的“热身”。它不仅让模型更聪明(得分更高),还让模型更高效(Token 消耗更少)。
局限性:
- 计算成本:由于需要同时训练 Generator 和 MoE Discriminator,内存和显存压力较大。
- 格式依赖:目前强依赖于结构化的输出格式(Caption-Think-Answer),对于非结构化任务的泛化尚待研究。
总而言之,PRISM 这种“空间换能力”的思想,为未来的 LMM 训练提供了一个严谨且可高度复现的技术范式。