
BLADE:打破静态上限,基于贝叶斯动态估计的 LLM 列表推荐对齐
Beyond Static Best-of-N: Bayesian List-wise Alignment for LLM-based Recommendation
本文提出了 BLADE,一种用于大语言模型推荐系统(LLM4Rec)的列表级对齐框架。该方法引入了贝叶斯动态估计机制,通过实时融合历史先验与模型当前的采样证据,将推理侧的 Best-of-N (BoN) 搜索能力蒸馏至模型权重中,在不增加推理成本的前提下显著提升了 NDCG 和 Recall。
TL;DR
在将大语言模型(LLM)应用于推荐系统(LLM4Rec)时,模型通常难以直接优化列表级指标(如 NDCG)。传统的 Best-of-N (BoN) 对齐虽能提升性能,但受限于静态参考分布,容易遭遇“监督失效”和“梯度衰减”。本文提出的 BLADE 框架通过贝叶斯动态估计,让对齐目标随模型能力同步进化,在不增加推理延迟的情况下,大幅刷新了 LLM 推荐的 SOTA 战绩。
痛点深挖:静态对齐的“天花板”效应
当前的生成式推荐研究(Generative Recommendation)正从 Token 级别的交叉熵损失向列表级(List-wise)偏好对齐迈进。Best-of-N 作为一种在推理时采样 个列表并取最优解的策略,效果虽好但推理开销极大。
为了将 BoN 的搜索能力“蒸馏”到模型参数中,前人提出了 BoN 对齐。但作者指出,这种基于静态参考集的方法存在致命伤:
- 无差别监督 (Indiscriminate Supervision):当模型通过训练进化到超出参考集水平时,所有优秀的采样在静态 CDF 估计下都会变为 1。模型无法分辨“好”与“更好”,导致排序指引丢失。
- 梯度衰减 (Gradient Decay):随着模型变强,落入高奖励区域的样本占绝大多数,监督信号逐渐趋于零,优化陷入停滞。
核心机制:BLADE 的贝叶斯进化论
BLADE (Bayesian List-wise Alignment via Dynamic Estimation) 的核心思想是:与其锚定一个死板的参照物,不如跟随自己的成长动态调整目标。
1. 贝叶斯后验估计
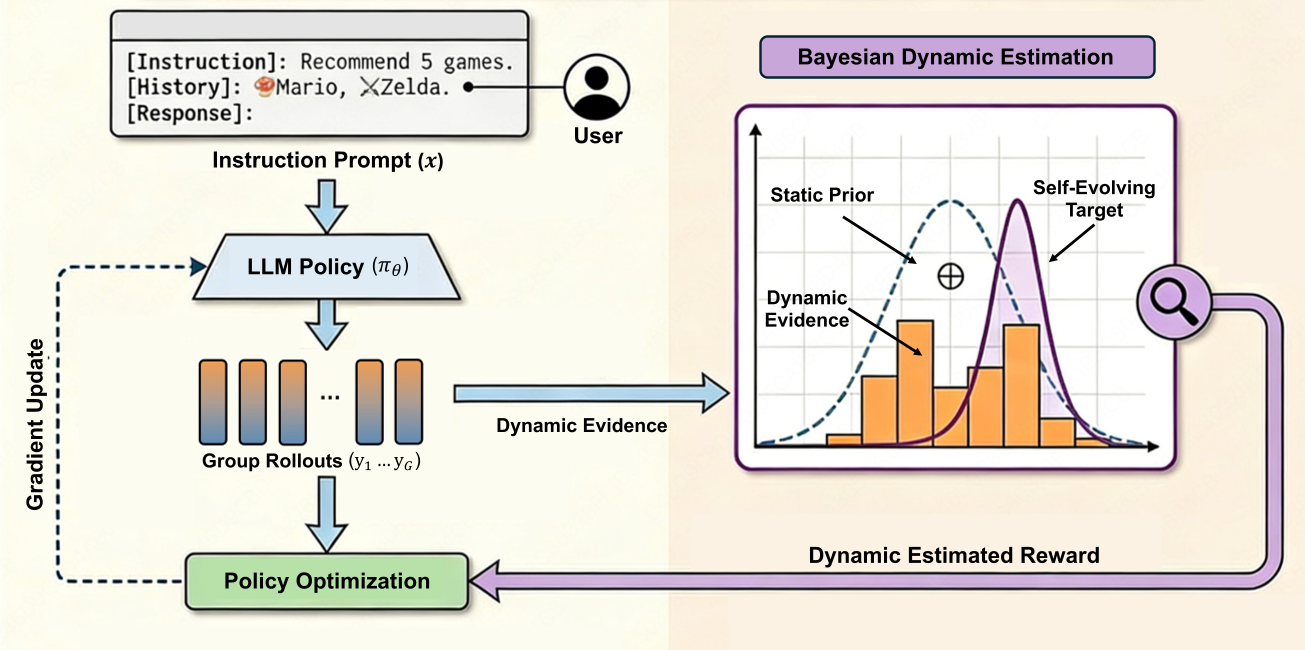
BLADE 将奖励分位数的估计建模为贝叶斯推理。
- 先验 (Prior):来自静态参考模型(Static Reference)的历史统计。
- 证据 (Evidence):来自当前训练批次(Batch)的实时采样。
通过 Beta 分布的共轭性,BLADE 能够高效地计算出动态分位数估计器: 这里的 是动态系数,用于平衡“稳定性”与“自进化性”。
2. 共享采样机制 (Shared Sampling)
为了保证效率,BLADE 巧妙地复用了 GRPO(Group Relative Policy Optimization)的采样批次。同一批 Rollouts 既充当“动态证据”更新后验,又用于计算策略梯度,实现了零额外训练开销。
实验与结果:全面超越静态上限
作者在 Amazon CDs、Steam 和 Goodreads 三个数据集上进行了验证:
- 突破上限:在 Amazon CDs 数据集上,BLADE 的 NDCG@5 相比传统静态对齐提升了 23.1%。
- 帕累托优化:在引入公平性(MGU)和多样性(ILD)目标后,BLADE 展现了极佳的灵活性,能够找到准确率与多样性之间的平衡点。
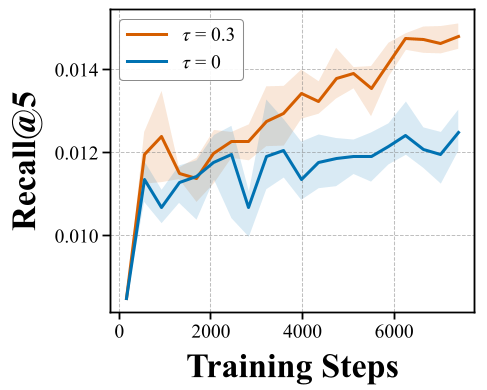 左侧 Recall 曲线显示,静态基线(蓝色)迅速平稳,而 BLADE(橙色)能持续进化。
深度洞察
BLADE 的成功在于它解决了强化学习中常见的**非平稳目标(Non-stationary Target)**问题。通过引入贝叶斯平滑,它在模型探索初期保证了稳定性,在探索后期提供了持续的区分度。这对于所有涉及“列表生成”和“复杂非微分指标”的任务(如搜索重排、广告创意生成)都有极强的借鉴意义。
局限性:尽管 BLADE 表现优异,但其性能高度依赖于复合奖励函数中超参数 的调节。未来如何实现自动化的多目标权重平衡将是一个重要的研究方向。
总结
BLADE 标志着 LLM4Rec 从“模仿参考”转向“自我超越”。它通过贝叶斯框架赋予了模型在动态环境中自我评估的能力,是实现高效、高性能列表级对齐的关键一步。