
S-trace: 告别“大锅饭”,让 LLM 推理学会精细化信用分配
Beyond Uniform Credit Assignment: Selective Eligibility Traces for RLVR
本文提出了 S-trace,一种针对强化学习可验证奖励(RLVR)任务的 Critic-free 资格痕迹(Eligibility Traces)方法。通过引入基于熵的稀疏掩码,该方法在保持高样本效率的同时,显著提升了大型语言模型(LLM)在数学推理任务中的泛化能力和 Token 效率。
TL;DR
DeepSeek-R1 的成功让 GRPO 算法走入大众视野,但其核心痛点在于“统一信用分配”——所有 Token 无论重要与否都平摊同样的奖励信号。本文介绍的 S-trace 引入了经典的 资格痕迹 (Eligibility Traces) 理论,并配合 稀疏掩码 (Selective Masking),仅对关键推理步骤(高熵 Token)进行强化。实验表明,该方法在提升准确率的同时,大幅降低了推理冗余,实现了模型性能与效率的双重飞跃。
痛点深挖:为何“大锅饭”式的奖励分配不可行?
在复杂的数学推理任务中,回答可能长达数千个 Token。GRPO 算法通过组内相对奖励来避免训练 Critic 网络,但它假设轨迹中每一个 Token 对最终结果的贡献是均等的。
- 噪声干扰:常规的连接词或简单的计算步骤与核心逻辑跳转被同等对待,强化了大量无用信号。
- 效率瓶颈:由于缺乏时间维度上的精细建模,模型需要海量样本才能从均匀的反馈中提取出有效的因果关系。
核心方法论:从 P-trace 到 S-trace
作者首先推导了 P-trace。其背后的物理直觉是 部分信任区域保留 (Partial Trust Region Preservation):即使当前 Token 的重要性权重超出了裁剪阈值(Clipped),只要它之后存在具有因果联系的项目尚未超出阈值,就可以通过历史痕迹找回这些丢失的正向信号。
为了克服密集更新带来的高方差,S-trace (Selective Eligibility Traces) 登场:
- 重要性采样重构:引入合格重要性权重 (Eligible Importance Weight),通过 Stop-gradient 巧妙诱导资格痕迹结构。
- 高熵筛选 (80/20 准则):研究发现推理路径中只有约 20% 的 Token(高熵分支点)主导了逻辑走向。S-trace 仅对这些 Token 应用信用反馈。
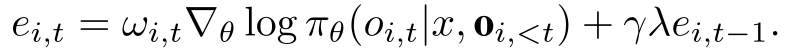
实验与结果:性能与 Token 效率的双赢
在 Qwen3 系列模型上的实验证明,S-trace 在多个数学竞赛数据集(MATH500, AIME, AMC)上全面超越了 GRPO 及其变体 GRPO(λ)。
- 准确率提升:在 Qwen3-4B 上,平均 Pass@16 达到 52.17%(GRPO 为 49.01%)。
- Token 效率:这是一个令人惊喜的发现。S-trace 训练出的模型倾向于生成更短、更精炼的推理轨迹,显著降低了推理成本。
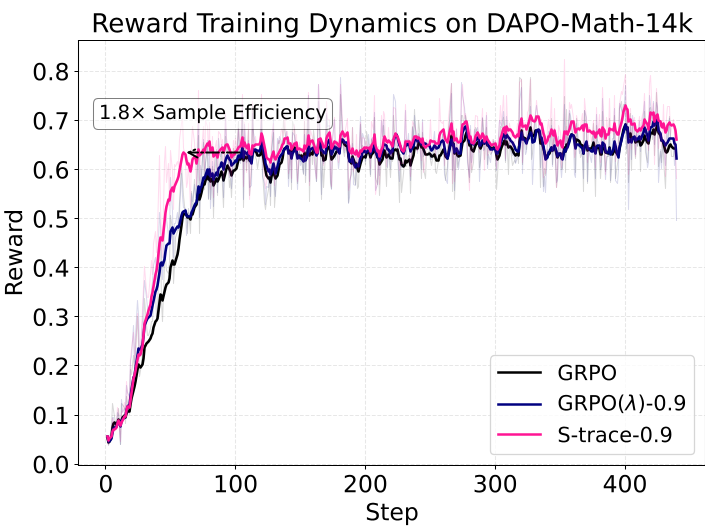 (上图展示了 Qwen3-8B 训练动态:S-trace 在保持高奖励的同时,响应长度显著低于基线)
深度洞察:为什么选择性分配更稳健?
作者在消融实验中对比了“基于熵的掩码”与“随机掩码”。结果显示,随机筛选会导致性能剧烈下降。这说明 信息熵 (Entropy) 是定位推理逻辑瓶颈的绝佳指标。S-trace 实际上是在生物学意义上模拟了“突触标记与捕获”机制,精准地将奖励“固化”在真正产生智能的 Token 上。
总结与展望
S-trace 成功地将经典的强化学习理论与现代大规模语言模型微调相结合。它告诉我们,与其给 LLM 更多的计算量,不如给它更“聪明”的反馈机制。
- 局限性:稀疏掩码的比例(如 ρ=0.2)目前仍属超参数,动态调整机制值得进一步探索。
- 未来前景:这种基于近因效应的信用分配思想,极有可能成为下一代长文本模型和大语言模型智能体(Agents)的标准配置。