
BifrostUMI:摆脱机器人束缚,让 VR 设备成为人形机器人的高效导师
BifrostUMI: Bridging Robot-Free Demonstrations and Humanoid Whole-Body Manipulation
本文提出了 BifrostUMI,一个针对人形机器人全方位操纵的便携式、低成本且“无机器人”(Robot-free)的异步数据采集框架。该框架利用 PICO 4 VR 设备捕捉人体 5 个关键点轨迹,并结合受 UMI 启发的腕部视觉采集器,通过分层扩散策略(Diffusion Policy)实现了从人类演示到人形机器人的平滑动作迁移。
TL;DR
人形机器人的数据采集一直是个“重资产”难题。北京人工智能研究院(BAAI)的团队最近推出的 BifrostUMI 开启了新思路:无需运行真实的机器人,只需一套 PICO 4 VR 设备和特制的腕部相机采集器,人类就能在家里为人形机器人生产高质量的“教学素材”。通过一套巧妙的关键点重定向算法,这些数据能无缝转化为 Unitree G1 等机器人的全方位协作动作。
痛点深挖:人形机器人数据的“采集围城”
目前训练人形机器人的主流方式是遥操作(Teleoperation)。这种方式就像“提线木偶”:人类穿着外骨骼或操作复杂的控制台,实时驱动机器人。
- 成本极高:每采集一份数据都得占有一台昂贵的机器人。
- 效率极低:机器人的响应延迟、安全限制让演示动作显得僵硬且耗时。
- 难以扩展:你没法让一百个人同时在家里为机器人采集数据。
BifrostUMI 的核心动机是实现 Robot-free(无机器人)采集。人类可以像平常一样自然地移动,随后再通过算法将其“平移”到机器人的身体上。
核心机制:三层分层控制架构
BifrostUMI 之所以能解决“动作走样”的问题,关键在于它没有尝试像素级地模仿每一个关节,而是采用了分层治理:
1. 任务空间的高层策略 (High-level Diffusion)
作者并没有预测复杂的机器人电机指令,而是选择了 5 个核心关键点:骨盆(Pelvis)、双足(Feet)、双手(TCP)。
- 使用 Diffusion Policy 模型,根据腕部相机的 DINOv2 视觉特征,预测这 5 个点在未来的“稀疏轨迹”。
- 这种做法的物理直觉是:只要这几个关键部位的位置对了,任务的核心逻辑也就抓住了。
2. 空间关键点重定向 (Spatial Keypoint Retargeting, SKR)
这是本文的“翻译官”。人类比机器人高、胳膊比机器人长,如果直接复制坐标,机器人可能抓不到桌上的东西。
- 保留度量信息:SKR 不同于传统的全局缩放,它仅仅在垂直方向(Z轴)缩放骨盆到足部的距离,以对齐身高差异,而保持双手与物体之间的绝对物理尺寸。这保证了人类演示时的“抓取距离”在机器人身上依然精准。
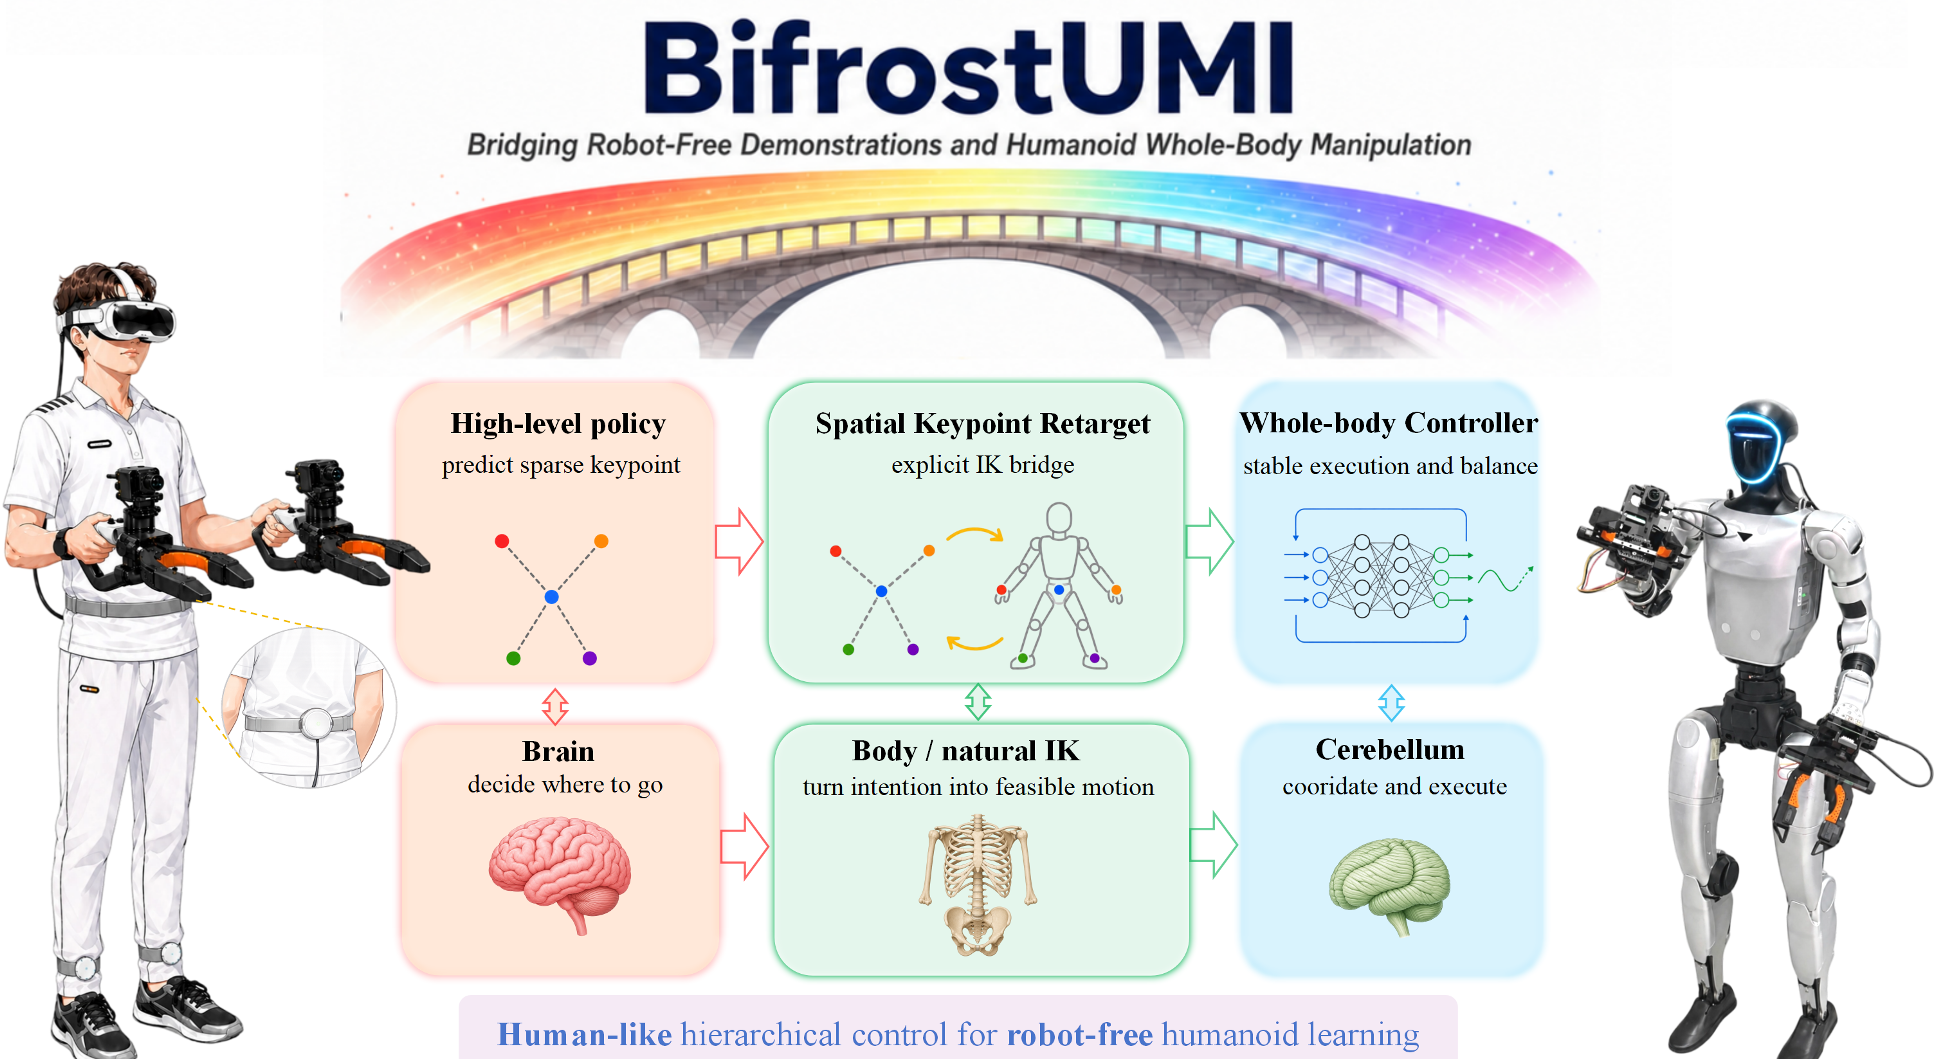 图 1:BifrostUMI 整体架构,展示了从人类演示到层次化控制的转化过程
3. 全方位控制器 (WBC)
最后,利用 MuJoCo 求解器(mink)将 5 个关键点坐标转化为机器人全身上下 29 个关节的实时角度指令。
实验战绩:从“桌面取放”到“钻桌底”
为了证明该框架的威力,作者在 Unitree G1 机器人上测试了两个极具代表性的场景:
- 杂乱桌面取放:机器人在周围布满干扰物的环境下,准确识别面包、抓取并放置到盘子里。这验证了视觉策略的鲁棒性。
- 桌下垃圾投放:这是一个对“全身协作”要求极高的任务。机器人需要后退、下蹲、侧身弯腰才能把纸团丢进桌底的垃圾桶。实验证明,仅靠 5 个关键点,就能驱动机器人完成如此复杂的姿态调整。
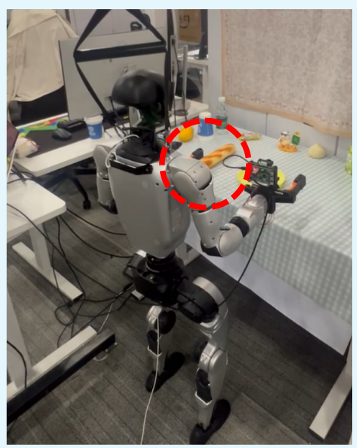 图 2:机器人执行桌下垃圾投放的过程,展示了卓越的下蹲与全身平衡能力
深度洞察:为什么选择关键点而非直接映射?
传统的“端到端”模仿学习往往会将感知与控制耦合在一起。BifrostUMI 的成功在于它引入了显式的逆运动学(IK)接口。
- 解耦优势:高层策略只需要管“任务怎么做”(Task-space),低层控制器只负责“走得稳”(Joint-space)。
- 迁移能力:如果未来换了一台机器人硬件,只要它的形态类似,采集的数据依然有效,只需重新训练低层 WBC 即可。
局限性与展望
尽管 BifrostUMI 表现惊艳,但它目前在处理**极精细的指尖操作(Dexterous Manipulation)**上仍受限于 VR 控制器的精度。未来,如果能引入更先进的触觉手套数据采集,或者将该框架应用到更大规模的长程任务(Long-horizon tasks)中,人形机器人的进化速度将真正迎来爆发。
总结 (Takeaway):BifrostUMI 告诉我们,人形机器人学习的未来不在于把设备做得多重,而在于如何更高效、更轻量地萃取人类的运动智慧。