
CAPO:突破协同多智能体链的信用分配瓶颈
CAPO: Counterfactual Credit Assignment in Sequential Cooperative Teams
本文提出了 CAPO (Counterfactual Advantage Policy Optimization),这是一种针对顺序执行协同多智能体系统的无 Critic 策略梯度算法。通过引入 Sequential Aristocrat Utility (SeqAU),CAPO 实现了在仅有团队奖励的情况下,精确且低方差地计算每个智能体的个体贡献归因。
TL;DR
在多智能体流水线(如 Multi-LLM Agent)中,如何根据最终的团队成败来奖励每一个中间环节?本文提出的 CAPO 算法通过“奖励分解”与“虚构采样”,提供了一种无 Critic 的精准信用分配方案。它不仅解决了顺序更新带来的非平稳性难题,还将估算方差从指数级降至线性甚至常数级。
1. 核心挑战:顺序执行中的“邀功”难题
在协同多智能体系统中,代理通常按 1, 2, ..., K 的顺序动作。但在训练时,我们面临两大痛点:
- 信用归因不明:团队合力拿到了一个奖励 R,到底是因为 Agent 1 的策略好,还是 Agent K 的补救得当?
- 分布偏移 (Non-stationarity):当你更新了上游 Agent 1 的策略,下游 Agent 的后续动作分布会随之改变。前人的方法(如 HA-GRPO)使用重要性采样来修正这种偏移,但在长链中,权重的乘积会导致方差爆炸。
2. SeqAU:为顺序链量身定制的“贵族效用”
作者提出了 Sequential Aristocrat Utility (SeqAU),这是对经典 Aristocrat Utility 的扩展。其核心直觉是:为每个智能体分配一个学习信号,使该信号通过减去一个仅与“上游前缀”相关的 Baseline 来最大化其行为的可学习性(Learnability)。
3. CAPO 算法详解:三大制胜招式
CAPO (Counterfactual Advantage Policy Optimization) 通过以下机制将理论转化为可落地的算法:
3.1 奖励分解(Additive Decomposition)
与其学习一个复杂的 Q 值函数,CAPO 假设期望团队奖励可以分解为各个智能体动作的贡献之和: 通过简单的岭回归 (Ridge Regression) 即可在闭式下求解 ,无需梯度下降,计算成本极低。
3.2 上游抵消(Upstream Cancellation)
作者发现,在计算第 个智能体的反事实优势时,其上游()的所有贡献在做差时会完全抵消。这意味着只需关注当前智能体的直接影响(自身 的变化)和间接影响(对下游 分布的影响)。
3.3 虚构采样(Fictitious Sampling)——最核心的 Insight
为了捕捉间接影响,CAPO 不重放到真实环境(太贵),也不用重要性采样(方差太大),而是直接用当前的策略模型进行虚构推理。
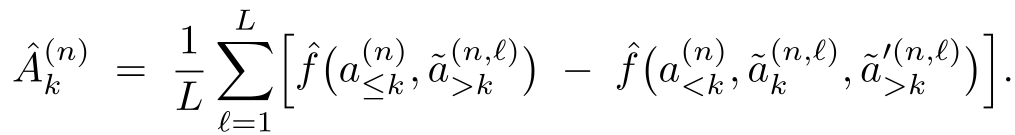 通过在本地采样 downstream 序列,CAPO 能够预测“如果我不这么做,下游会发生什么”,从而实现低方差的优势估计。
4. 实验战果:方差与性能的双重碾压
在对比实验中,CAPO 表现出惊人的一致性:
- 低方差:随着智能体数量 K 增加,CAPO 的误差几乎保持平坦,而 HA-GRPO 则呈指数级上升。
- 端到端性能:在 K=10 的团队中,CAPO 的 Regret 表现显著优于所有基线模型。
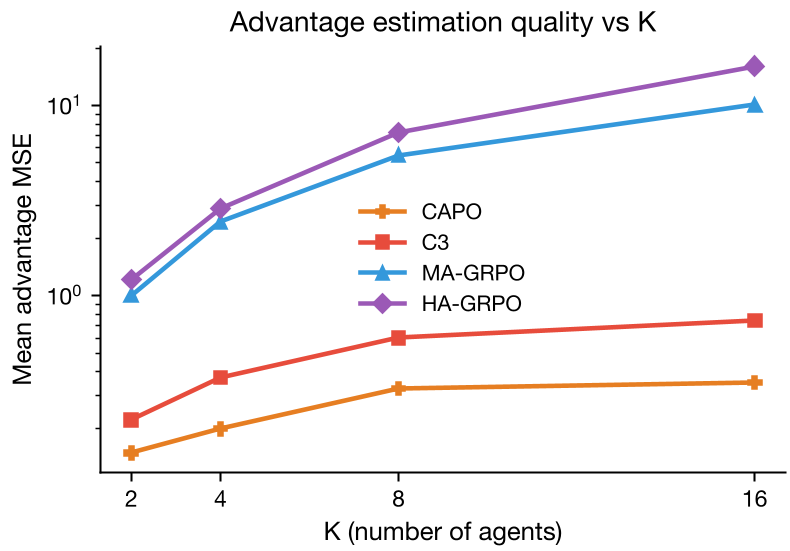 Figure 1: 随着智能体数量 K 增加,CAPO 的 MSE 保持稳定,体现了极佳的扩展性。
5. 深度洞察:为什么间接影响(Indirect Effect)如此关键?
在消融实验中,作者比较了 CAPO 与只考虑直接影响的 CAPO-Direct。结果显示,当环境的**非平稳性()**越高(即上游动作严重改变下游分布时),间接影响的修正就越不可或缺。如果忽略这一点,模型往往会收敛到局部最优,无法实现全局协同。
6. 总结与展望
CAPO 为大语言模型 Agent 的协同优化提供了一条新路。它最大的价值在于:将复杂的系统信任归因问题简化为了“回归模型+虚构推理”。
局限性:目前的加性奖励假设在存在极强智能体间交互(如组合逻辑奖励)的情况下可能存在偏差。 未来方向:将 CAPO 扩展到 full MDP 环境(如多步任务)以及真实的多分布式 LLM 推理场景。
本文由资深学术技术主编深度重构。