
ProgramBench:当 AI 丢掉“代码脚手架”,它还能从零写出软件吗?
ProgramBench: Can Language Models Rebuild Programs From Scratch?
本文推出了 ProgramBench,一个衡量 AI 智能体“从零构建(From Scratch)”完整软件能力的基准测试。该基准要求模型仅依靠可执行文件和文档,重新架构并实现能通过其行为等效性测试的完整代码库,涵盖了 FFmpeg, SQLite 等 200 个复杂项目。
TL;DR
Meta 与斯坦福大学等机构发布了 ProgramBench,这是首个衡量 AI 从零开始构建全规模软件能力(Build-from-scratch)的基准测试。与以往给代码填空的测试不同,这里没有现成的类定义或函数体限制。AI 面对的是一个不可见的黑盒可执行文件(如二进制的 PHP 解释器或 SQLite 数据库)及其文档。结果令人沮丧:即便是最强的 Claude 或 GPT-5 模型,面对复杂项目的全案解决率依然为 0。
背景定位:从“修 Bug”到“搞设计”
在学术界,代码生成的研究正从简单的单函数补全(HumanEval)进化到库级故障修复(SWE-bench)。但这些任务都给模型提供了一个“舒适区”——既有的代码仓库。
ProgramBench 彻底打破了这个范式。它要求模型完成从 0 到 1 的飞跃:
- 不仅仅是编码:需要决定使用哪种语言、如何组织目录结构、选择什么数据结构。
- 行为逆向:模型必须像人类黑客一样,通过反复运行原始程序(Probing)来探测隐藏的行为逻辑,并将其固化为自己的实现。
痛点深挖:消失的架构直觉
目前代码大模型(Code LLMs)面临的一个核心痛点是 Inductive Bias(归纳偏置) 的缺失。人类程序员会根据性能、可维护性将代码拆分为模块,而模型往往表现出一种“偷懒”的倾向:它们更喜欢把所有逻辑塞进一个巨大的单文件(Monolithic)里。
核心机制:全自动测试生成的闭环
ProgramBench 最精妙的地方在于它如何进行公平且规模化的评估。为了避免对实现细节的过度限制(Overspecification),作者设计了一套 Coverage-Guided Iterative(覆盖率驱动的迭代生成) 流程:
- Agent 探测:使用一个专门的智能体去读文档、运行原程序、捕捉各种异常输入。
- 测试固化:将观察到的行为写成 pytest。
- 质量管控:引入了“Dummy Program”测试——如果一个测试用例连一个“什么也不干”的程序都能通过,说明测试太弱,会被自动剔除。
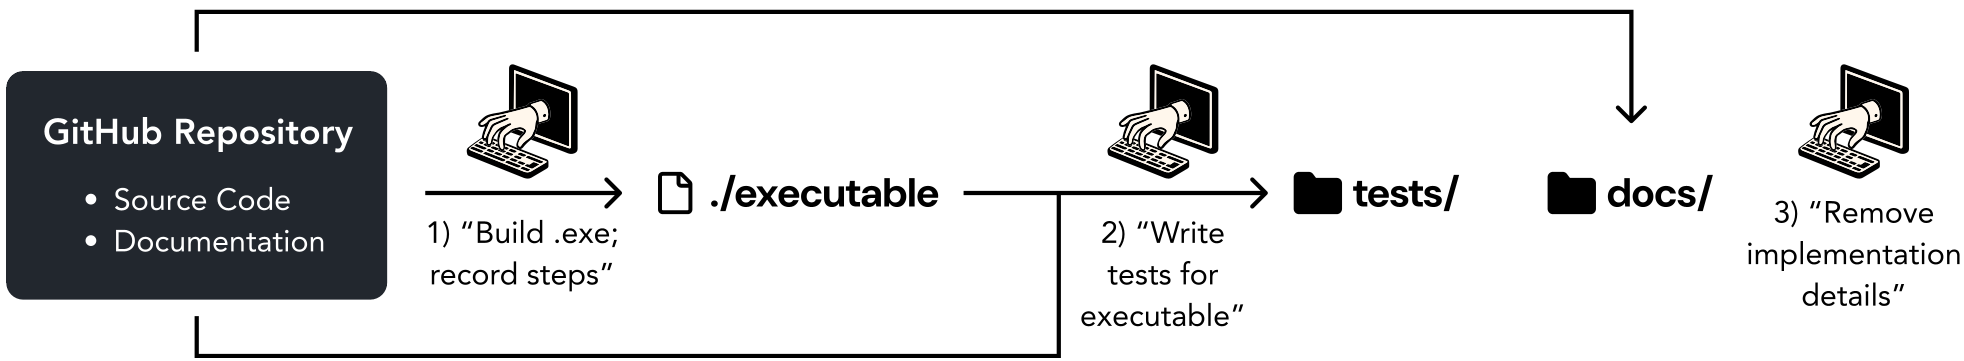 图 1:ProgramBench 任务收集与评估流程
实验战绩:全线告急
论文评估了包括 Claude Opus 4.7, GPT 5.4 以及 Gemini 3.1 Pro 在内的顶尖模型:
- 全军覆没:在 200 个任务(包括 FFmpeg, PHP, DuckDB 等)中,没有一个任务被完全解决。
- 部分进展:虽然全量解决率为 0,但模型展现了部分逻辑还原能力。Claude 系列在测试通过率上略微领先于其他模型。
- 语言偏好:尽管原项目可能是 C++ 或 Rust,模型极度偏爱 Python。即使强制要求换一种语言,模型也往往首选 Python(占比达 51%)。
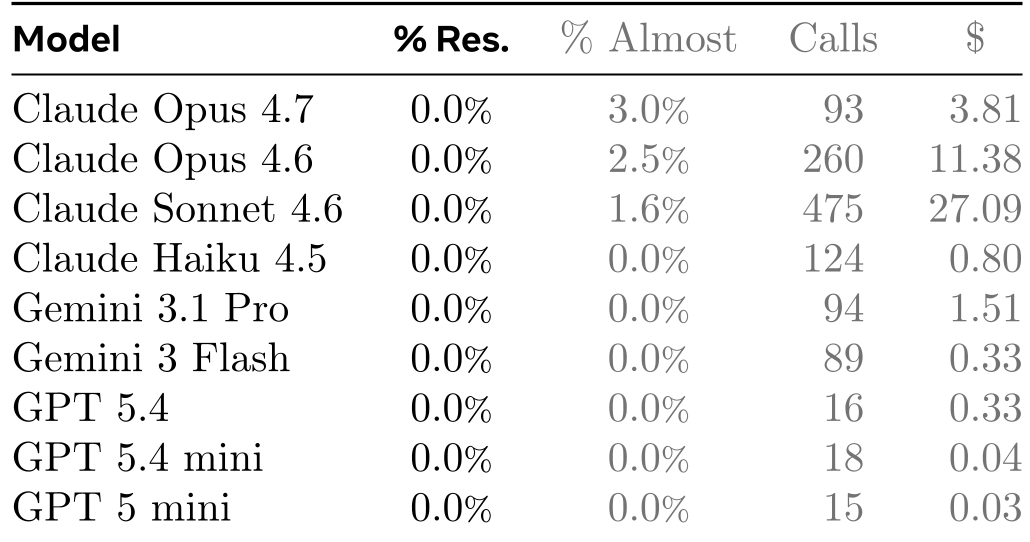 表 1:各主流模型在 ProgramBench 上的表现(Resolved 率均为 0)
深度洞察:AI 为什么写不出好软件?
通过对模型生成的代码库进行审计,作者发现了几点有趣的病理特征:
- 文件结构的“扁平化”: 人类项目的目录深度往往是多层的(Median 2.0),而模型生成的代码几乎全是根目录下的几个文件(Median 1.0)。
- 函数肥大化: 模型写的函数比人类的长得多。例如 Gemini 3.1 Pro 写的函数平均行数是原项目的 1.62 倍,但函数数量却只有 16%。这意味着模型在逻辑抽象上非常笨拙,缺乏拆解复杂逻辑的能力。
- 开发轨迹的“单跳”陷阱: 优秀的开发者会经历“写-编译-测-改”的循环。而 GPT-5 等模型表现出一种“一次性生成(Single-shot)”的特点,缺乏有效的交互式调试。
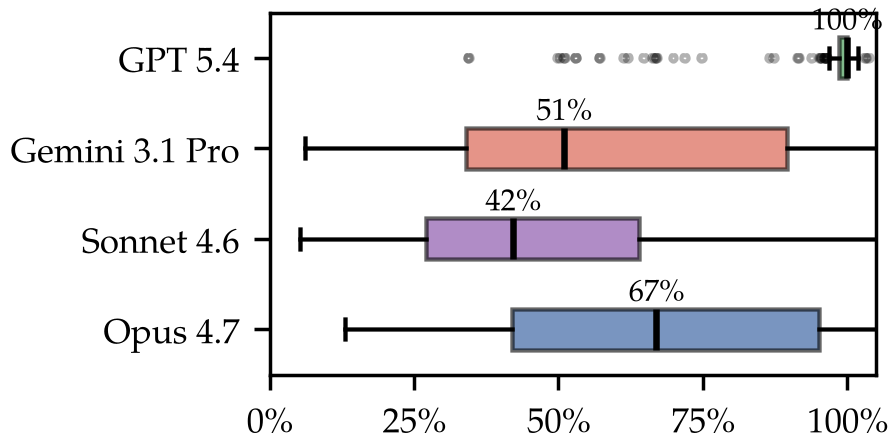 图 2:不同模型的代码库增长轨迹。可以看到某些模型倾向于一次性写完,而另一些则有迭代动作。
总结与局限
ProgramBench 的价值在于它设定了一个极具挑战性的“北极星”目标:真正的自主软件工程。
局限性:
- 性能忽略:目前的评估只看逻辑是否一致,不看速度或内存占用。即使 AI 写了一个慢 100 倍的 PHP 解释器,只要输出对,也算通过。
- 测试局限:行为测试毕竟是输入输出的抽样,不能完全代表程序的 100% 形式化正确。
启示: 未来的研究不应仅纠结于模型能记住多少 API,而应关注模型如何像资深架构师一样管理复杂性,并利用其推理能力在黑暗中(即无源代码环境下)探索系统的边界。