
[ICLR 2025] CanViT:首个主动视觉基础模型,用“画布机理”重塑机器视觉
CanViT: Toward Active-Vision Foundation Models
本文推出了 CanViT,这是首个任务与策略无关的主动视觉基础模型(AVFM)。该模型通过 Canvas Attention 机制将 retinotopic 的 ViT 骨干网络与场景级的 spatiotopic 隐式画布(Canvas)有机结合,在 ADE20K 语义分割任务上以极低的推理成本(比 SOTA 少 19.5 倍 FLOPs)实现了 38.5% 至 45.9% 的 mIoU,显著缩小了主动视觉与被动视觉之间的性能差距。
TL;DR
传统的被动视觉模型(如标准的 ViT)总是试图一次性吞掉整张图片。相比之下,人类视觉是“主动”的——我们会移动视线,通过一系列局部的“注视点(Glimpses)”在脑中构建完整的场景。麦吉尔大学与 Mila 研究院提出的 CanViT 首次将这种生物直觉转化为通用的基础模型。它通过一个被称为 Canvas (画布) 的持久化存储空间,成功在 ADE20K 语义分割上打破了主动视觉长期以来的性能天花板,同时在推理效率上实现了数量级的提升。
1. 痛点:为什么主动视觉一直“打不过”被动视觉?
尽管主动视觉(Active Vision)在理论上更符合生物学且计算更高效,但现实却很骨感:
- 密集预测困境:以往的主动视觉模型大多只能做分类,在需要全局空间信息的语义分割任务上往往束手无策。
- 逻辑耦合:之前的模型把“怎么看(感知)”和“看哪里(策略)”高度绑定。这导致模型依赖极其复杂的强化学习(RL)训练,且学到的特征缺乏通用性。
- 效率瓶颈:随着场景分辨率增加,传统的注意力机制计算量呈平方增长,让实时处理高分辨率图像成为奢望。
2. 核心机理:Canvas 与非对称注意力
CanViT 的核心设计哲学是将**思考(计算流)与记忆(存储流)**分离。
场景级隐式画布 (Canvas)
CanViT 维护了一个名为 Canvas 的 latent 空间。不同于特征图,Canvas 是 spatiotopic 的(基于场景坐标系),即使摄像机视角(Viewpoint)在移动,Canvas 上的每个位置都对应场景中的固定区域。这就像是在脑中铺开的一张大地图,每次看一眼(Glimpse),就往对应的坐标填补细节。
非对称 Canvas Attention
这是 CanViT 保持高效的“秘密武器”。作者发现,如果让 Canvas 像普通 Transformer 一样做自注意力,计算成本会瞬间爆炸。
- 做法:在向 Canvas 写入信息或从 Canvas 读取信息时,所有的 QKVO 投影操作都只发生在小规模的局部骨干网络(Backbone)一侧。
- 结果:画布侧几乎不需要额外的参数和线性映射,从而支持部署极高分辨率的 latent 空间,而不会拖累推理速度。
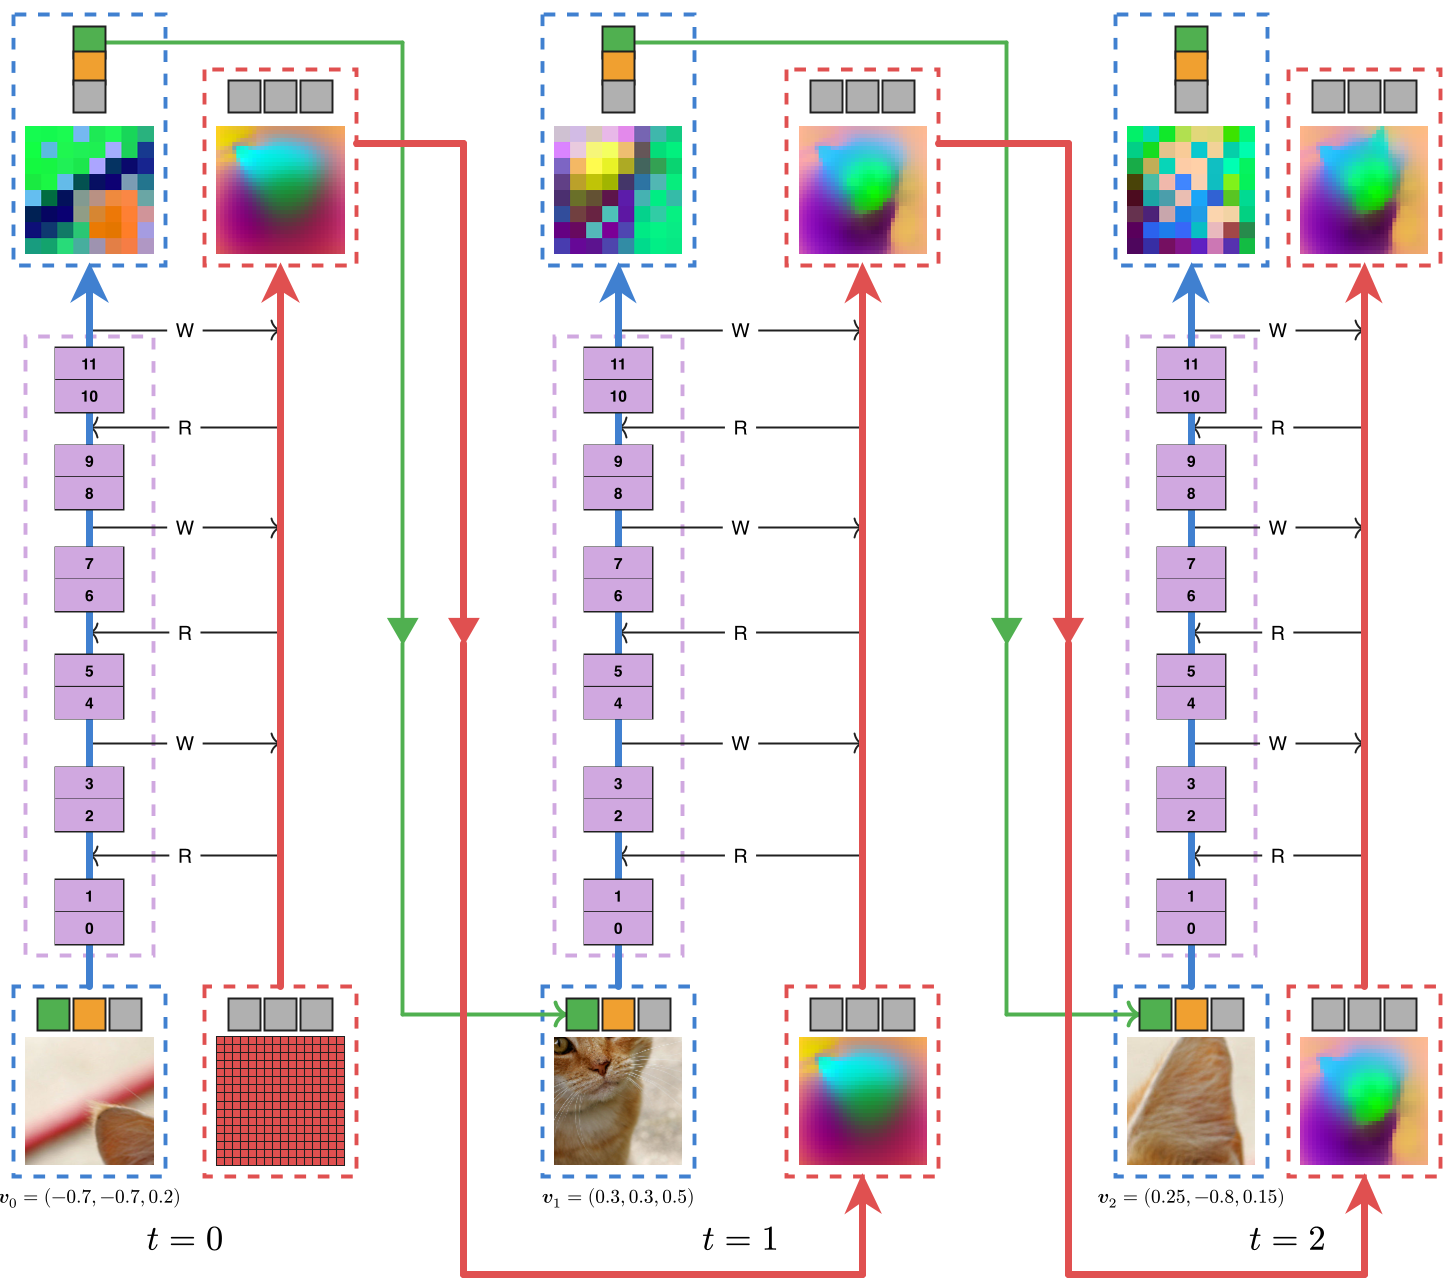 图 1:CanViT 架构。局部注视点(Glimpse)通过 ViT Backbone 处理,并与全局 Canvas 进行双向信息交互。
3. 训练革命:从被动到主动的知识蒸馏
为了让模型学会如何从碎片化的注视中“拼凑”出完整的世界,作者提出了一种创新的训练方案:被动到主动密集蒸馏。
- 老师 (Teacher):成熟的被动模型 DINOv3。它“看”过全景图,拥有深厚的全局语义理解。
- 学生 (Student):CanViT。它只能看到随机生成的、不同缩放级别的 Glimpse 序列。
- 目标:强迫 CanViT 在其 Canvas 中重构出 DINOv3 观察到的全局 latent 特征。这使得模型在无需任何人类标签的情况下,学会了空间外插和语义补全。
4. 实验战绩:主动视觉的新标杆
CanViT 在多项任务中展现了碾压式的优势。
语义分割 (ADE20K)
在不进行任何任务特定微调(Zero-shot Linear Probe)的情况下:
- CanViT-B:45.9% mIoU。
- 此前 SOTA (AME):27.6% mIoU。
- 对比:CanViT 所需的计算量(FLOPs)仅为 AME 的十几分之一,却在精度上实现了飞跃。
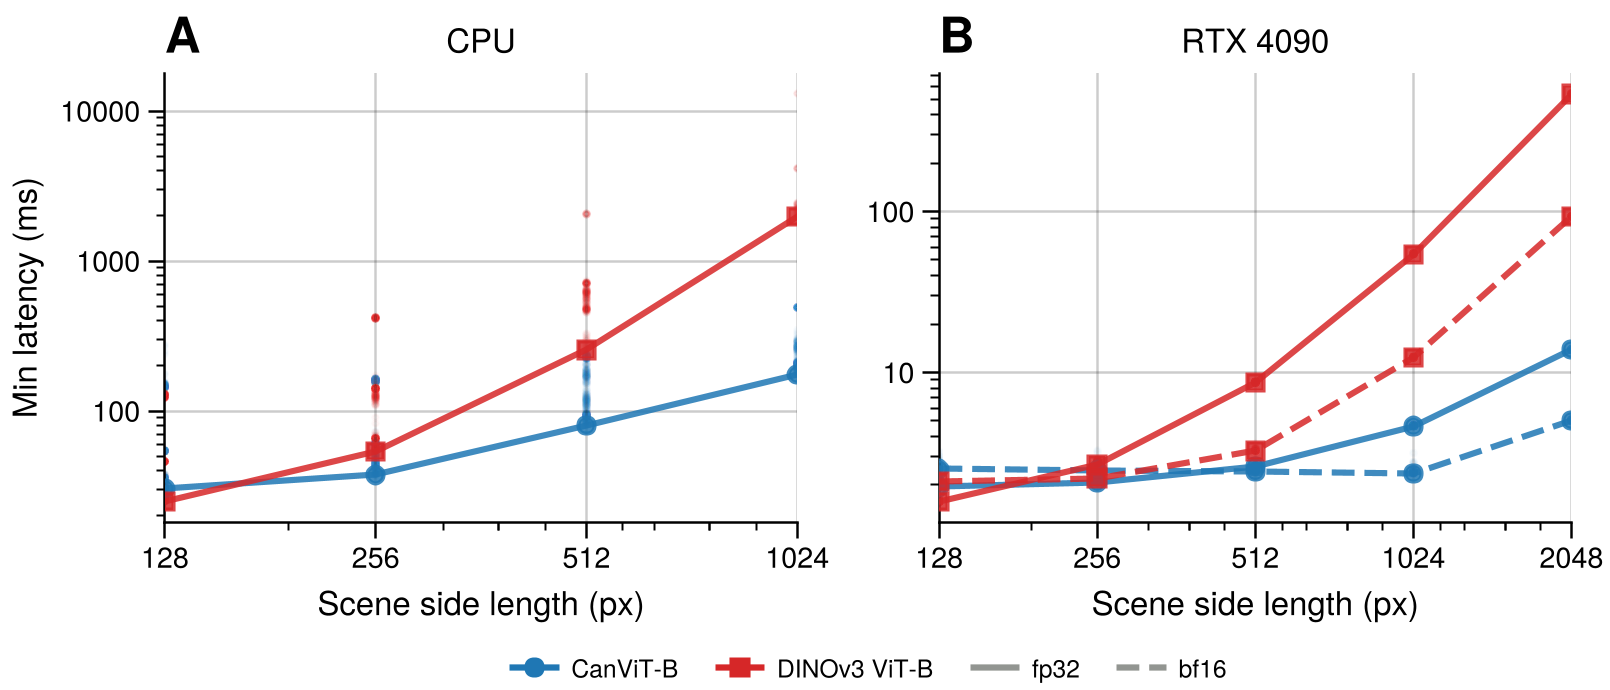 图 2:在 2048px 高清分辨率下,CanViT 的推理延迟极低,展现了卓越的可扩展性。
策略泛化
有趣的是,即便是在训练时从没见过的“由粗到精(Coarse-to-Fine)”观察策略下,CanViT 依然表现稳健。这证明了它确实学到了场景的内在逻辑,而不仅仅是拟合某种路径。
5. 局限性与洞察
尽管表现卓越,CanViT 目前仍依赖被动视觉模型作为老师进行蒸馏。未来,如果能实现“画布式自监督(Latent Bootstrapping)”,摆脱对预训练老师的依赖,主动视觉将真正具备冲击主流视觉范式的能力。
总结: CanViT 告诉我们,主动视觉的成功并非取决于多么精妙的视角选择算法,而在于是否有一个足够强大、能跨越时空整合信息的“内在画布”。这种架构极大地降低了高分辨率感知的成本,为自动驾驶和具身机器人指明了新的方向。