
[CVPR 2025] CCF:打破 LiDAR 主导地位,实现 3D 检测的跨域鲁棒融合
CCF: Complementary Collaborative Fusion for Domain Generalized Multi-Modal 3D Object Detection
本文提出了 CCF (Complementary Collaborative Fusion),一种针对多模态 3D 目标检测在域泛化(Domain Generalization)场景下的增强框架。该方法通过 Query 解耦损失、LiDAR 引导的深度先验和互补跨模态掩码,显著提升了模型在雨天、夜晚等未知目标域的鲁棒性,在 nuScenes 跨域基准测试中达到了 SOTA 性能。
TL;DR
在自动驾驶 3D 检测中,LiDAR 往往是全场的 "MVP",但这导致了模型在恶劣天气下对视觉信息的严重忽视。本文提出的 CCF (Complementary Collaborative Fusion) 框架,通过引入 Query 解耦监督、LiDAR 辅助深度补完以及互补掩码增强,纠正了双分支检测器中的模态偏见。实验证明,该方法在不牺牲常规性能的前提下,显著增强了模型在雨天和夜晚等极端环境下的泛化能力。
1. 痛点:被“霸总”模型忽略的视觉线索
尽管 LiDAR-Camera 融合已经成为 SOTA 3D 检测标配,但研究者通过实验发现,现有的双分支检测器(如 MV2DFusion)在跨域部署时表现脆弱。
本质原因在于“模态分配不均”:
- 匹配上的不公平:由于 LiDAR 的几何信息天然更准,在训练时的 Hungarian Matching 过程中,大部分 Ground Truth 会被 LiDAR 分支的 Query 抢走。统计显示,3D Query 与 2D Query 获得监督的比例竟然高达 37.5 : 1。
- 定位上的先天不足:2D 提案转化到 3D 空间时,依赖的图像深度估计在雨天环境下误差会暴增到 3 米以上。
- 融合中的路径依赖:解码器学会了“偷懒”,过度依赖 LiDAR,导致当点云受损时(如雨水散射),模型直接“抓瞎”。
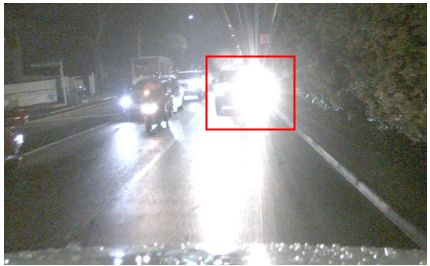 图 1:(a) 展示了雨天点云稀疏与夜晚光照不足带来的不同模态退化;(b) 揭示了 2D 提案查询性能远低于 3D 提案。
2. CCF 核心机制:让模态协作更均衡
2.1 Query 解耦损失 (Query Decoupled Loss)
为了防止图像分支被“饿死”,作者设计了三个并行的解码器路径:2D-only、3D-only 和 Fused。
- 它们共享参数,但在自注意力(Self-Attention)层进行隔离。
- 2D-only 路径强迫模型在没有任何 LiDAR 帮助的情况下优化图像 Query,确保图像分支能获得稳定的梯度流。
2.2 LiDAR 引导的深度先验 (LiDAR-Guided Depth Prior)
针对 2D Query 定位难的问题,CCF 不再让图像分支死磕“单目深度估计”。
- 双源融合:将图像预测的深度分布与该区域内已有的 LiDAR 点云统计分布(直方图)相结合。
- 专家乘法 (PoE):使用一个轻量级的置信度网络动态分配权重,生成的融合深度极大提高了 2D Query 的几何初始化精度。
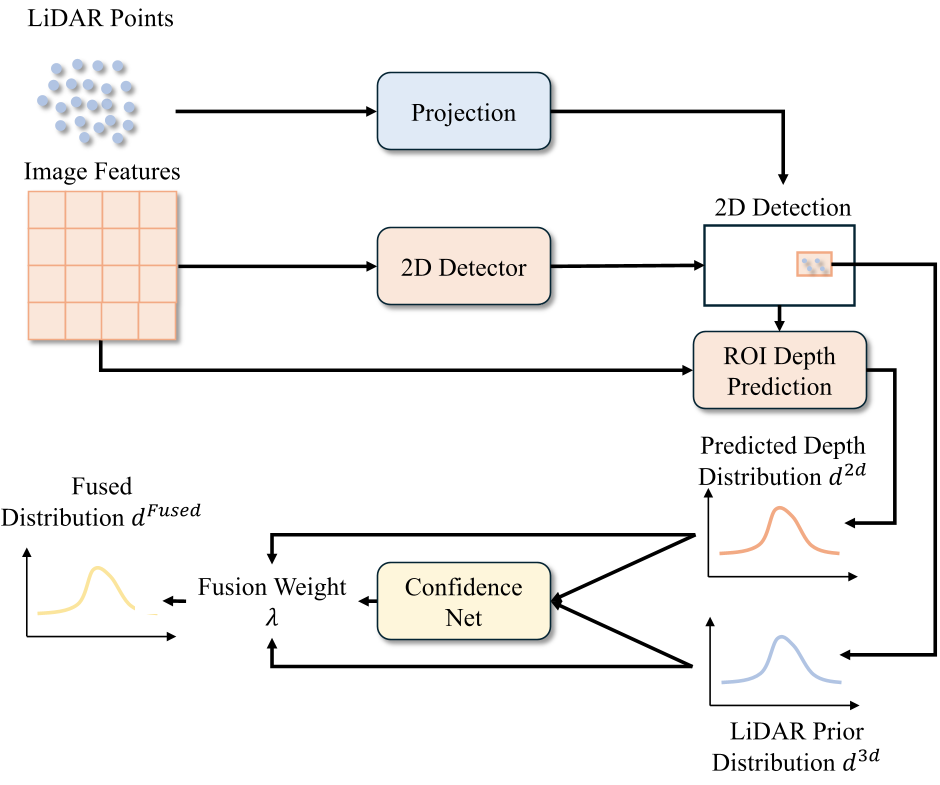 图 2:LiDAR 引导深度先验的示意图。
2.3 互补跨模态掩码 (Complementary Cross-Modal Masking)
为了模拟真实世界的异步退化(比如雨刮器挡住摄像头但 LiDAR 正常),CCF 在训练中引入了互补掩码:
- 如果某个区域的图像像素被遮掩,则保留其对应的点云;反之亦然。
- 这强迫解码器不能只盯着一扇窗户看,必须学会根据当前哪种信号更靠谱,动态调整竞争策略。
3. 实验战绩
作者在 nuScenes 模型偏移基准上进行了严苛的测试:
| 场景 | Baseline (mAP) | CCF (mAP) | 提升 (Gain) |
|---|---|---|---|
| Rain | 41.9 | 44.7 | +2.8 |
| Night | 42.9 | 44.2 | +1.3 |
| Boston | 47.4 | 50.6 | +3.2 |
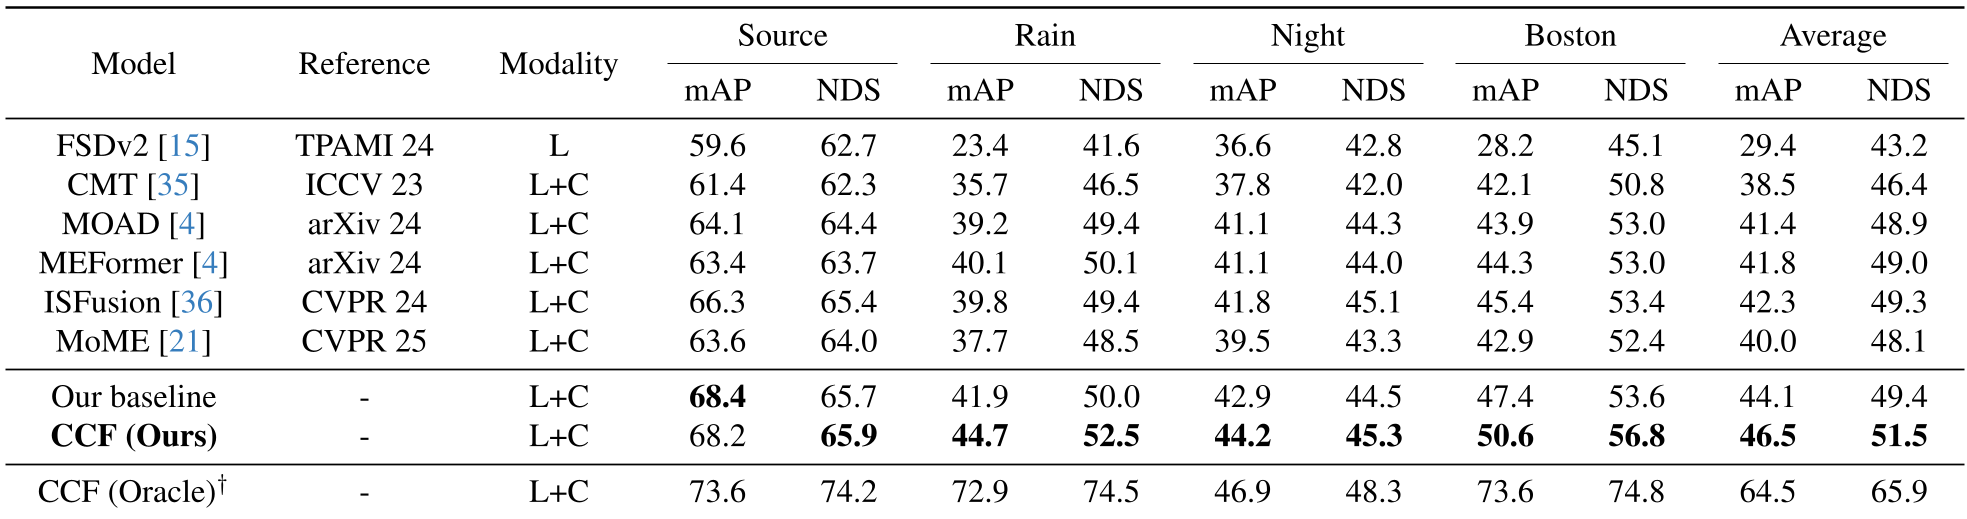 表 1:跨域检测性能总结。
消融实验证明,互补掩码(Complementary Masking)是提升跨域鲁棒性的关键,它比简单的随机 Dropout 更能有效模拟传感器失效带来的不对称性。
4. 深度洞察
CCF 的成功在于它直面了多模态模型中的 Inductive Bias(归纳偏置) 过剩问题。在点云精准时,依赖几何是正确的;但在长尾场景和恶劣天气下,如果模型在训练期没有建立起“视觉竞争意识”,系统就会变得极度脆弱。这种“解耦监督 + 互补增强”的思路,不仅适用于 3D 检测,对于多模态融合的其他任务(如语义分割、BEV 预测)同样具备极高的启发价值。
局限性:该方法目前主要在双分支提案级检测器上验证,对于端到端的统一特征融合架构(如 BEVFusion)的适配性仍有待进一步探索。