
CompCQ:大规模大模型胜任力问题生成的深度评测:我们离自动化本体建模还有多远?
Characterising LLM-Generated Competency Questions: a Cross-Domain Empirical Study using Open and Closed Models
本文提出了 CompCQ 框架,用于系统化评估 LLM 生成的胜任力问题(Competency Questions, CQs)的质量。研究对比了 Gemini、GPT-4、Llama 3 等 5 种模型在 5 个领域下的表现,揭示了闭源模型与开源模型在 CQs 生成上的显著特征差异。
TL;DR
胜任力问题(CQ)是构建知识本体(Ontology)的命脉。由于人工撰写过于耗时,LLM 成了救星。本文提出的 CompCQ 评测框架显示:Gemini 是“简洁大师”,GPT 是稳健的“通才”,而 Llama 这类开源模型在需求覆盖量上还存在明显的短板。最为关键的发现是:在复杂任务中,不同模型观察到的需求几乎不重叠,这意味着“大模型全家桶”协同才是未来的标配。
痛点深挖:本体工程的“第一公里”难题
在知识工程中,我们要构建一个本体(比如医疗诊断系统),首先要问:这个系统应该能回答什么问题?这些问题就是 Competency Questions (CQs)。
传统的做法是领域专家和本体工程师在一起开会、翻文档,手动撸出这些问题。这不仅效率低,而且往往因为专家个人经验的局限导致需求覆盖不全。LLM 的出现让自动生成 CQs 成为可能,但问题也随之而来:
- 生成的问题人能读懂吗?(可读性)
- 问题的逻辑结构是否支撑复杂的 SPARQL 查询?(复杂度)
- 不同模型生成的 CQs 是不是在大同小异?(多样性与覆盖度)
CompCQ:多维度的“体检报告”
为了回答这些问题,作者设计了 CompCQ 框架,将评估分为三个层面:
1. 复杂度与可读性 (Linguistic & Structural)
作者不只是看句子长短,而是通过 Gemini 2.5 Pro 作为评分员,拆解 CQs 涉及到的本体原语(类、属性、关系、过滤器等),并结合 spaCy 进行句法树深度分析。
2. 语义覆盖与多样性 (Semantic & Diversity)
利用 Sentence-BERT (all-MiniLM-L6-v2) 将每个生成的 CQ 映射到 384 维空间。通过计算余弦相似度和 Shannon 熵,评估模型是只盯着一个点说,还是发散性地覆盖了所有潜在需求。

核心发现:LLM 的“性格”画像
闭源模型:稳健的“专业代书”
- Gemini 2.5 Pro:生成的题目最简洁、可读性最高(FKGL 得分最低)。它倾向于生成能直接转化为简单查询的问题。
- GPT-4:表现极其稳健,相关性(Relevance)得分最高,基本不胡说八道(Hallucination 极低),但在多样性上略显保守。
开源模型:啰嗦的“灵感派”
- KimiK2-1T:在复杂领域(如抑郁症治疗 PDTO)展现出了极高的需求复杂度。虽然生成的句子更长、稍微难懂一点,但它能挖掘出深层的概念关系。
- Llama 3.1/3.2:表现令人失望。虽然能生成高质量的 CQ,但数量太少。在需要 30 个问题才能讲清楚的领域,它可能只给 8 个,存在严重的“需求丢失”。
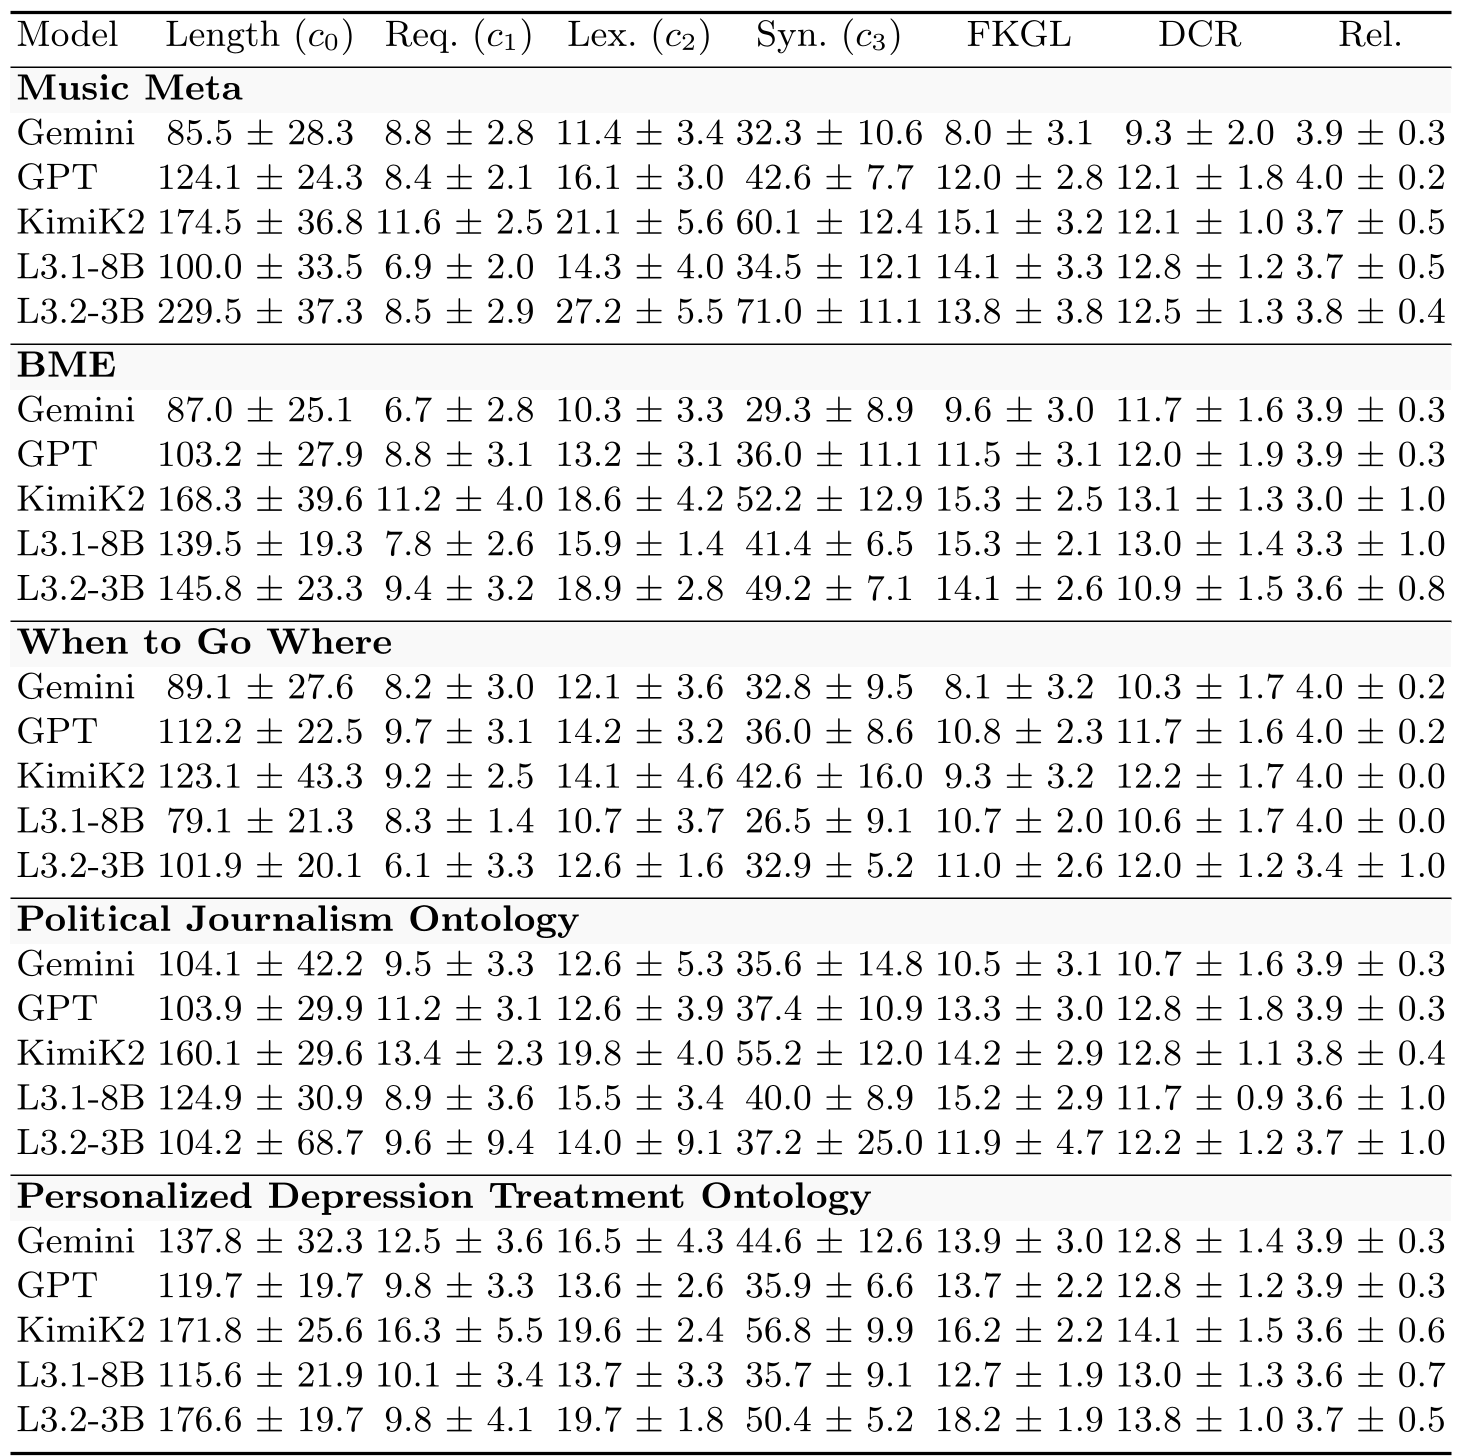
深度洞察:为什么我们需要“多样性”?
文章最惊人的发现在于 Pairwise Set Comparison(两两集合对比)。
在简单的“旅游推荐”任务中,模型们达成了高度共识,语义覆盖重合度很高。但在复杂的“音乐文化遗产”任务中,不同模型生成的 CQs 语义重合度接近 0%!
这意味着:Gemini 看到的视角,GPT 完全没看到;而 Kimi 挖掘到的细节,Llama 也漏掉了。 这种“横看成岭侧成峰”的现象说明,目前单一模型无法完成闭环的自动化建模。

总结与未来展望
Takeaway:
- 别在一个树上吊死:生成本体需求时,建议同时运行 2-3 个顶尖模型。
- 闭源负责精度,开源负责深度:Gemini/GPT 确立核心架构,Kimi 等模型提供长尾多样性。
- 人类依然不可或缺:模型生成的 CQs 复杂度很高,但仍需要本体工程师进行最后的“降噪音”和逻辑串联。
局限性: 该研究主要基于 0-shot 提示,未来如果引入 Few-shot(带有特定模式的模板),可能会改变开源模型“数量稀疏”的问题。
本文基于《Characterising LLM-Generated Competency Questions》论文重构。