
引用了但不代表对了:深度剖析 LLM 研究智能体的源头归因困局
Cited but Not Verified: Parsing and Evaluating Source Attribution in LLM Deep Research Agents
本文提出了第一个端到端的源码归因评估框架,旨在量化评估深搜研究智能体(Deep Research Agents)生成的 Markdown 报告。该框架通过 AST 解析器提取引用-断言对,并在链接可用性、内容相关性和事实准确性(Fact Check)三个维度上对 14 种主流 LLM 进行了基准测试。
TL;DR
你是否习惯性地信任带有引用的 AI 回复?PwC 的最新研究给行业泼了一盆冷水。他们开发了一套名为 Source Attribution Evaluation Framework 的框架,对包括 GPT-5 系列、Claude 4.5/4.6 等 14 个模型进行了“大考”。结论令人深思:链接往往是顺滑的,内容也是相关的,但引用的事实准确性却低得惊人。尤其当 AI 搜索得越多,它就越容易在事实编织中“翻车”。
核心速览
本文在学术坐标系中属于**提示工程与评估基准(Evaluation Benchmarks)**的突破。在此之前,大家主要关注 AI 是否“敢写”引用,而本文则通过死磕“引用质量”,揭示了当前深度研究智能体(Deep Research Agents)在处理长上下文和多源信息时的本质脆弱性。
痛点深挖:被掩盖的“归因幻觉”
目前的 RAG 系统存在一个巨大的认知偏差:认为只要提供了引用,模型输出就是可信的。 目前的评估方法通常只能做到:
- 二元验证:看这段话后面有没有挂链接。
- 自洽性检查:让 AI 自己看自己引用的内容。
这种“自己查自己”的方式具有天然的 Self-enhancement Bias。更专业的痛点在于,很多引用链接虽然能点开(Link Works),讲的主题也对(Relevant Content),但具体的数字、日期或结论在源文件中根本找不到,这就是所谓的事实失真。
方法论详解:三位一体的评估管道
作者设计的框架非常严谨,它不相信 LLM 的自我解析,而是采用硬核的 Markdown AST Parser。
1. 结构化提取 (Phase 1)
通过解析 Markdown 的抽象语法树,将复杂的报告拆解为“断言-引用对”(Claim-Citation Pairs)。这种确定性解析避免了引入额外的 LLM 幻觉。
2. 三维评估指标 (Phase 2)
- Link Works (可访问性):硬指标,URL 必须能 HTTP 通讯。
- Relevant Content (相关性):语义层面的对齐。
- Fact Check (事实校验):这是最难的一关。要求 AI 判定源文是否真的支持该断言中的每一个数字和逻辑。
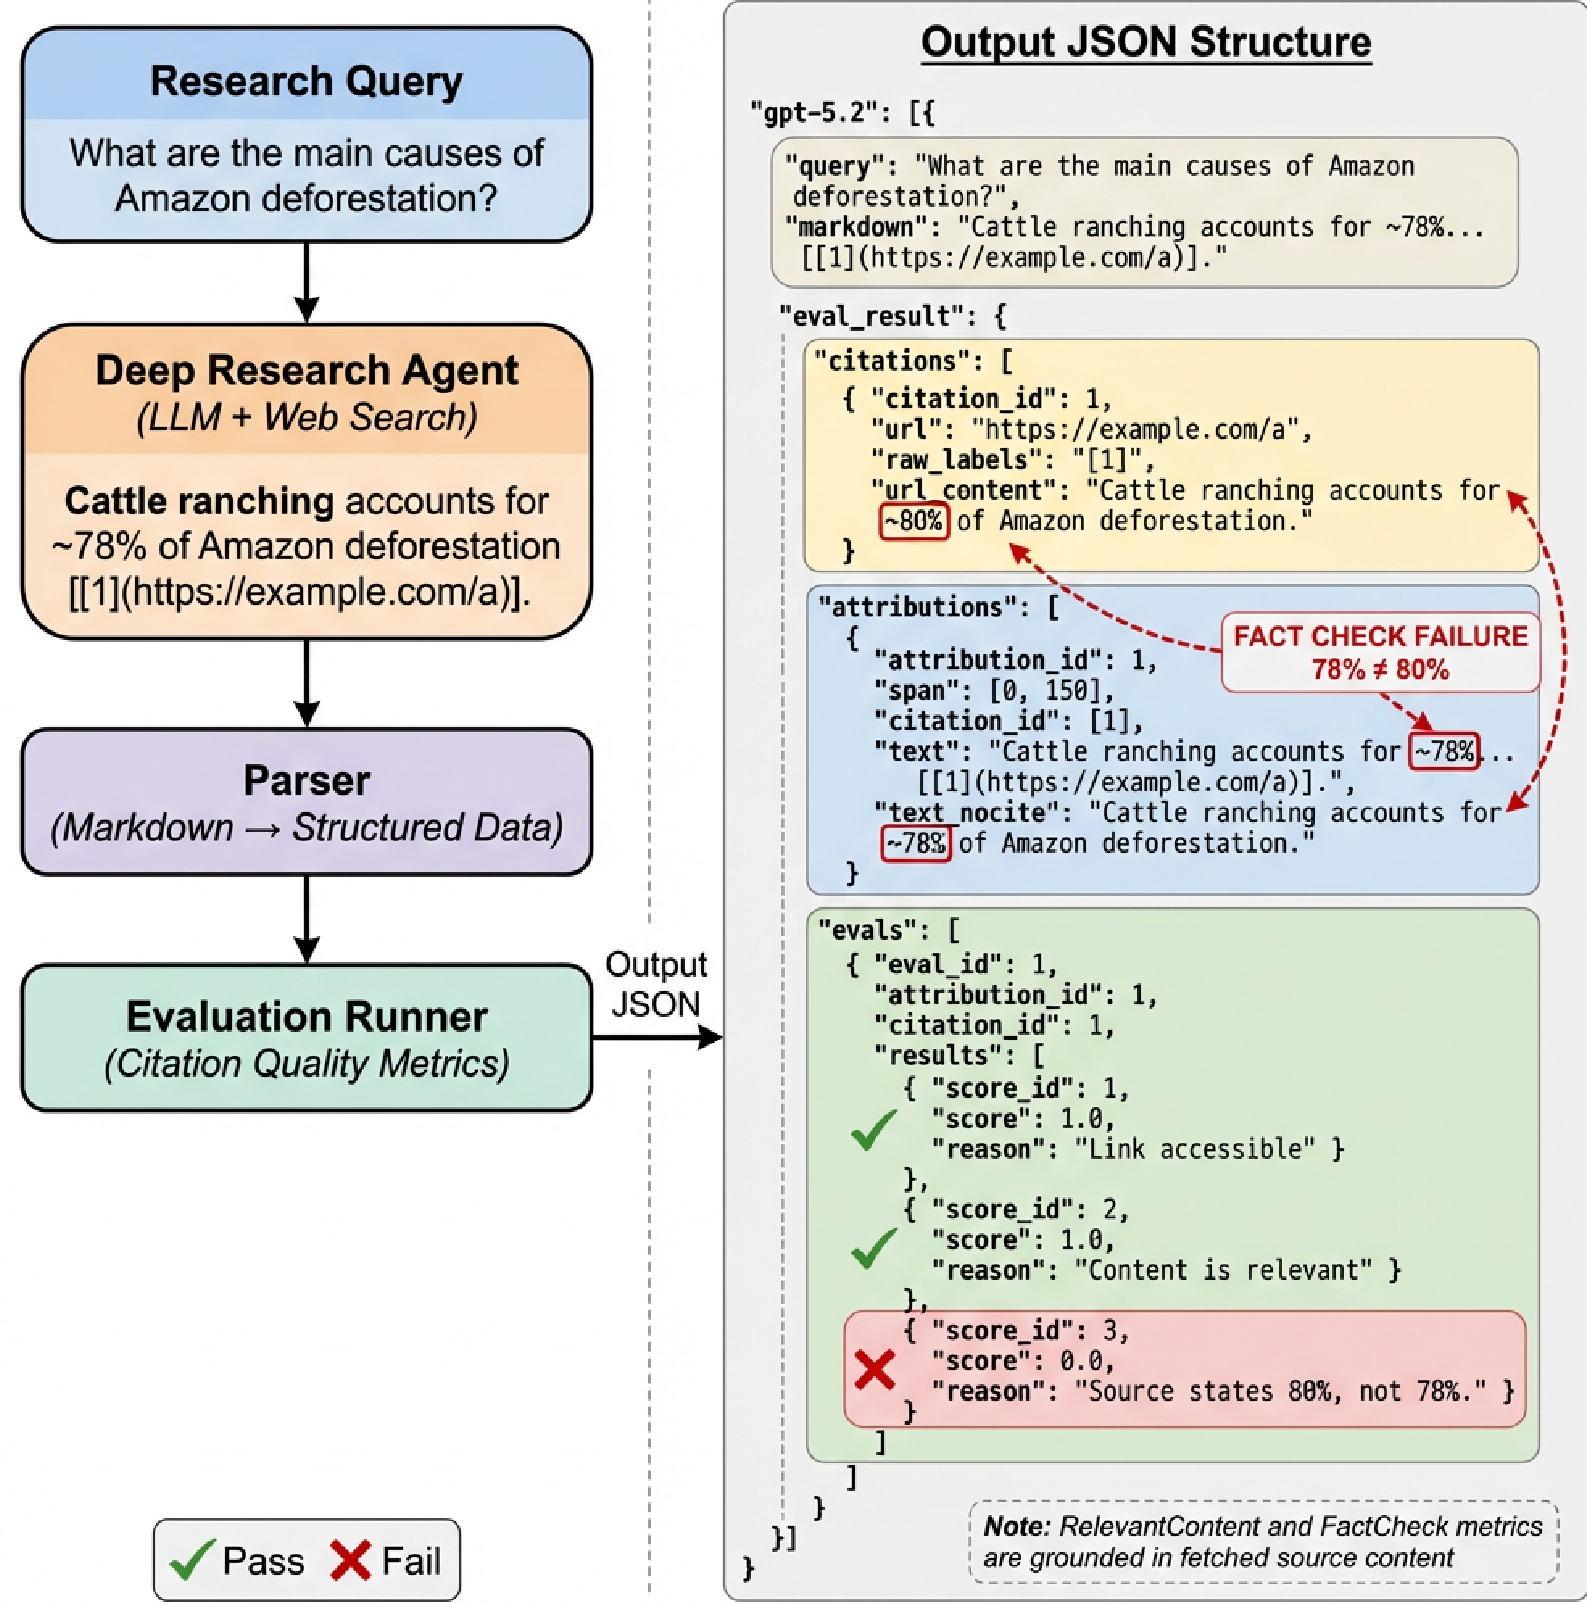 图 1:从 Markdown 报告到三维维度评分的自动化 Pipeline
实验与结果:震撼的“负相关”
实验覆盖了 OpenAI、Anthropic 和 Google 的全家桶,以及主流开源模型。
核心发现:事实准确性是唯一的“试金石”
如表 1 所示,Claude Opus 4.5 在事实准确性上表现最好(76.8%),而 GPT-5 Mini 虽然生成了最多的引用,其准确率却仅有 38.9%。这说明引用数量与引用质量往往成反比。
深度洞察:越努力,越窘迫?
最有趣的发现来自于消融实验(Ablation Study)。随着搜索工具调用次数(Tool Calls)的增加,Link Works 和 Relevance 指标稳如老狗,但 Fact Check 分数却断崖式下跌。
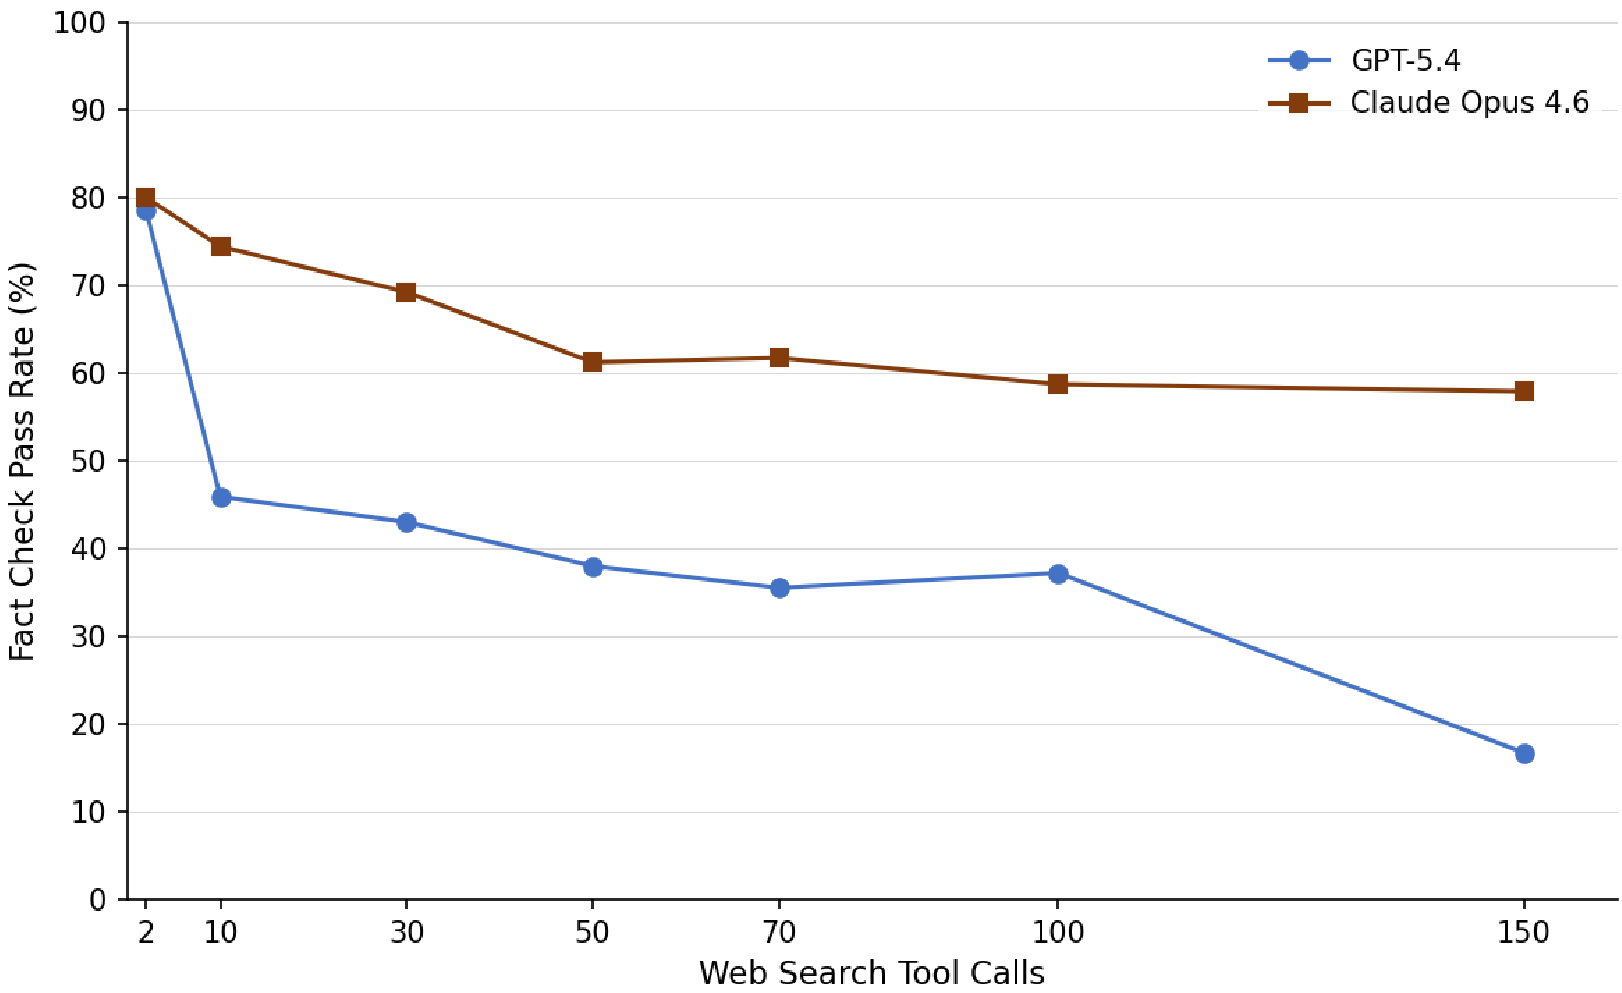 图 2:事实准确度随搜索深度增加而急剧下降,GPT-5.4 甚至跌破了 20%
这种**信息过载(Information Overload)**现象证明了:目前的 LLM 在面对数百个搜索片段时,会因为注意力稀释(Attention Dilution)而开始“胡言乱语”,在大规模信息集成中发生逻辑串线。
深度洞察与总结
关键启示 (Takeaways)
- 不要迷信引用格式:精美的 Markdown 格式和有效的链接是最好的伪装。
- 检索策略需转型:比起盲目增加搜索步数(Breadth),未来的 Agent 应该更注重对少量高质量源文的深度归一化理解(Depth)。
局限性与未来
本文使用的 "LLM-as-a-judge" 虽然经过了人工校准,但仍可能存在模型偏见。此外,网页链接具有时效性,今天的有效链接明天可能就 404,这对长期可靠性评估提出了挑战。
结论:这项研究为深度研究智能体的普及敲响了警钟。在医疗、法律等严谨领域,我们不仅需要 AI 能够“引经据典”,更需要一套像本文这样的审计机制,确保它说的每一个词都有据可查。