
CKT-WAM:参数高效的跨世界模型上下文知识迁移
CKT-WAM: Parameter-Efficient Context Knowledge Transfer Between World Action Models
本文提出了 CKT-WAM,一种高效的具身智能世界动作模型(WAMs)知识迁移框架。该方法通过在文本嵌入空间构建紧凑的上下文(Context)界面,实现了从强大的教师模型(如 DreamZero-14B)到轻量化学生模型(如 Cosmos-Policy-2B)的参数高效知识迁移。
TL;DR
在具身智能领域,世界动作模型(World Action Models, WAMs)正逐渐替代传统的反应式策略。然而,如何将“重型”教师模型的物理世界直觉传递给“轻量型”学生模型?清华大学与上海 AI Lab 等机构提出的 CKT-WAM 给出了优雅的答案:不再追求逐层对齐,而是将教师模型的知识浓缩为一组“上下文 Token”,直接“喂”给学生模型的文本编码器。该方法仅需 1% 的参数量,便能让小模型在复杂任务中表现出接近巅峰的泛化能力。
1. 痛点深挖:为什么异构模型间的知识迁移这么难?
在机器人控制任务中,我们通常面临一个两难境地:高性能模型(如 14B 参数)拥有极强的物理规律理解力,但推理慢、显存开销大;小模型(如 2B 参数)跑得快,但在没见过的场景下很容易“抓瞎”。
传统的知识迁移方法存在三大死穴:
- 架构死板:如果教师是 DiT,学生是 Transformer,逐层特征匹配(Feature Matching)根本行不通。
- 计算昂贵:全量微调对于大多数实验室和初创公司来说是不可逾越的鸿沟。
- 推理瓶颈:如果在每一帧推理都要调用一遍大模型作为引导,那小模型的速度优势将荡然无存。
2. 核心直觉:把教师模型当成“高级传感器”
CKT-WAM 的核心 Insight 极其精妙:将教师模型的中间层输出视为一种“增强现实”的上下文。
作者并没有让学生去“模仿”教师的行为,而是让教师对当前的视觉观测进行深层编码,提取出对动作至关重要的物理特征,然后将这些特征压缩成少量的 Token。这些 Token 就像是给学生的“小抄”,直接拼接到任务指令(Text Instruction)后面。
3. 方法论详解:CKT 模块的精密构造
CKT-WAM 的架构由三个关键环节组成:
3.1 提取与单次查询 (Single-Pass Extraction)
为了不拖慢推理速度,教师模型只在第一帧或每个 Action Chunk 开始时运行一次,且只运行到中间层(如 40 层中的第 20 层)。这不仅降低了延迟,还利用了中间层更具通用语义的特征。
3.2 压缩与适配 (LQCA & MoE Adapters)
- LQCA (Learnable-Query Cross Attention):将教师数千个视觉 Token 压缩至 32 个关键 Context Token。
- 稀疏专家 (Sparse MoE):针对不同的任务重点(如避障 vs 精准抓取),系统会通过 Router 路由到不同的专用适配器(Specialized Adapters)。
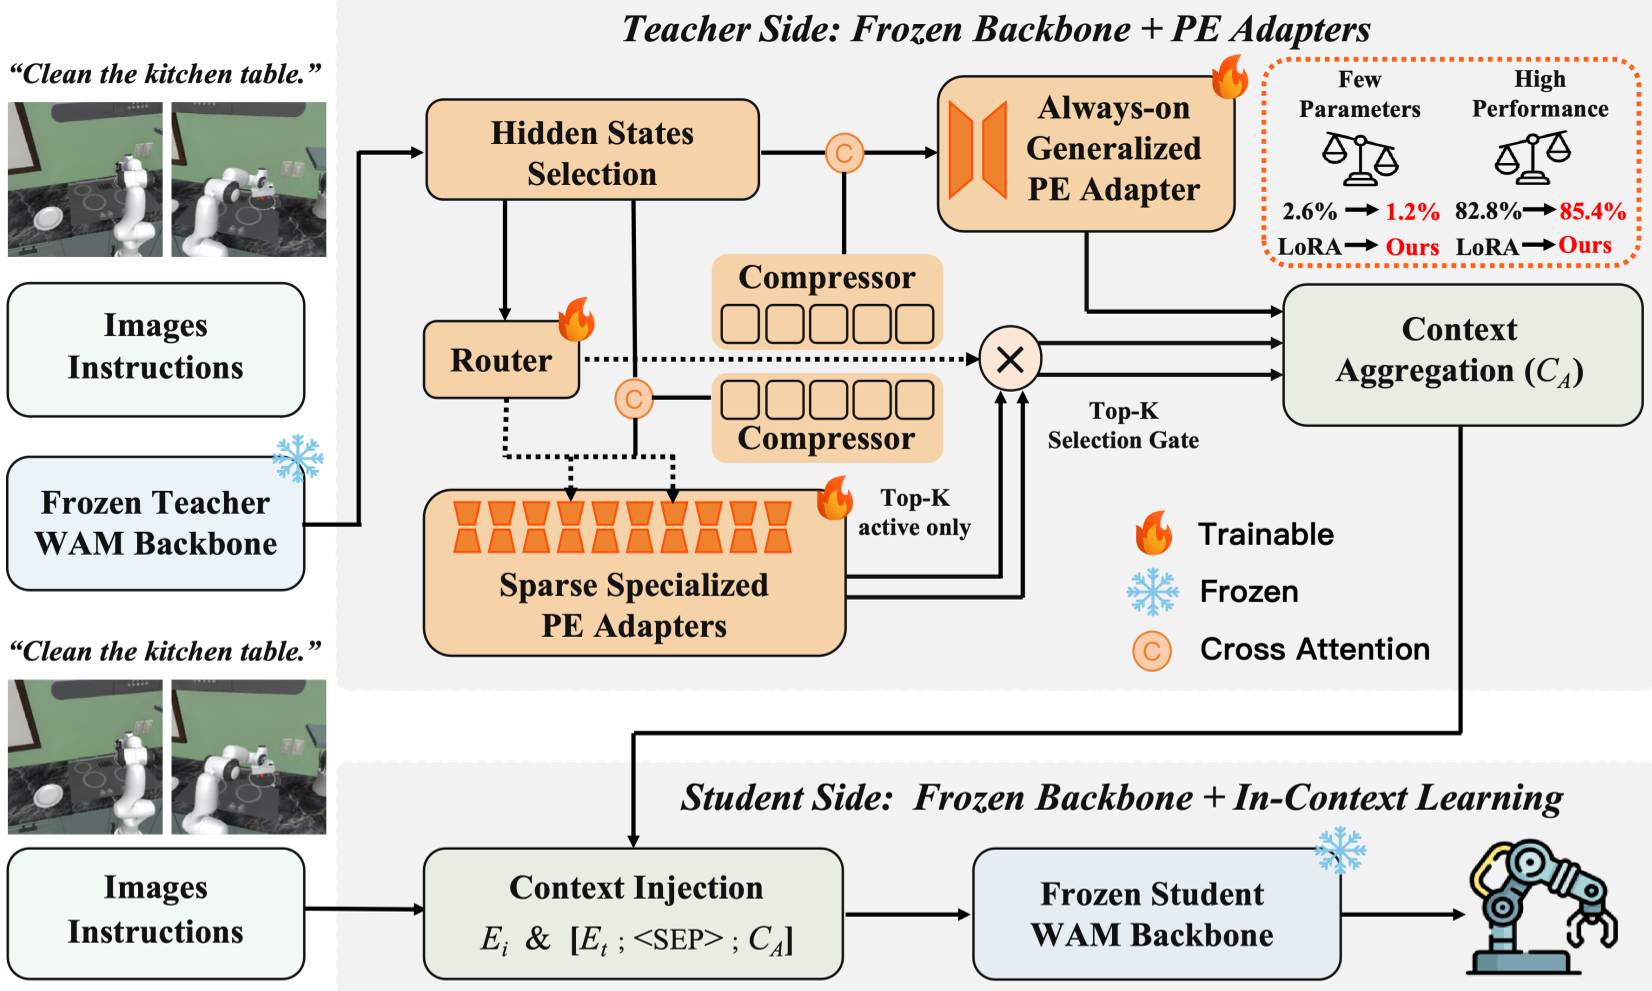 图 1:CKT-WAM 整体架构。显示了从教师隐藏状态到学生文本嵌入空间的压缩与注入流程。
3.3 注入与几何保持 (Context Injection)
这些 Context Token 被追加到文本嵌入 之后。由于 WAM 通常对视觉流使用 3D RoPE(旋转位置编码),而对文本端使用 Cross-Attention,这种拼接方式天然地保证了视觉信息的几何结构不被破坏。
4. 实验与结果:以 1% 的代价挑战全量微调
作者在 LIBERO-Plus 这一极其严苛的泛化性基准上进行了测试,涵盖了相机视角切换、光照变化、背景噪声等 7 个维度。
4.1 性能表现
- 参数量:1.17% 训练参数(187.4M)。
- 成功率:86.1%,与全量微调(Full Fine-tuning)的 86.3% 几乎持平。
- 对比 PEFT:在同等或更低的参数预算下,效果显著超越 LoRA、DoRA、AdaMoLE 等主流适配方案。
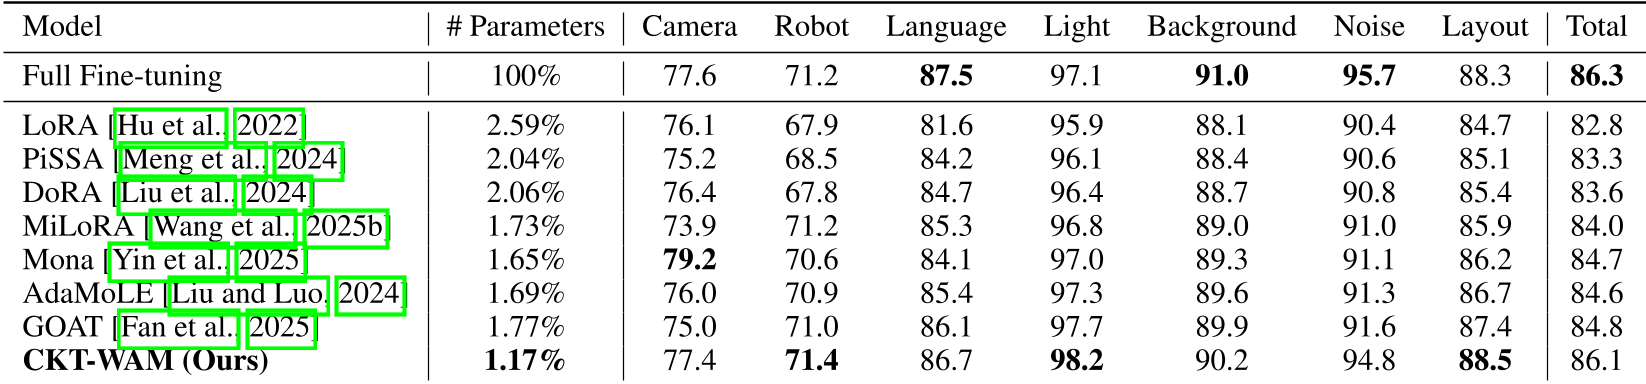 表 1:在 LIBERO-Plus 上的消融实验与基线对比。
4.2 现实世界任务
在真实的“叠衣服”这类长程(Long-horizon)任务中,CKT-WAM 展现了极强的规划能力,平均成功率达到 83.3%,证明了其模型具备应对复杂多步任务的鲁棒性。
5. 深度洞察:为什么选择中间层?
论文中的消融实验(图 2)揭示了一个有趣的权衡:随着提取层深的增加,成功率先升后降(或饱和),而延迟却线性增加。第 20 层(中间位置)被证明是“信息量”与“处理效率”的黄金分割点。这反映了 WAM 在深层可能学到了过于特定于教师输出格式的偏置,而中间层则保留了更纯粹的场景理解。
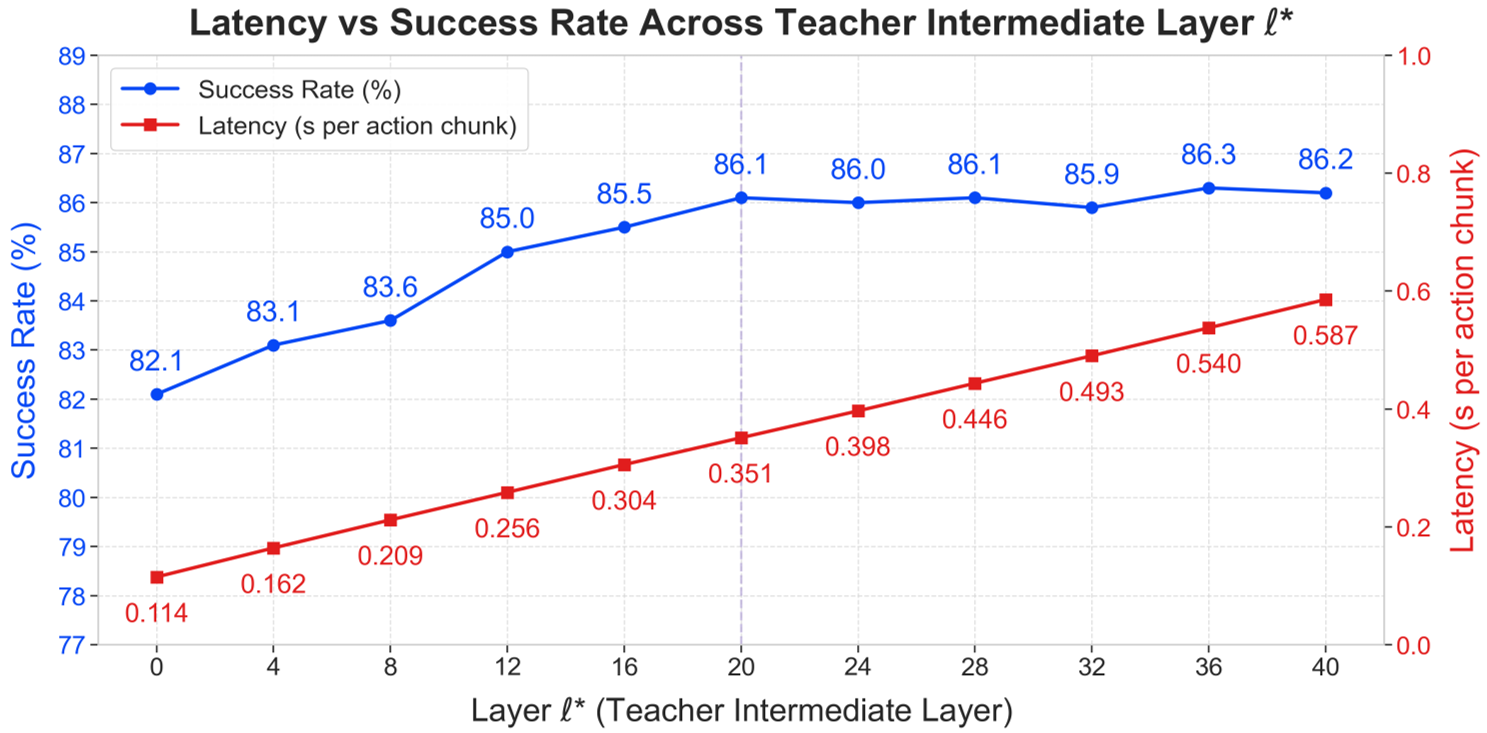 图 2:教师层数选择对性能与延迟的影响。
6. 总结与展望
CKT-WAM 的成功标志着具身智能模型训练范式的转变:从“大模型统一天下”转向“大模型赋能小模型”。
局限性:目前该研究主要集中在机器人控制领域。 未来启示:这种“紧凑上下文注入”的逻辑完全可以推广到其他多模态领域。例如,是否可以用 GPT-4O 的某些中间层特征作为“上下文”,来增强一个端侧轻量化语言模型的逻辑推理能力?这不仅是参数效率的胜利,更是跨模型交互接口设计的胜利。