
[2026 震撼] Claudini:当 AI 开始自主研发 SOTA 攻击算法,红队测试进入自动化时代
Claudini: Autoresearch Discovers State-of-the-Art Adversarial Attack Algorithms for LLMs
本文提出了 Claudini,一个利用 Claude Code 构建的自动研究(Autoresearch)流水线,用于自主发现大语言模型(LLM)的白盒对抗攻击算法。该方法发现的算法在越狱(Jailbreaking)和提示注入(Prompt Injection)任务上显著超越了现有的 30 多种基线方法,在 Meta-SecAlign-70B 模型上达成了 100% 的攻击成功率。
TL;DR
在安全研究领域,人类专家一直占据主导。但最近的一篇论文打破了这一现状:利用 Claude Code 构建的自动研究流水线 Claudini,能够自主设计、实现并迭代 LLM 对抗攻击算法。在这场“机器对机器”的博弈中,Claudini 发现的算法在越狱成功率(ASR)上不仅刷新了纪录,更在 Meta 最强的安全防御模型上实现了 100% 的破防。
背景定位:安全评测的“下划线”
过去,对抗攻击(如 GCG)主要依赖研究员手动调整损失函数和搜索策略。Claudini 的出现标志着 Autoresearch(自动研究) 在安全领域的首个重大突破。正如作者所言,如果一个防御机制连 AI 自动生成的攻击都挡不住,那它的安全声明在当下已经“毫无公信力”。
痛点深挖:为什么人类和传统 AutoML 输了?
对抗攻击本质上是在极高维的离散 Token 空间搜索一个特定的后缀。传统方法(如单纯的梯度下降)极易陷入局部最优;而基于贝叶斯优化的传统 AutoML 工具(如 Optuna)虽然能调参,却无法改变算法的底层逻辑。
Claudini 的优势在于其 研究洞察力 (Research Insight):它能像人类专家一样阅读代码、分析失败原因,并在多代演化中尝试不同算法模块的交叉破壁。
方法论详解:AI 科学家的工作流
Claudini 并不直接编写“攻击提示词”,而是编写**“生成攻击的算法”**。
1. 架构解析
Claudini 的核心是一个闭环迭代系统。
- 感知:阅读现有的 30+ 种攻击算法(如 GCG, TAO, MAC)。
- 假设:提出新的优化策略,例如将持续松弛(Continuous Relaxation)与动量梯度结合。
- 执行:智能体在沙盒中编写 Python 类,并提交 GPU 任务执行。
- 评估与迭代:根据 Token-forcing Loss 的定量反馈调整下一代算法。
2. 关键图表插入
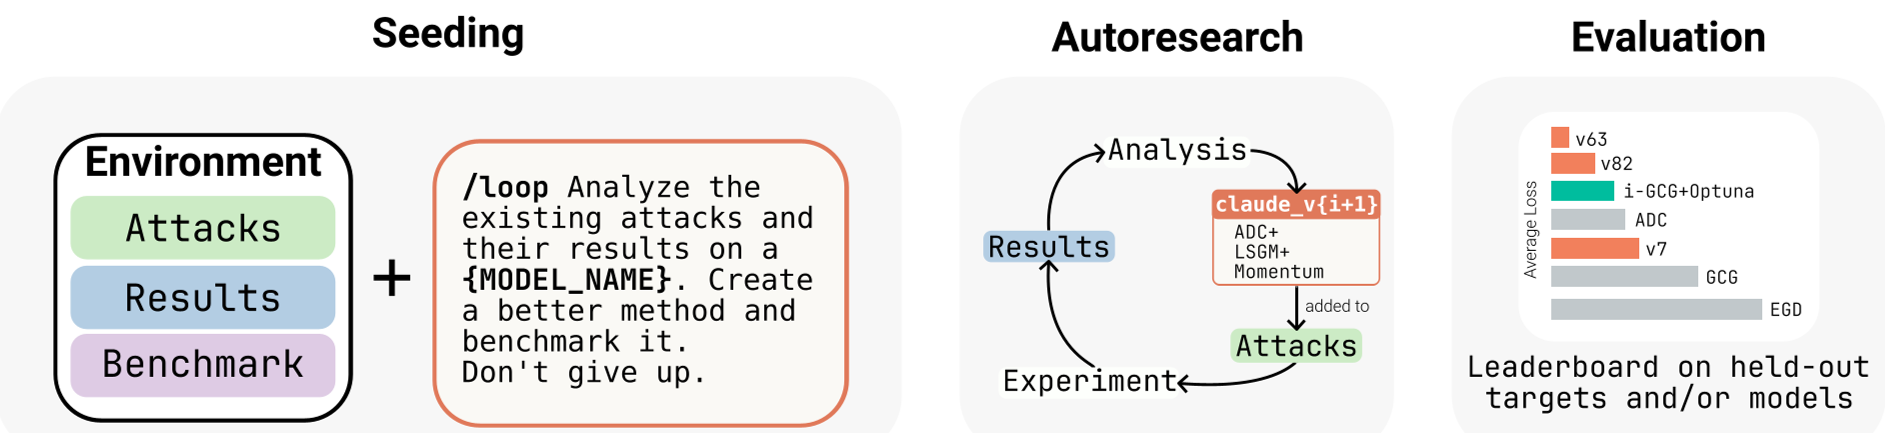 图 3:Claudini 流水线展示了智能体如何从现有库出发,通过 GPU 实验不断优化的闭环。
实验与结果:降维打击
Claudini 发现的 claude_v63 算法展现了恐怖的泛化能力。
- SOTA 对比:在随机 Token 强制任务上,其损失比经过精心调参的基线低了 10 倍。
- 跨模型迁移:在完全没见过的 Meta-SecAlign-70B 模型上,它实现了 100% 的攻击成功率,而之前的最强基线仅为 56%。
- 越狱实战:对 GPT-OSS-Safeguard 的 ASR 提升了 4 倍,成功诱导模型绕过安全过滤。
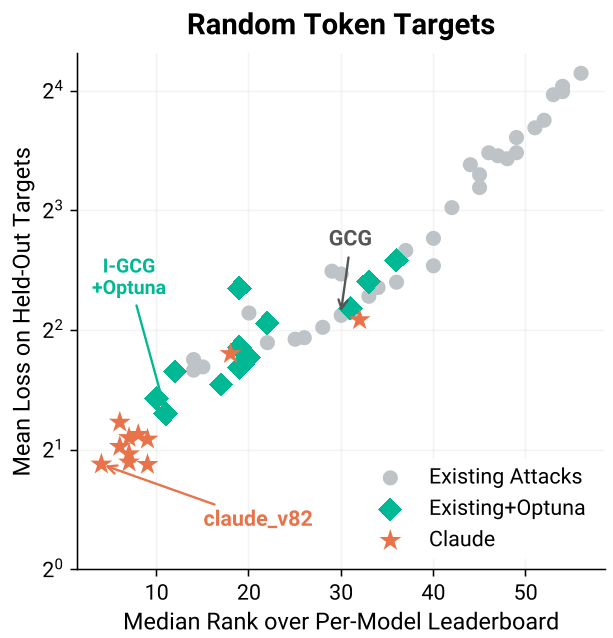 图 1:左图显示了在单一模型上的性能飞跃,中图则展示了从通用优化到特定提示注入任务的强大迁移力。
深度洞察:AI 到底发现了什么?
通过对生成的代码进行逆向分析,研究人员发现 Claude 并不是在乱猜,而是展现了极强的工程直觉:
- 策略重组:它巧妙地将 MAC 的动量平滑梯度应用于 TAO 的余弦相似度候选采样中。
- 逃避机制 (Escape Mechanisms):当优化陷入停滞时,它设计了“耐心触发(Patience-triggered)”的扰动策略,随机替换停滞的 Token 位置以跳出局部最优。
- 从粗到细 (Coarse-to-fine):在前 80% 的步骤中一次替换 2 个位置进行广度探索,最后 20% 切换为单位置精修。
总结与启示
Claudini 的成功向我们展示了一个略显不安的未来:红队攻击的门槛被极大地降低了,而防御的标杆被无限拉高。
虽然目前 Claudini 更多是在“重组”已有创意而非创造全新的数学理论,但其在复杂系统调优上的效率已远超人类。对于未来的 AI 安全研究,自动化红队评测 (Automated Adaptive Red-teaming) 将不再是选项,而是防御上线前的必经之路。
项目代码已开源,访问 romovpa/claudini 了解更多。