
CoPD:打破能力的“横梁效应”,让并行专家在共同演化中实现超越
Co-Evolving Policy Distillation
本文提出了 CoPD (Co-Evolving Policy Distillation),一种用于大模型训练后的多专家能力整合框架。该方法通过让多个专家分支并行训练并交替进行强化学习(RLVR)与双向在线蒸馏(Mutual OPD),成功将文本、图像和视频推理能力整合进单一模型中,性能超越了混合训练及其各自的领域专家。
TL;DR
在大型模型训练后的能力整合中,我们常面临一个尴尬局面:要么直接混合训练导致各项能力“左右手互搏”(梯度冲突);要么先练专家再蒸馏给学生,结果因为“专家太强、学生太弱”导致学生学不会。本文提出的 CoPD (Co-Evolving Policy Distillation) 给出了一种优雅的方案:让多个并行专家在训练中边练边教。通过交替进行领域强化学习和双向在线蒸馏,CoPD 不仅整合了文本、图像、视频推理能力,甚至让最终的统一模型在各领域都超越了专门的领域专家。
背景:整合多专家的两难境地
目前主流的后训练(Post-training)范式主要分为两派:
- Mixed RLVR:把所有领域的数据塞在一起练强反馈。但这会遇到“能力发散”(Capability Divergence)问题,不同任务的更新方向冲突,像翘翘板一样,一头起来另一头就下去。
- Static OPD Pipeline:先单独练出各领域的“巅峰”专家,再把它们蒸馏给一个统一的学生模型。虽然避免了冲突,但作者发现,等专家练成了,它的行为模式(Behavioral Patterns)已经偏离基座模型太远。就像让微积分教授去教幼儿园小孩,小孩根本跟不上教授的思路。
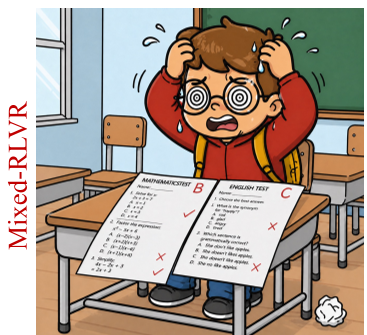 (图中展示了 Mixed RLVR 的能力冲突、Static OPD 的吸收困难以及 CoPD 的共同演化优势)
核心洞察:行为一致性假设
作者通过一项实验量化了蒸馏效率与“师生距离”的关系。他们使用 Top-k Token Overlap(前K个Token的重合度)来衡量行为距离。实验结果令人震惊:蒸馏增益与师生行为重合度呈强正相关。
当专家(教师)在 RLVR 过程中独立进化时,它们与基座(学生)的重合度会迅速下降,导致蒸馏效率进入“低效率区”。因此,一个有效的框架必须满足:
- 在训练中蒸馏:而不是训练后。
- 双向联动:让老师也随着学生一起进化。
- 保持适度差距:既要近到能学会,又要远到有新东西可学。
CoPD 机制:交替前进的舞步
CoPD 的训练过程像是一场精心编排的舞蹈,主要分为两个循环阶段:
阶段 I:分支特定 RLVR (探索)
每个分支在自己的数据集(如文本、图像)上使用 GRPO 算法进行强化学习。这个阶段的目的是“拉开距离”,让每个专家在各自领域深挖,产生差异化的知识。
阶段 II:互惠 OPD (同步)
这是 CoPD 的神来之笔。不同分支互为师生:
- 跨分支采样:文本分支去跑图像分支的问题,生成路径。
- 双向对齐:图像专家在文本专家生成的路径上提供 Token 级的概率分布监督,反之亦然。
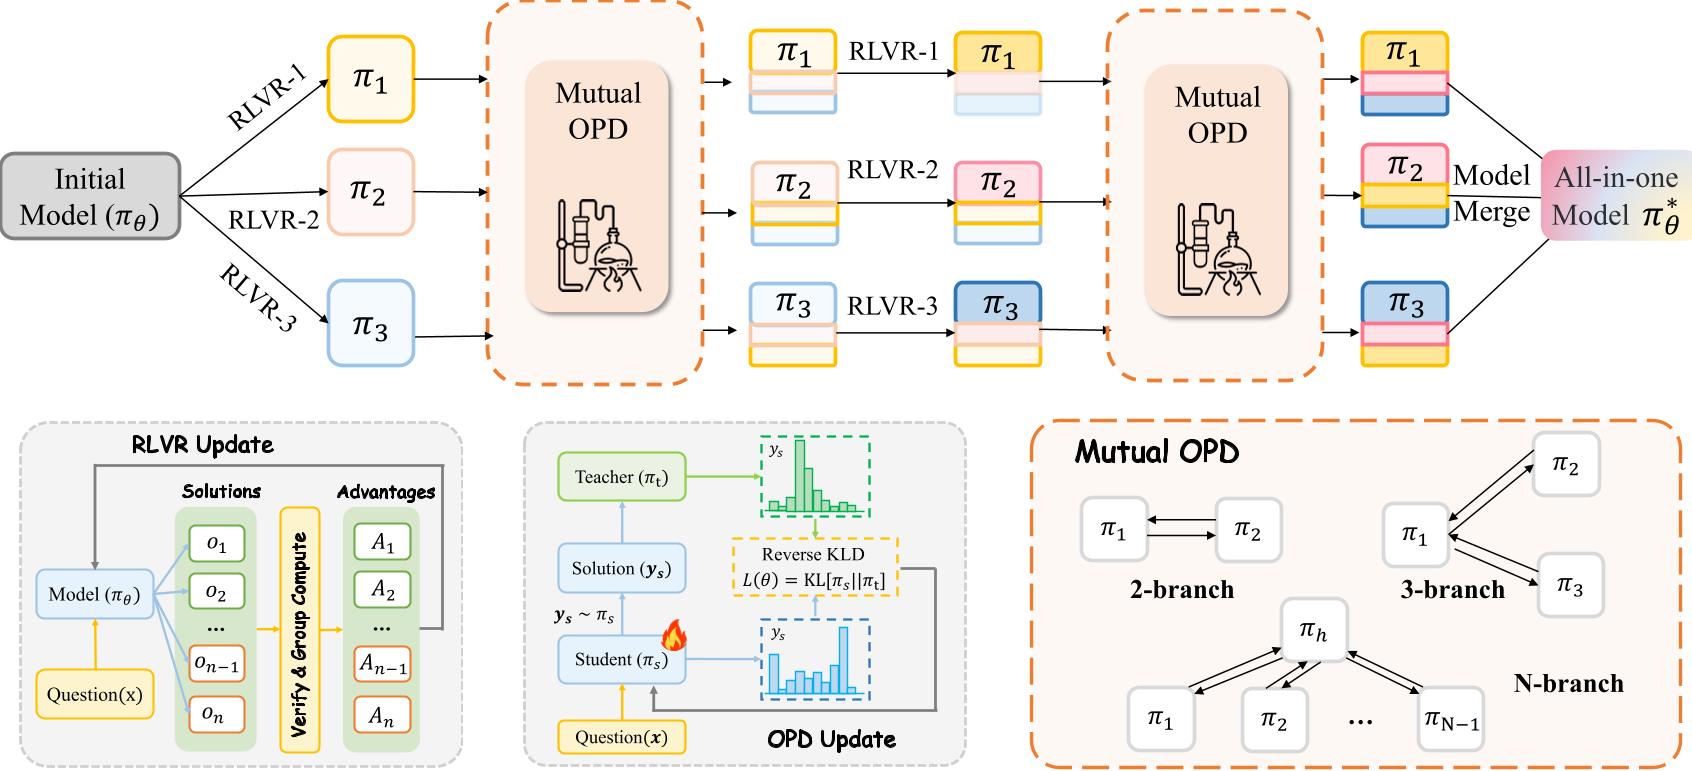 (图 3:CoPD 的整体架构,展示了 RLVR 阶段的独立探索与 OPD 阶段的互惠蒸馏)
通过这种方式,两个分支虽然都在进步,但它们的参数和行为模式始终被“拽”在一起,维持在 90% 以上的高重合度。
实验战绩:1+1 > 2 的奇迹
在 Qwen3-VL-4B 的实验中,CoPD 展现了强大的整合力:
- 全面碾压:在文本(AIME, MATH)和图像(MMMU, MathVista)的所有基准测试中,CoPD 均优于 Mixed RLVR。
- 超越专家:最令人兴奋的是,整合后的模型(CoPD)在文本推理上的 Avg 达到了 58.76%,甚至超过了只练文本的 Text-Expert (57.89%)。这证明了跨领域的知识不仅没有冲突,反而通过共同演化产生了协同效应。
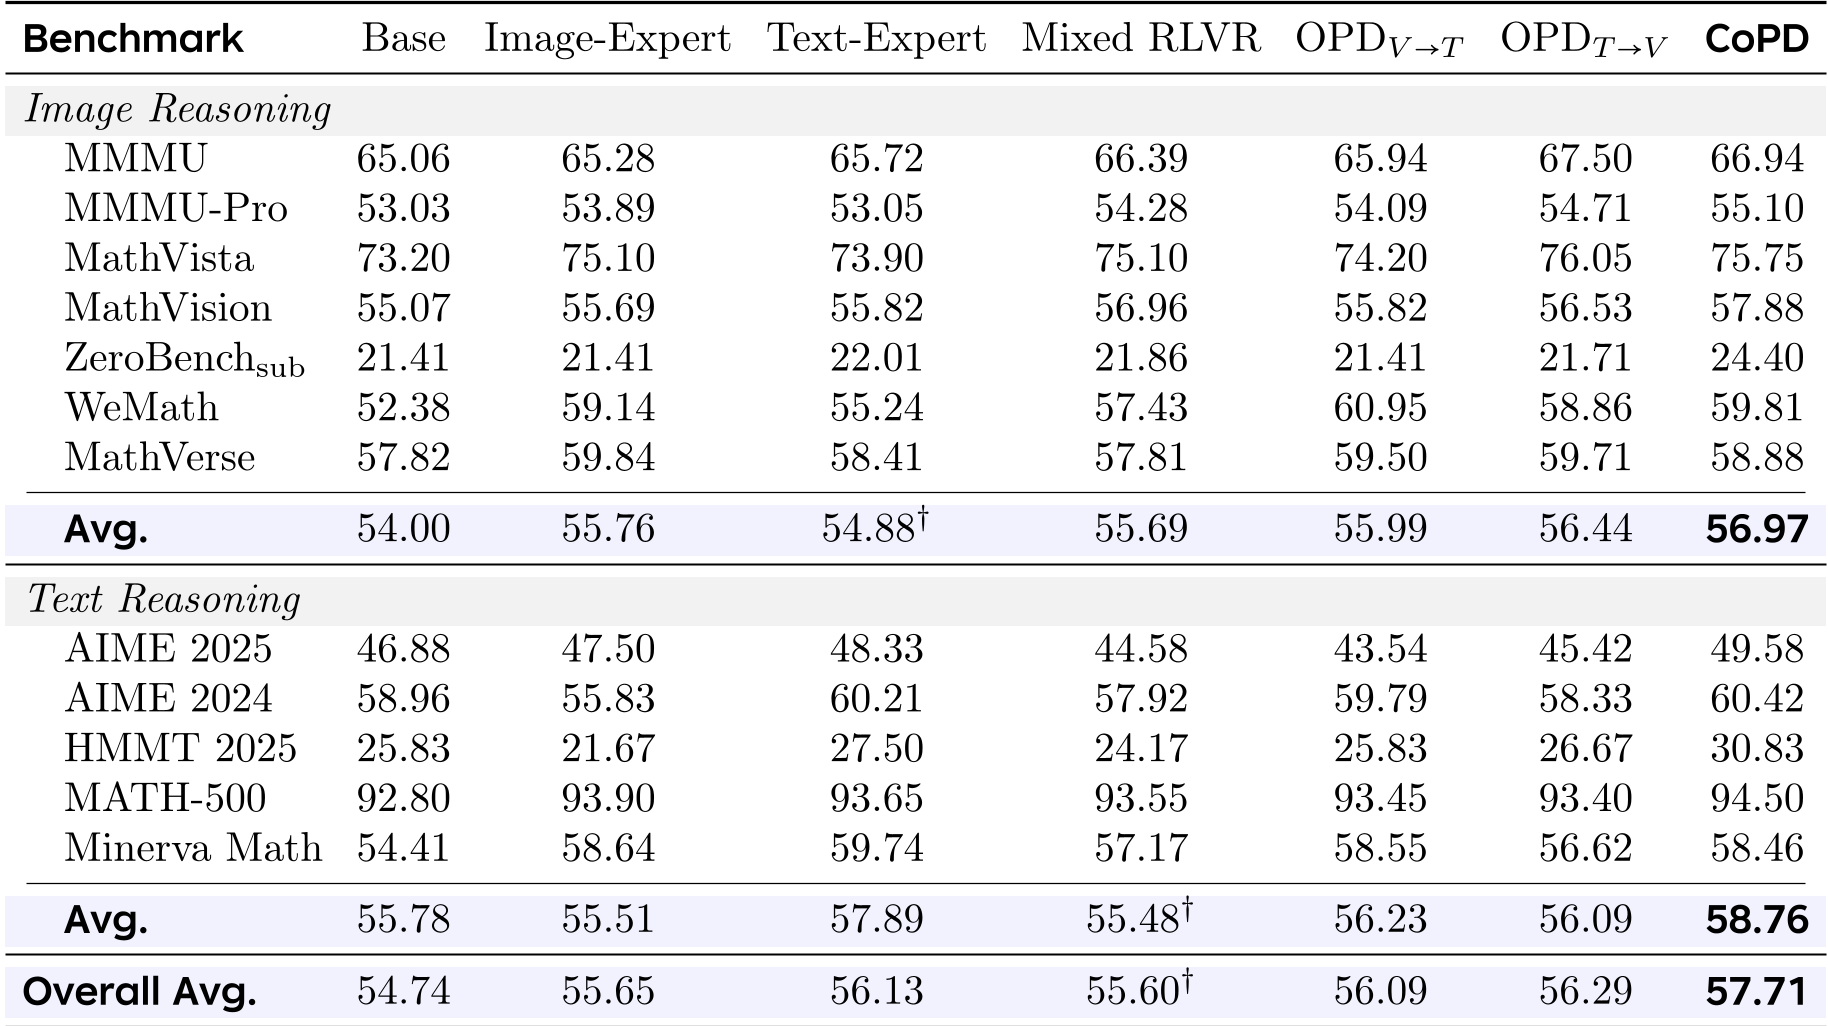 (表 1 清楚地显示,CoPD 在所有评估维度上都由于单领域专家和传统的 OPD 方案)
深度思考:为何 CoPD 有效?
从数学角度看,CoPD 实际上是在维持一个 Moderate Overlap (O_mod)。
- 如果差距太小,蒸馏信号趋于 0,学不到东西。
- 如果差距太大(如 Static OPD),KL 散度爆炸,学生无法理解老师的逻辑。 CoPD 通过 RLVR 推开距离,通过 OPD 拉近距离,始终让学习发生在“近侧发育区”(Zone of Proximal Development)。
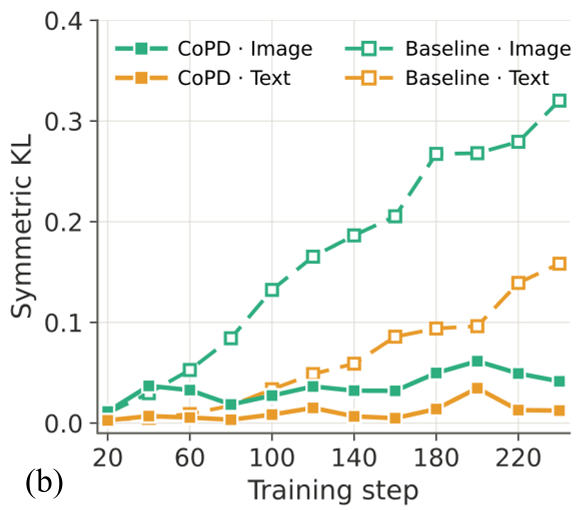 (图 4 展示了训练过程中 Top-k 重合度的波动回升,验证了共同演化的稳定性)
总结与局限
CoPD 提出了一种极具启发性的思路:模型能力的上限不应受限于数据混合的冲突,而应通过并行进化与互惠蒸馏来解锁。
然而,该方法也存在一定的算力门槛——由于需要维护多个模型并行分支,尽管最终可以合并(Merge),但训练过程中的显存压力和同步成本不容小觑。未来的研究方向或许在于如何在大规模(如 70B+ 模型)上实现更轻量化的“并行演化”。
CoPD 证明了:在 AI 的世界里,最好的老师是那些和你一起进步的同行者。