
CollideNet:解耦时空多尺度特征,刷新碰撞预测 (TTC) 的 SOTA 纪录
CollideNet: Hierarchical Multi-scale Video Representation Learning with Disentanglement for Time-To-Collision Forecasting
本文提出了 CollideNet,一种用于视频碰撞时间(TTC)预测的双流层次化多尺度 Transformer 架构。该方法通过在空间和时间维度上捕获全局与局部特征,并在时间流中解耦非平稳性、趋势和季节性组件,在 CCD、DoTA 和 DAD 三个主流数据集上刷新了 SOTA 纪录。
TL;DR
在自动驾驶领域,早 0.5 秒的预警就能避免 60% 的追尾事故。本文介绍的 CollideNet 是一种新型的双流层次化 Transformer 架构,专门为碰撞时间 (Time-To-Collision, TTC) 预测设计。它创新性地引入了时序解耦(Trend/Seasonality Disentanglement)和多尺度建模,不仅在 CCD 数据集上提升了 30% 的性能,还表现出了极强的跨场景泛化能力。
痛点深挖:为什么 TTC 预测这么难?
TTC 预测不仅是一个回归任务,它要求模型在极其复杂的动态环境下同时理解“大局”和“细节”:
- 多尺度挑战:模型既要看清近处的突发状况(局部细节),也要把握整体车流趋势(全局背景)。
- 长程依赖与计算量:标准 Transformer 的 Self-Attention 复杂度是 ,处理高帧率长视频时内存溢出是家常便饭。
- 非平稳性 (Non-stationarity):真实交通事故视频的统计特性(均值、方差)随时间剧烈波动,导致标准模型难以收敛。
核心方法论:CollideNet 的“双流”魔法
1. 空间流:从局部到全局的逐级渗透
CollideNet 并没有采用恒定分辨率的 patch 划分,而是借鉴了 mViTv2 的层次化思想。在早期阶段,模型专注于高分辨率的局部细节;随着层数加深,分辨率降低而特征维度增加,从而捕获全局语义。
2. 时间流:深度解耦与分段注意力
这是本文最惊艳的部分。作者认为视频序列可以像金融曲线一样被拆解:
- 系列解耦 (Series Decomposition):将视频嵌入拆分为趋势 (Trend) 和季节性 (Seasonality)。趋势代表相对平滑的背景流,季节性捕获前景目标的快速波动。
- 分段相关注意力 (MSSC):不再进行点对点的计算,而是将时间序列分段,计算段间相关性。这不仅把复杂度降到了线性,还增强了对局部时间结构的建模。
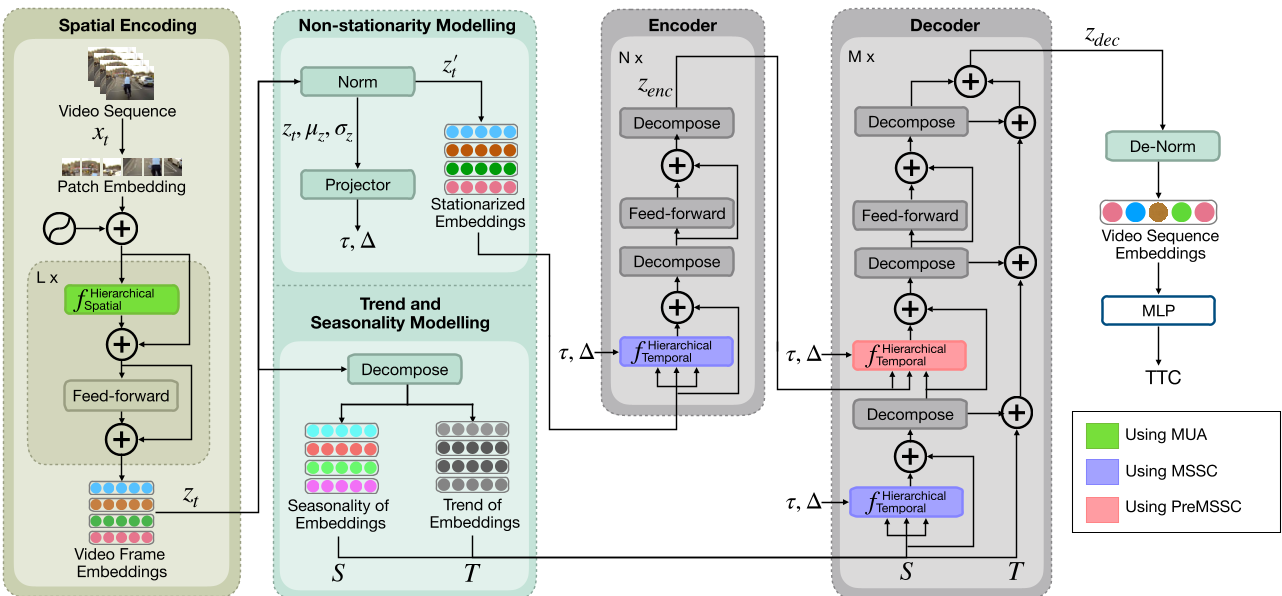 图 1:CollideNet 总体架构,展示了空间分层与时间解耦的协同工作流程。
实验战绩:全线霸榜
研究团队在 DAD、CCD 和 DoTA 三个公开数据集上进行了严苛测试。结果显示,CollideNet 在所有基准测试中均排名第一:
- 精度飞跃:在 CCD 数据集上,MSE(均方误差)从前人最好的 0.53 降到了 0.37,提升幅度达 30%。
- 高效参数量:其参数量约为 51.8M,远低于 VidNeXt (125M) 或 Video-FocalNet (156M),在性能与规模间取得了极佳平衡。
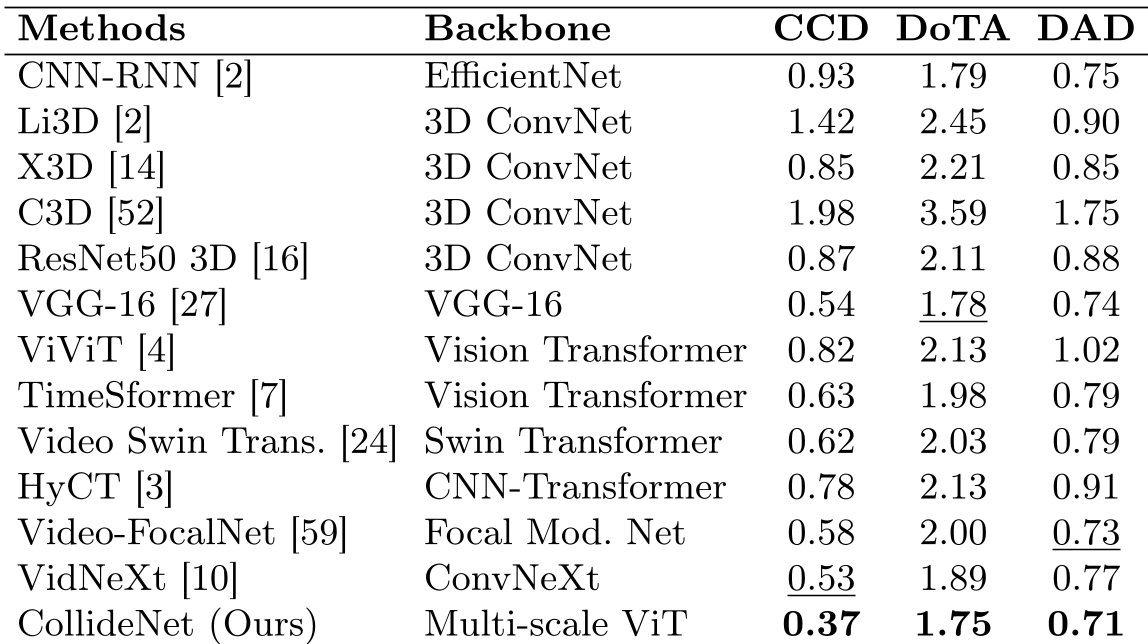 表 1:CollideNet 与各类主流模型(如 ViViT, Swin Transformer)在三大数据集上的 MSE 对比。
深度洞察:为什么“解耦”有效?
通过可视化发现(见图 A3),解耦后的趋势组件成功捕获了道路整体的运动流,而季节性组件则锚定了具体的车辆和标志。这种“分而治之”的策略降低了 Transformer 学习复杂时间分布的难度。
此外,跨数据集实验(Cross-dataset evaluation)显示,CollideNet 即使在未见过的数据集上也能保持稳定的性能,这对于实际落地到各种城市道路场景具有巨大的工程价值。
总结与展望
CollideNet 证明了:要在极端场景(如碰撞)中做精准预测,不能只靠堆叠算力,必须引入符合物理直觉的归纳偏置(Inductive Bias)。
局限性:尽管参数量有所优化,但由于涉及复杂的双流交互,其推理延迟(125.97ms)相较于轻量化 CNN(如 X3D)仍有提升空间。未来的研究可能会侧重于如何将这种解耦机制集成到更轻量级的 SSM(状态空间模型,如 Mamba)中,以实现更快的端侧响应。
关键词:TTC Forecasting, 时空建模, Hierarchical Transformer, 自动驾驶, 视频表征学习