
Colorful-Noise:无需训练,通过操纵噪声频率实现色彩与结构的深度控制
Colorful-Noise: Training-Free Low-Frequency Noise Manipulation for Color-Based Conditional Image Generation
本文提出了 Colorful-Noise,一种无需训练(Training-free)的扩散模型预测引导方法。该方法通过在初始噪声潜空间(Latent Noise)中植入低频色彩先验,实现了对生成图像全局颜色方案和结构的精确控制,已在 SDXL 和 Flux 等 SOTA 模型上验证。
TL;DR
在生成式 AI 领域,控制图像的“颜色方案”和“布局”通常意味着需要训练笨重的插件(如 ControlNet)或进行复杂的 Prompt Engineering。本文介绍了一种极简且优雅的方案:Colorful-Noise。它不改动模型参数,不增加计算耗时,只需在噪声诞生的那一刻,微调它的“频谱”,就能让 AI 乖乖听从你的色彩指令。
背景定位:噪声不仅是随机数
传统的扩散模型(Diffusion Models)将白高斯噪声视为纯粹的随机源。学术界一直认为由于这种噪声的一致功率谱密度(White Noise),它对生成结果的控制是不可预测的。
然而,Colorful-Noise 的作者发现:噪声的频率分布与最终图像的语义层次存在着惊人的映射关系。
- 低频分量 (Low-frequency):掌控全局颜色、构图和大致轮廓。
- 高频分量 (High-frequency):决定纹理、边缘和微观细节。
通过这一发现,我们可以像调音台一样,给初始噪声“上色”。
痛点深挖:为什么现有的控制方法不够香?
- 资源消耗大:像 ControlNet 这样的方法需要训练辅助网络,对于普通开发者来说成本极高。
- 模态冲突:当你试图同时指定“结构”(用 Canny 边缘图)和“色彩”(用参考图)时,不同插件往往会在注意力层互相打架,导致生成结果崩溃。
- 不可解释性:白噪声像个黑盒,虽然保证了多样性,却牺牲了控制的直观性。
Methodology:傅里叶变换的奇妙应用
Colorful-Noise 的核心流程非常直观,其公式背后隐藏着深刻的物理直觉:
- 空间转换:将参考图通过 VAE Encoder 转入潜空间(Latent Space),并进行 2D 离散傅里叶变换(DFT)。
- 频谱替换:保留参考图频谱中的低频部分(由参数 定义),将其注入到初始高斯噪声潜变量中。
- 频率重构:通过逆傅里叶变换(IDFT)回到潜空间。
为了防止由于自然图像与纯随机噪声的分布差异导致生成图崩坏,作者引入了一个缩放因子 。这个参数确保了这种注入是“润物细无声”的——它在人眼看来依然是噪声,但在模型眼里,却包含了一个清晰的色彩地图。
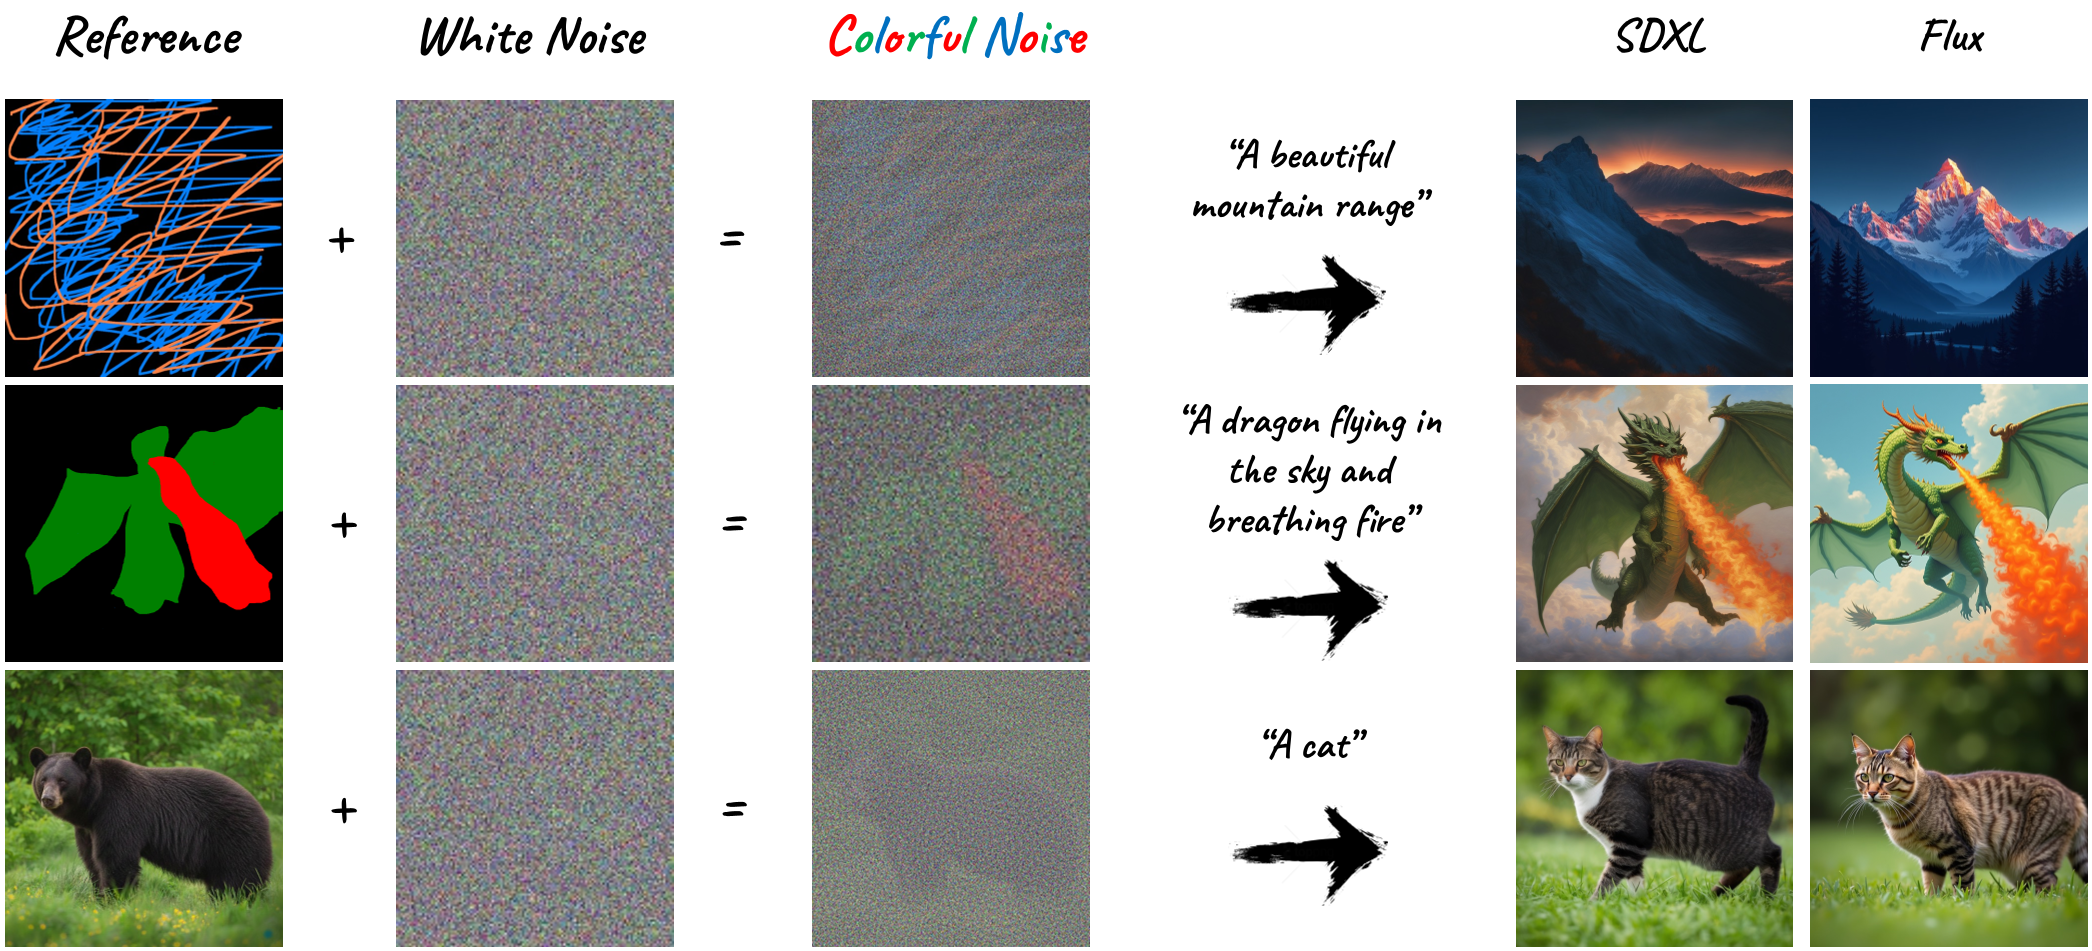 图 1:Colorful-Noise 核心直觉:通过预设低频噪声,在不改动模型的情况下控制全局色彩
实验与结果:不仅准,而且稳
作者在 SDXL 和最新流式模型 Flux-dev1.0 上进行了实验,结果令人印象深刻。
1. SOTA 对比
在色彩保持测试中,Colorful-Noise 在 Localized-EMD(局部地球移动距离)上的表现超过了以往所有 Zero-shot 方法。这意味着它生成的色彩不仅在全局上一致,且在空间布局上极为精准。
2. 完美的协同效应
由于 Colorful-Noise 作用于频率空间的最底层,它能与 ControlNet 等结构控制工具完美叠加:
- ControlNet 负责线条边缘(高频)。
- Colorful-Noise 负责色彩填充(低频)。
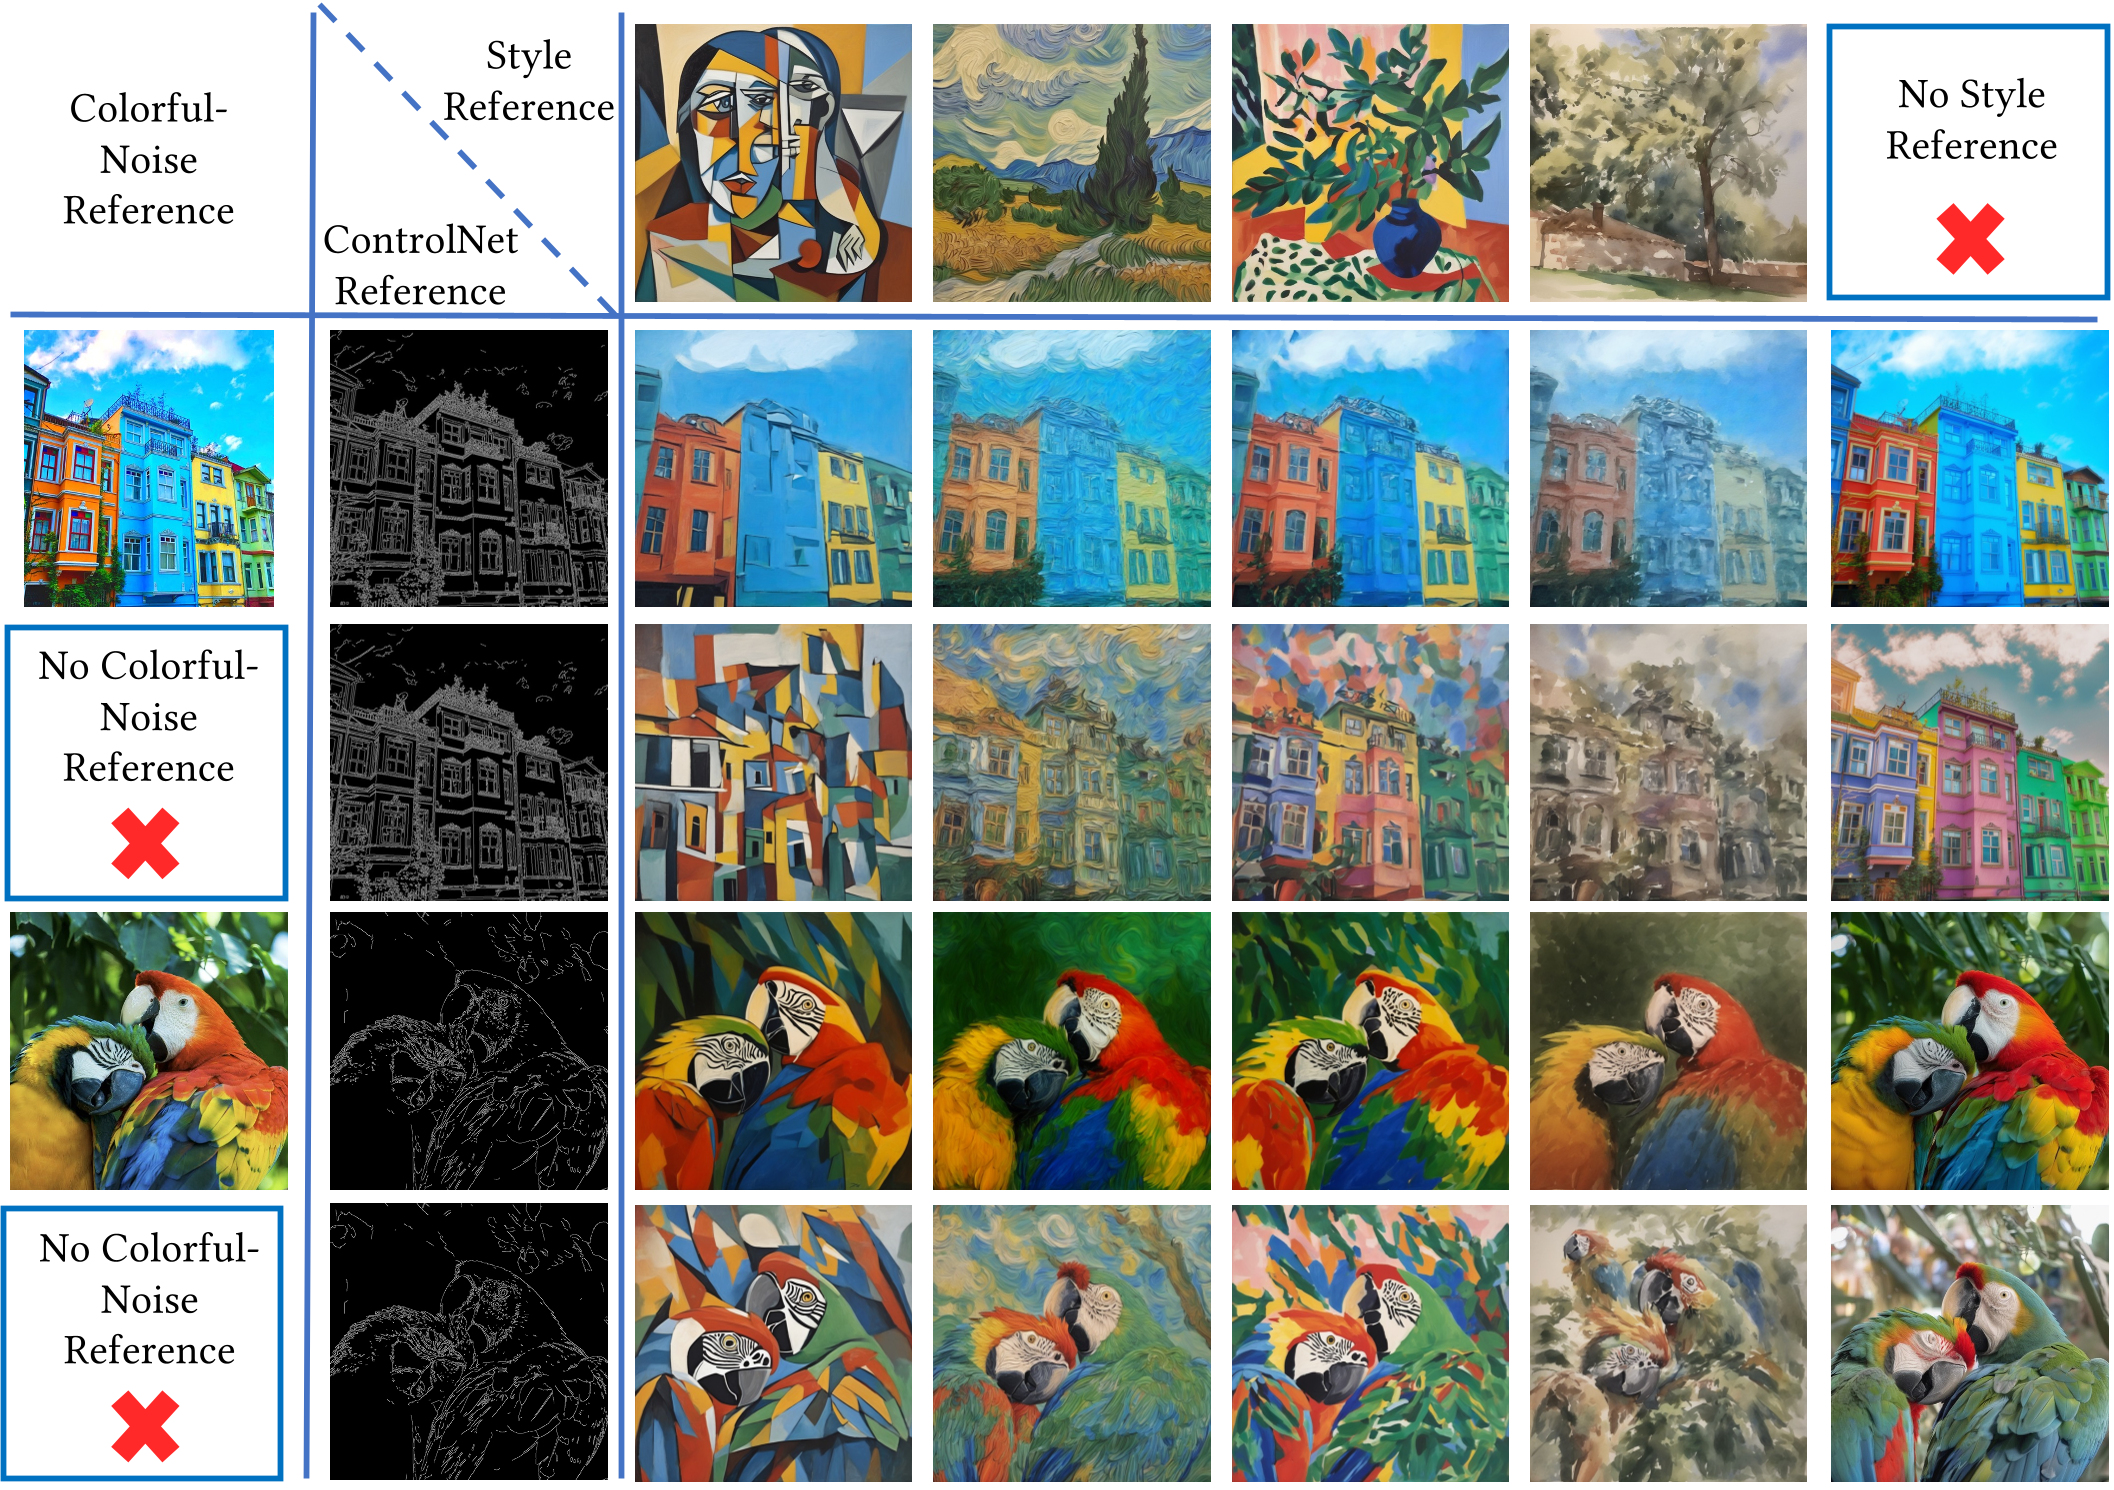 图 2:结合 ControlNet 后的表现,实现了从色彩参考到结构控制的平滑衔接
深度洞察:来自主编的分析
Colorful-Noise 最深刻的贡献在于它挑战了我们对“Inductive Bias(归纳偏置)”的理解。通常我们认为偏置应该写在模型权重里,但作者证明:数据的初始状态(噪声的频谱结构)本身就是一种极强的归纳偏置。
它的局限性也显而易见:
- 参数 和 的选择目前依赖于手动调整,缺乏自动化。
- 在超高分辨率(如 4K)下,潜空间掩码的采样可能会导致边缘控制略显粗糙。
总结与未来展望
Colorful-Noise 提供了一种“以简驭繁”的控制之道。它告诉我们,与其不断增加模型参数,不如回顾信号处理的最基本原理。
启示:未来的生成模型可能会拥有一个“频谱仪表盘”,允许用户像编辑音频均衡器一样,通过调节不同频率的噪声,直观地控制图像的多尺度属性。
本文由资深学术技术主编重构。引用:Nadav Z. Cohen, et al. SIGGRAPH 2026.