
ConsisVLA-4D:突破时空一致性,让机器人拥有高效的 3D 感知与 4D 推理能力
ConsisVLA-4D: Advancing Spatiotemporal Consistency in Efficient 3D-Perception and 4D-Reasoning for Robotic Manipulation
本文提出了 ConsisVLA-4D,一个统一且高效的视觉-语言-动作(VLA)框架,旨在提升机器人操作中的时空一致性。该方法通过 CV-Aligner、CO-Fuser 和 CS-Thinker 三大模块,在仅使用原始视觉输入 1/8 令牌的情况下,实现了卓越的 3D 感知与 4D 推理能力,显著刷新了 LIBERO 等基线的 SOTA 记录。
TL;DR
在具身智能领域,如何让机器人像人一样通过有限的视觉信息理解复杂的 3D 世界并预判未来的动态变化,一直是 Vision-Language-Action (VLA) 模型的核心痛点。ConsisVLA-4D 提出了一种创新的统一框架,通过 CV-Aligner(跨视图对齐)、CO-Fuser(跨对象融合) 和 CS-Thinker(跨场景思考) 三大模块,在大幅削减计算负担的同时,将机器人操作的成功率提升了 40% 以上,并实现了超过 2.3 倍的推理加速。
痛点深挖:为什么现有的 VLA 模型“空间感”和“预判力”不足?
尽管 OpenVLA、RT-2 等模型在 2D 映射到 Action 上取得了长足进步,但它们在复杂真实场景中由于以下两个局限性经常“翻车”:
- 空间维度(3D Perception)的短板:现有的 2D-to-3D 映射往往存在投影偏差或几何不一致。若引入点云或深度图,则对传感器和算力要求极高,难以在低功耗平台上实时运行。
- 时间维度(4D Reasoning)的匮乏:大多数模型仅预测“下一帧图像”,而不是理解“场景如何演化”。这种缺乏时空连贯性的推理,导致机器人在面对物体遮挡或动作干扰时动作极其不稳定。
方法论详解:从 3D 感知到 4D 推理的进化
ConsisVLA-4D 的核心直觉在于模拟人类视觉:我们并不记录由于视角切换带来的每一颗像素变化,而是通过特定的语义对象和几何框架来维持对世界的认知稳定性。
1. 架构解析
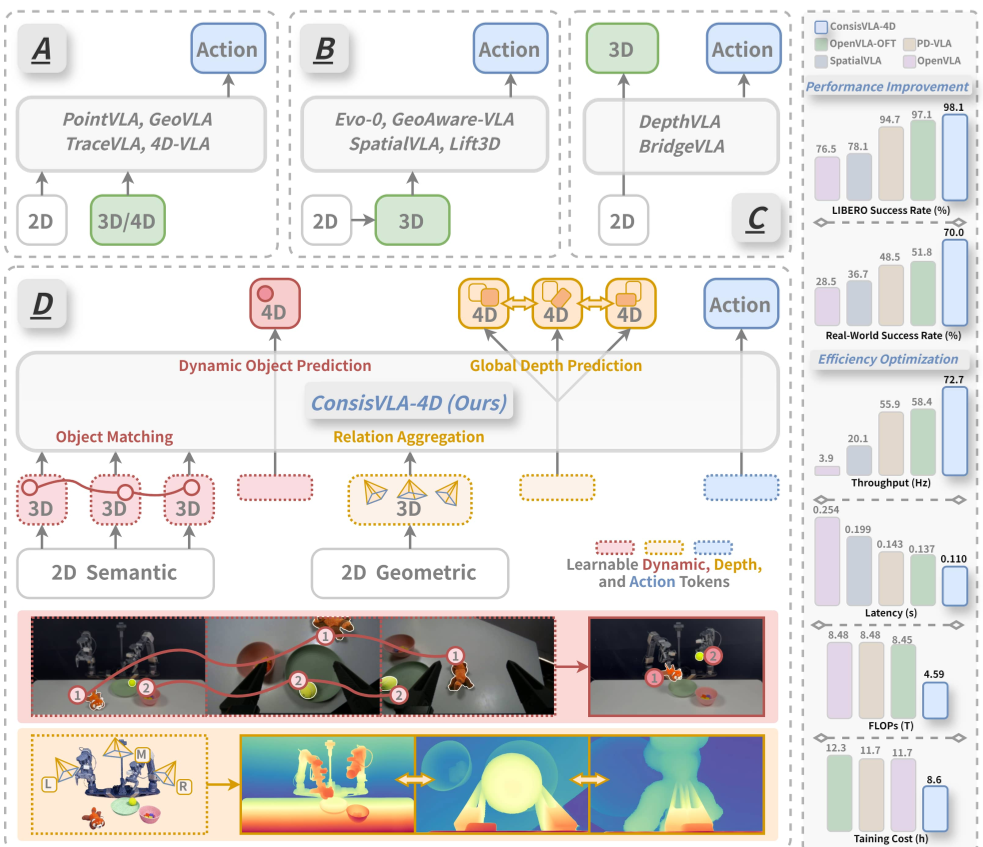
- CV-Aligner (跨视图对象语义一致性): 该模块利用 SigLIP 提取语义,通过 Explicit Semantic Object Selection (ES-Selection),仅保留与指令最相关的 Top-K(例如 32 个)物体令牌。这种“去粗取精”的做法将原本数以百计的 Token 压缩到 1/8,同时利用 Single-Fusion 确保了同一物体在主视角和侧视角中的身份一致性。
- CO-Fuser (跨对象空间几何一致性): 为了消除单视角下的深度歧义,作者引入 Group-Fusion,将 DINOv2 的几何特征与专门的 3D 模型 VGGT 进行融合。通过一种余弦退火权重的自适应机制,模型在底层学习基础几何,在高层学习复杂空间关系,显著增强了空间定位的准确度。
- CS-Thinker (跨场景时空一致性): 这是 4D 推理的灵魂。它并不在推理阶段渲染出未来的图片,而是在训练阶段通过 SC-Attn(时空一致性注意力) 学习未来动态物体和全局深度的“隐式知识”。这意味着在推理时,模型已经通过这些 Token 自动“脑补”了动作产生后的物理变化。
实验与结果:算力减负,性能倍增
在 LIBERO 仿真环境及真实的 Galaxea R1 Lite 机器人平台上,ConsisVLA-4D 展现了统治级的表现。
核心战绩:
- 卓越性能:在 LIBERO 的 Spatial 和 Object 测试集中,成功率分别达到惊人的 98.8% 和 99.8%。
- 推理效率:相比 OpenVLA,其 FLOPs 从 8.48T 降至 4.59T。在真实世界任务(双臂协同操作)中,吞吐量高达 108.2 Hz,远超同类 7B 参数规模的模型。
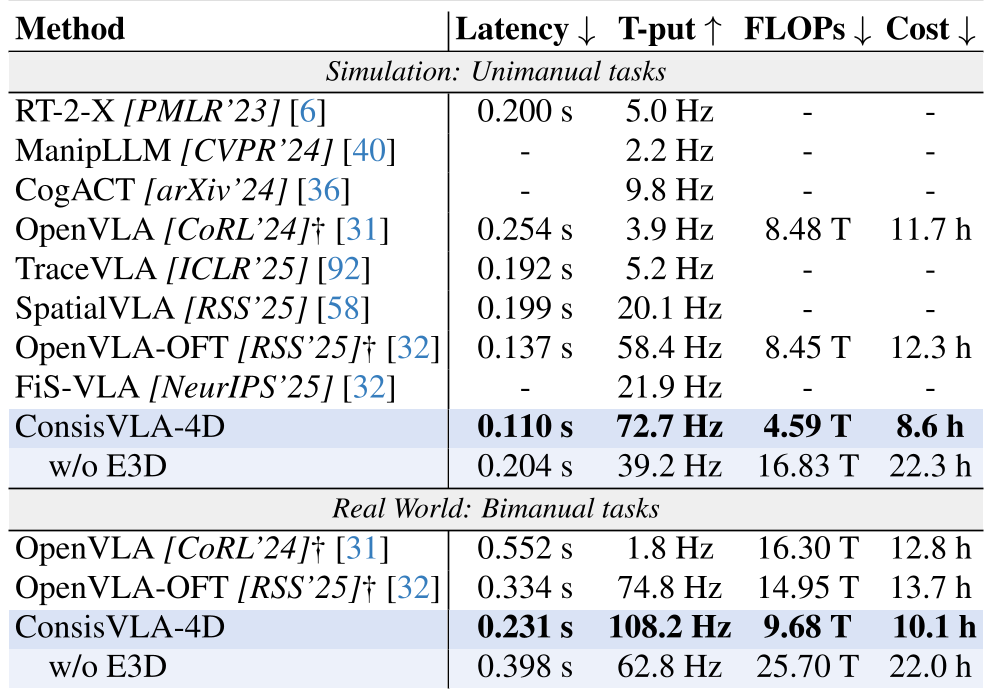
消融实验揭秘:
实验显示,一旦移除 ES-Selection(语义选择),成功率会下降约 7-10%。这证明了“冗余信息”不仅浪费算力,甚至会干扰模型对重点物体的关注。而 CS-Thinker 的引入则为长程任务提供了稳定性支撑,特别是在“剥香蕉”和“叠衣服”这类对精度和动态反馈要求极高的任务中效果拔群。
深度洞察与总结
Takeaway: ConsisVLA-4D 告别了“大力出奇迹”的冗余计算路线,转而通过精致的稀疏语义对齐和隐式时空建模,完美平衡了算法精度与实时性。
局限性与未来展望: 尽管该方法极大地优化了效率,但其目前的语义过滤机制仍依赖于 Top-K 硬性选择,未来若能实现动态弹性 Token 预算,可能会在更极端复杂的场景(如杂乱的小零件抓取)中展现更强的鲁棒性。
结语:ConsisVLA-4D 为具身智能研究提供了一个极其高效且具备极强跨平台(Sim-to-Real)迁移能力的范式,是迈向通用机器人操作的重要一步。