
[ArXiv 2025] CBRL:借力 Few-shot 引导,打破强化学习的“探索瓶颈”
Context Bootstrapped Reinforcement Learning
本文提出了上下文引导强化学习 (Context Bootstrapped Reinforcement Learning, CBRL),旨在解决强化学习从可验证奖励 (RLVR) 中学习时的训练效率低下问题。通过在训练初期随机插入少样本 (Few-shot) 演示并随进度逐渐衰减至零,CBRL 在多个模型(Qwen, Llama)及复杂推理与编程任务(Q 语言)上实现了显著的 SOTA 性能提升。
TL;DR
强化学习训练(尤其是 RLVR 范式)常因“奖励稀疏”陷入僵局:如果模型在一开始跳不出错误答案的怪圈,就永远得不到正向反馈。本文提出的 Context Bootstrapped Reinforcement Learning (CBRL) 巧妙地将 Few-shot Prompting 作为训练早期的“助推器”。通过随训练进度逐渐撤去的上下文示例,CBRL 成功让模型在不增加推理成本的前提下,学会了极其复杂的逻辑推理和陌生的编程语言(Q 语言)。
背景定位:该工作是针对当前流行的“DeepSeek-R1 风格”强化学习方案的重要效率优化,属于利用提示工程(Prompt Engineering)辅助模型后训练(Post-training)的创新路径。
1. 痛点:RL 训练中的“探索黑洞”
在 Reinforcement Learning from Verifiable Rewards (RLVR) 框架下,模型表现好坏全看能否拿到最终的 Binary Reward(对或错)。然而:
- 探索效率低下 (Exploration Inefficiency):如果模型对某个领域(如一种冷门的编程语言)完全陌生,它生成的所有 Rollouts 可能都是错的。
- 信号缺失:当一个 Batch 里的结果全军覆没时,算法(如 GRPO)无法计算优势函数,模型就像在黑夜中摸索,根本不知道该往哪改。
以往的解决方法通常是先做大规模推理数据的微调 (SFT),但高质量推理数据昂贵且稀少。
2. 核心机制:CBRL 的“脚手架”艺术
CBRL 的核心直觉在于:既然模型具备 In-Context Learning (ICL) 的潜能,为什么不让它在训练时“看着答案学”,但在考试(推理)阶段脱离参考书?
模块拆解:
- 示例库 (Example Bank):预先准备一小盘(20-50个)高质量的题目-思维链-答案三元组。
- 随机注入 (Stochastic Injection):在训练的每一个 Step,以概率 随机决定:是给模型一个带示例的 Prompt,还是干干净净的原始 Prompt。
- 线性退火计划 (Curriculum Schedule):
- 初期:。一半的训练数据带有示例,手把手教模型怎么思考。
- 后期:。随着迭代进行,示例出现的频率越来越低,直到完全消失。
 图注:CBRL 流程图。左侧展示了从高比例注入到零注入的退火过程;右侧对比了带示例与不带示例的 Prompt 结构。
3. 实验战绩:不仅仅是“刷榜”
作者在 Reasoning Gym(逻辑、矩阵、数学谜题)和 Q Programming Language(一种特殊的金融领域编程语言)上进行了验证。
关键发现:
- 全线飘红的性能提升:在 Qwen 和 Llama 两个模型家族上,CBRL 相比纯 GRPO 算法在所有 10 组对比中均取得显著提升。
- Q 语言的突破:Q 语言具有奇怪的右向左求值逻辑,预训练模型几乎不会。纯 GRPO 训练几乎无法起步(Pass@1 仅 5%),而 CBRL 瞬间将其提升至 26.3%。
- 算法无关性:CBRL 不仅支持 GRPO,在 RLOO(一种改进的 REINFORCE)上也表现优异,Word Sorting 任务准确率从 20% 冲向了 67%。
 表 1:CBRL 在 Reasoning Gym 各项任务中的胜率对比,可见各维度均有大幅增长。
4. 深度洞察:它是如何生效的?
通过观察 训练奖赏曲线 (Training Curves),我们可以清晰地看到 CBRL 的魔力:
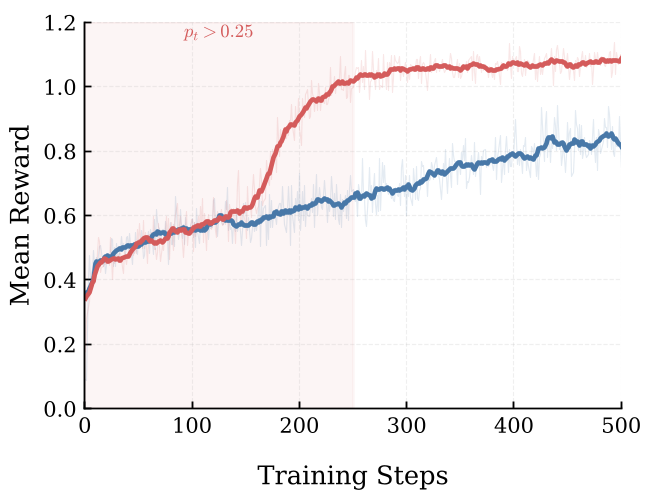 图注:灰色阴影区为高概率注入阶段。CBRL(橙线)在初期就迅速获得了极高的奖励信号值,远超 Baseline(蓝线)。
值得关注的细节:
- 能力的内化而非依赖:当灰色阴影结束,注入概率 归零后,橙色曲线并没有崩盘。这证明模型真正掌握了 Few-shot 中展示的 ASCII 计算、步骤拆解 等底层逻辑。
- 注入概率的“金发姑娘原则”:概率设为 1.0(全量注入)反而不如 0.5。研究发现,如果一直给提示,模型会产生“路径依赖”,懒于独立思考,导致泛化性变差。
5. 局限性与未来
虽然 CBRL 效果卓著,但仍有优化的空间:
- 任务自适应性:目前在 ARC-1D 等某些任务上效果略有波动,这可能与 Few-shot 示例的选择偏置有关。
- 动态退火:目前是线性退火,未来或许可以根据模型实时的 Reward 表现动态调整“扶持”力度。
总结
CBRL 再次向我们证明:Prompting 不只是推理时的技巧,更是训练时的强力催化剂。这种“先扶后放”的策略,为训练下一代垂直领域(如科研、编程、法律)的深度推理模型(LRM)提供了一种低成本、高效率的新范式。