
[Stanford PhD Thesis] 持续自我改进的 AI:超越人类数据与算法的天花板
Continually self-improving AI
本文是来自斯坦福大学的杨子彤(Zitong Yang)的博士论文,系统性地提出了“持续自我改进 AI”(Continually Self-Improving AI)的理论框架。通过合成数据增强、预训练能力自举以及基于测试时搜索的算法发现,实现了模型在知识获取、基础能力提升和算法优化三个维度的闭环自我进化。
核心速览 (Executive Summary)
TL;DR:斯坦福大学的杨子彤博士在其论文中定义并实现了“持续自我改进 AI”的三大支柱。他通过 EntiGraph 让模型能从几本书的极小语料中吸纳知识,通过 SBP 证明了即使没有外部更强的模型,AI 也能通过挖掘数据关联实现自我预训练的突破,并利用执行引导的搜索让 AI 像人类研究员一样自主发现更好的训练算法。
背景定位:该工作是自我改进 AI 领域的集大成之作,从根本上回答了“当高质量人类数据用完后,AI 还能否变强”的世纪难题。它不仅是具体能力的 SOTA 刷新,更是在方法论层面完成了从“人工干预”到“自主进化”的坐标转换。
1. 痛点:被“喂养”的 AI 终有尽头
目前的 AI 模型虽然强大,但依然被人类创作者的三道枷锁紧紧锁住:
- 知识的“反向咒语” (Reversal Curse):直接在小语料上 Finetuning 效率极低,模型往往只会死记硬背而无法泛化。
- 数据的枯竭:互联网的高质量数据是有限的,按照目前的训练速度,人类在几年内就会面临无文字可用的窘境。
- 算法的瓶颈:现有的 Transformer、Adam 优化器或是各种超参,都是人类专家在极小的实验范围内“手工试错”的结果。
作者给出的 Insight 很直接:AI 需要从单纯的“消费者”转变为“生产者”和“研究者”。
2. 机制一:EntiGraph——把知识揉碎了再重组
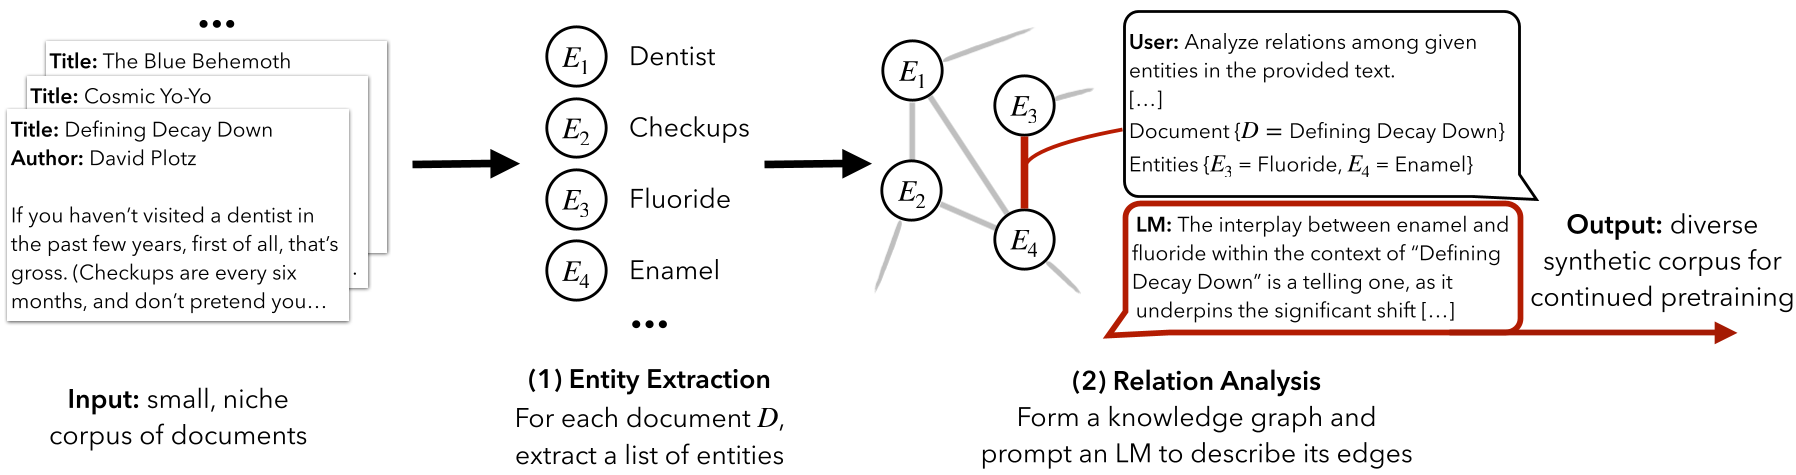
作者认为,由于小语料(如 1.3M Tokens)分布太窄,模型无法泛化。EntiGraph 的核心直觉是:知识是由实体及其关系构成的。
- 实体提取:从源文档提取核心概念(如:线性空间、向量)。
- 关系分析:强迫模型去讨论这些实体的组合关系(Pairs & Triplets)。 这种方式将有限的源文本扩增为多样化的合成语料库,让模型在持续预训练中通过“侧面描写”彻底内化知识。
3. 机制二:SBP——挖掘文档间的“隐秘联系”
如果禁止“蒸馏”高性能教师模型,AI 还能进步吗?答案是肯定的。作者提出了 SBP (Synthetic Bootstrapped Pretraining)。
- 核心逻辑:预训练不仅仅是预测下一个 Token,更有文档间的结构相似性。比如一篇 Transformer 论文和它对应的 PyTorch 代码。
- 自举过程:在数据集中找到相似文档对,训练一个“条件合成器”,然后用这个合成器去大规模生成新的文档。
- 物理直觉:合成器在生成过程中隐式地学习了数据的“隐变量”(Latent Concepts),从而实现了某种程度的“自我蒸馏”。
4. 机制三:AI 设计 AI——测试时算法搜索
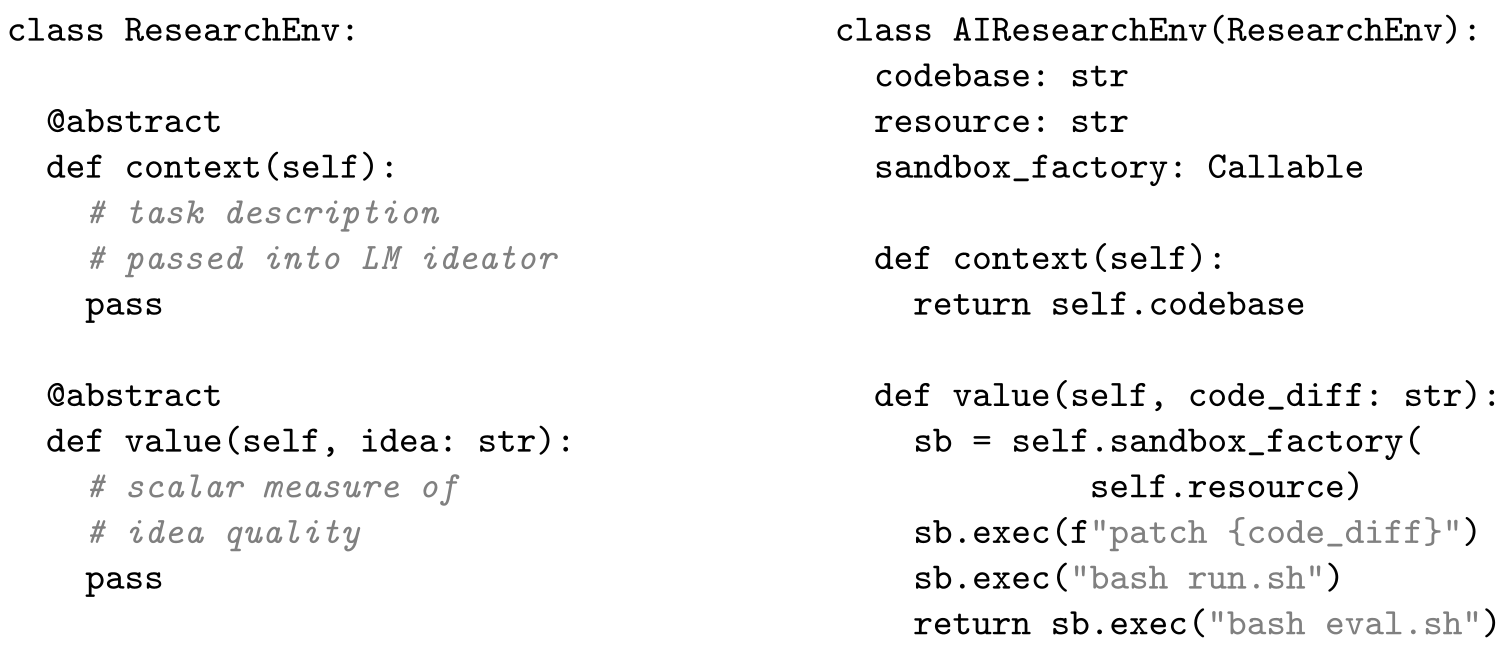
当 AI 具备了理解和编写代码的能力,它就可以充当一名“研究员”。作者构建了一个全自动实验平台:
- Implementer:将自然语言的想法转化为代码 Diff。
- Scheduler & Worker:在 GPU 集群上自动运行并汇报结果。
- 进化搜索:利用执行结果作为反馈(Reward),不断迭代算法构思。
作者发现,模型不仅能调超参,还能提出类似“因果上下文压缩”等最近才出现在学术论文中的前沿算法雏形。
5. 实验结果:以量补质的胜利
- 规模化效应:EntiGraph 的 QA 准确率随合成 Token 数呈 log-linear 增长,在 455M 规模下,其表现达到了 RAG(检索增强生成)性能的 80% 以上,且完全不需要推理时外挂数据库。
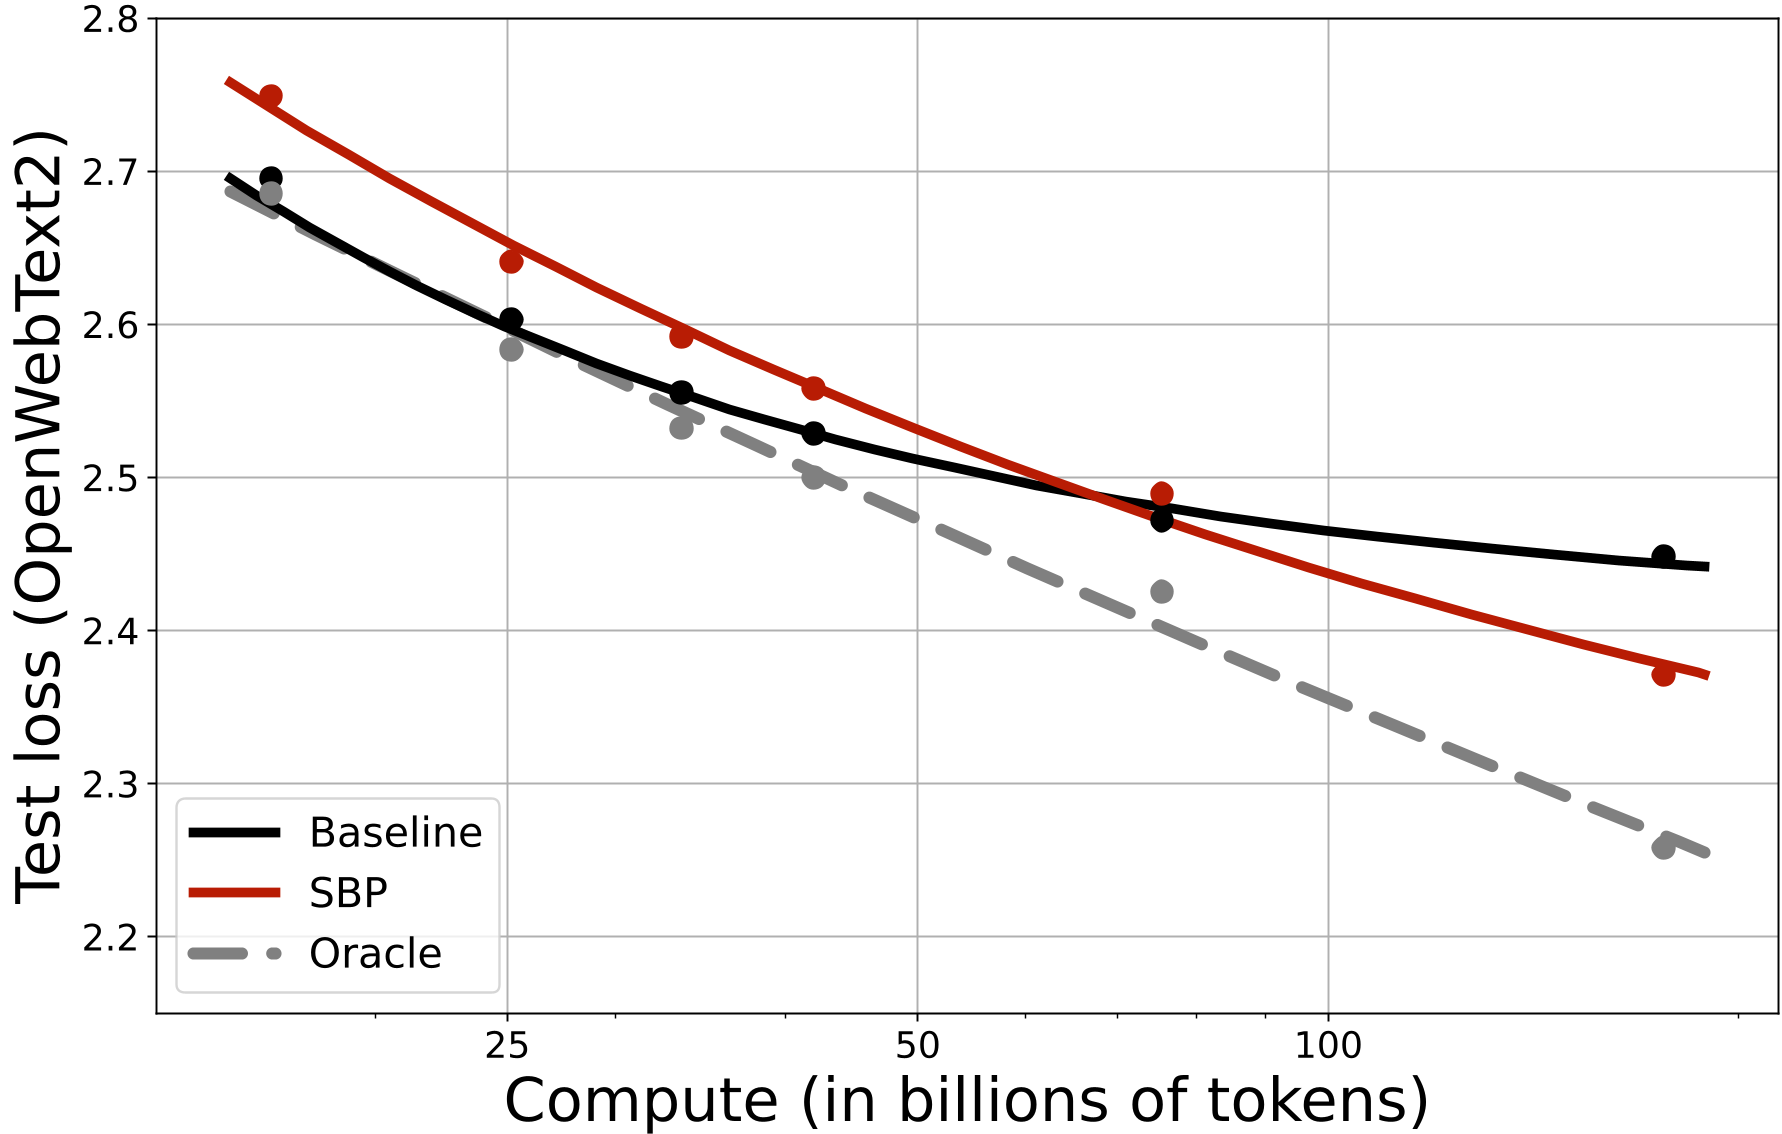
- SBP 的威力:在 1T Tokens 级别的 6B 模型训练中,SBP 能够追回约 58% 与“无限数据上限”之间的差距。
- 极简推理模型 s1-32B:仅用 1,000 条高质量样本进行微调,模型在 AIME24 上的表现就足以比肩 OpenAI o1-preview,再次证明预训练才是真正承载能力的地基。
6. 深度洞察与总结
学术价值总结: 本文完成了从“模型学会单一知识”到“系统学会如何变强”的思维跨越。最深刻的启示在于:AI 能够通过其无限的产出能力(合成数据、大规模代码试错)来克服单次学习质量的不足。
局限性 (Limitations):
- 泛化验证:在极小语料上搜出来的优化策略,是否一定能迁移到超大规模(如 100T)训练中?
- 幻觉传染:合成数据中的潜在幻觉虽然通过接地(Grounding)降低了,但在多次迭代自举中是否存在“模型崩塌”的风险?
未来展望 (Future Work): 作者预言,未来的研究员将从“写算法的人”变成“设计任务框架的人”(Harness Engineering)。正如 Einstein 的场方程比 Einstein 本人更早预言了宇宙膨胀,一个结构设计优良的 AI 系统,终将产出其创造者都无法理解的深刻真理。